我做了一个软著 Skill,可以一键生成申请材料

作者:IvanCodes日期:2026/8/19

Hello,大家好,我是Ivan。

大家做完一个项目以后,可能会遇到一个问题,需要申请软著。这时候,申请表、操作手册和代码材料就都需要重新整理一遍,很麻烦,浪费时间。

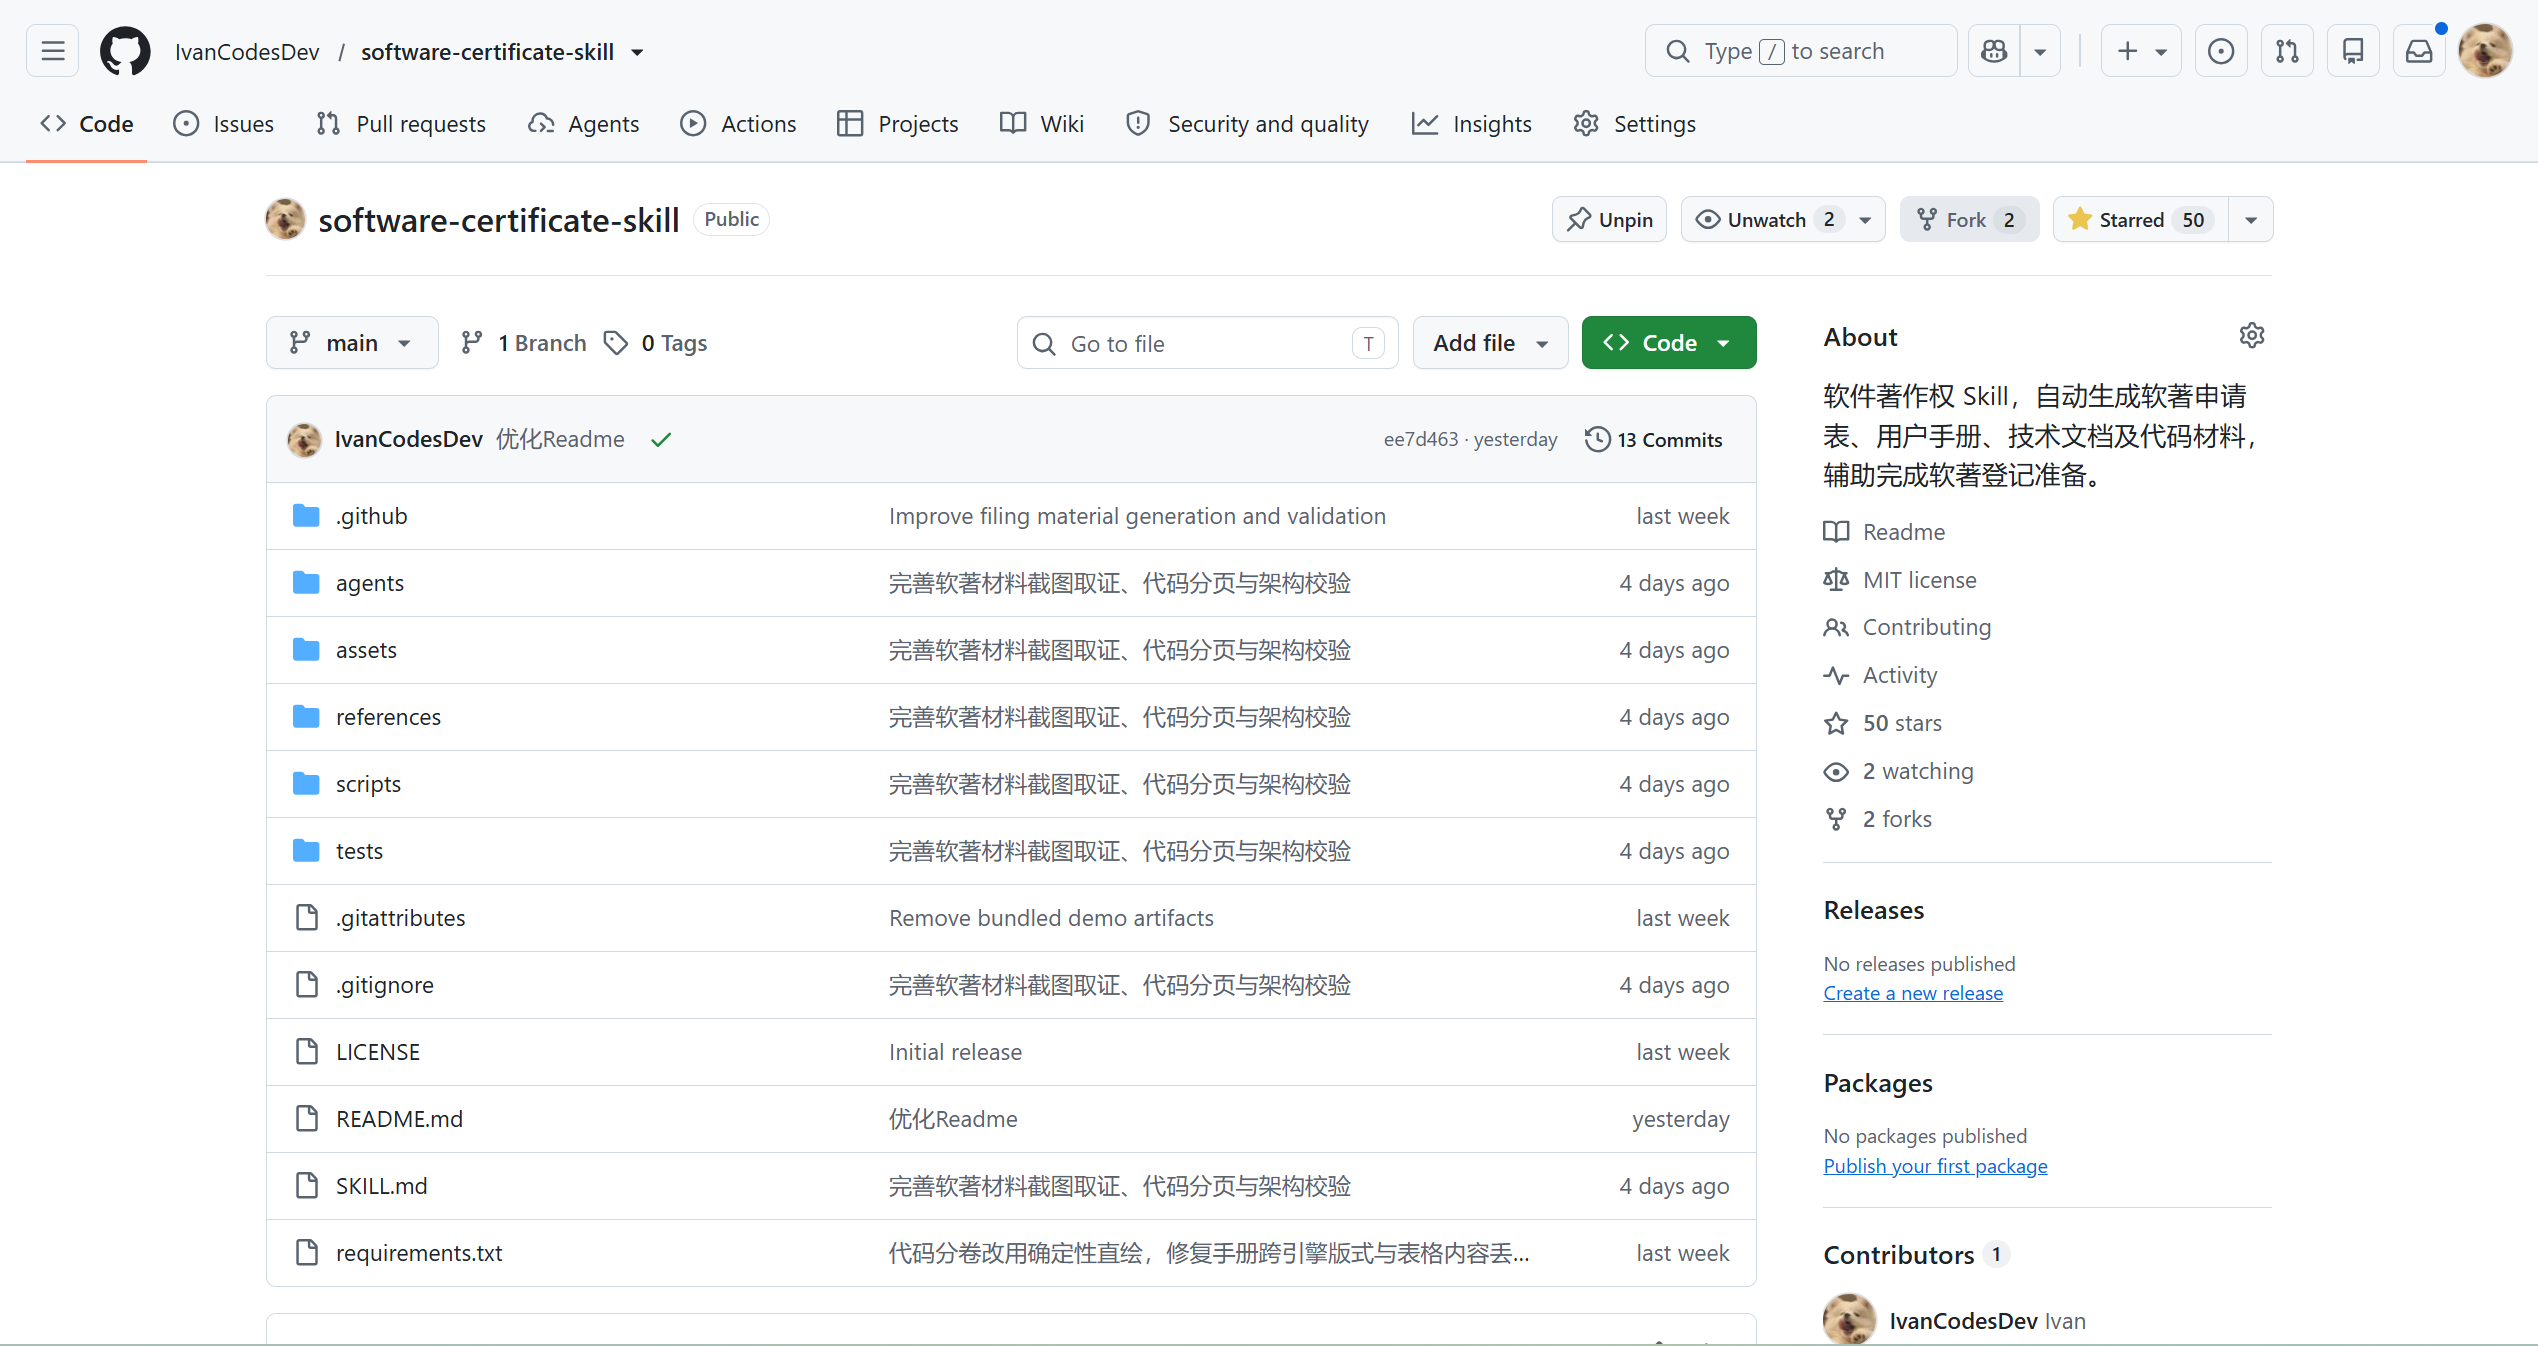
所以,我把这部分做成了一个软著 Skill,名字叫 software-certificate-skill。把项目交给它以后,它会读取项目里的代码、页面和接口,然后生成申请表信息、操作手册和代码材料。

skill已经开源了,github链接是 https://github.com/IvanCodesDev/software-certificate-skill
一、安装

先把项目克隆到本地:

1git clone https://github.com/IvanCodesDev/software-certificate-skill.git
2cd software-certificate-skill
3

然后运行安装脚本:

1python scripts/install_agent_skill.py --platform all --scope project --project E:\path\to\project --force
2

这个脚本支持 Codex、Claude Code、Cursor、OpenCode、WorkBuddy、QoderWork 和 TraeWork。想先查看安装位置,可以使用 --dry-run

1python scripts/install_agent_skill.py --platform all --scope project --project E:\path\to\project --dry-run
2

再安装项目依赖:

1python -m pip install -r requirements.txt
2

如果需要给 Web 项目自动截图,还要安装 Playwright 和 Chromium:

1python -m pip install "playwright>=1.49,<2"
2python -m playwright install chromium
3

二、在 Codex 中使用

安装完成以后,你可以直接在目标项目中输入(当然我自己就指定一下位置):

1为当前项目生成软件著作权申请资料
2
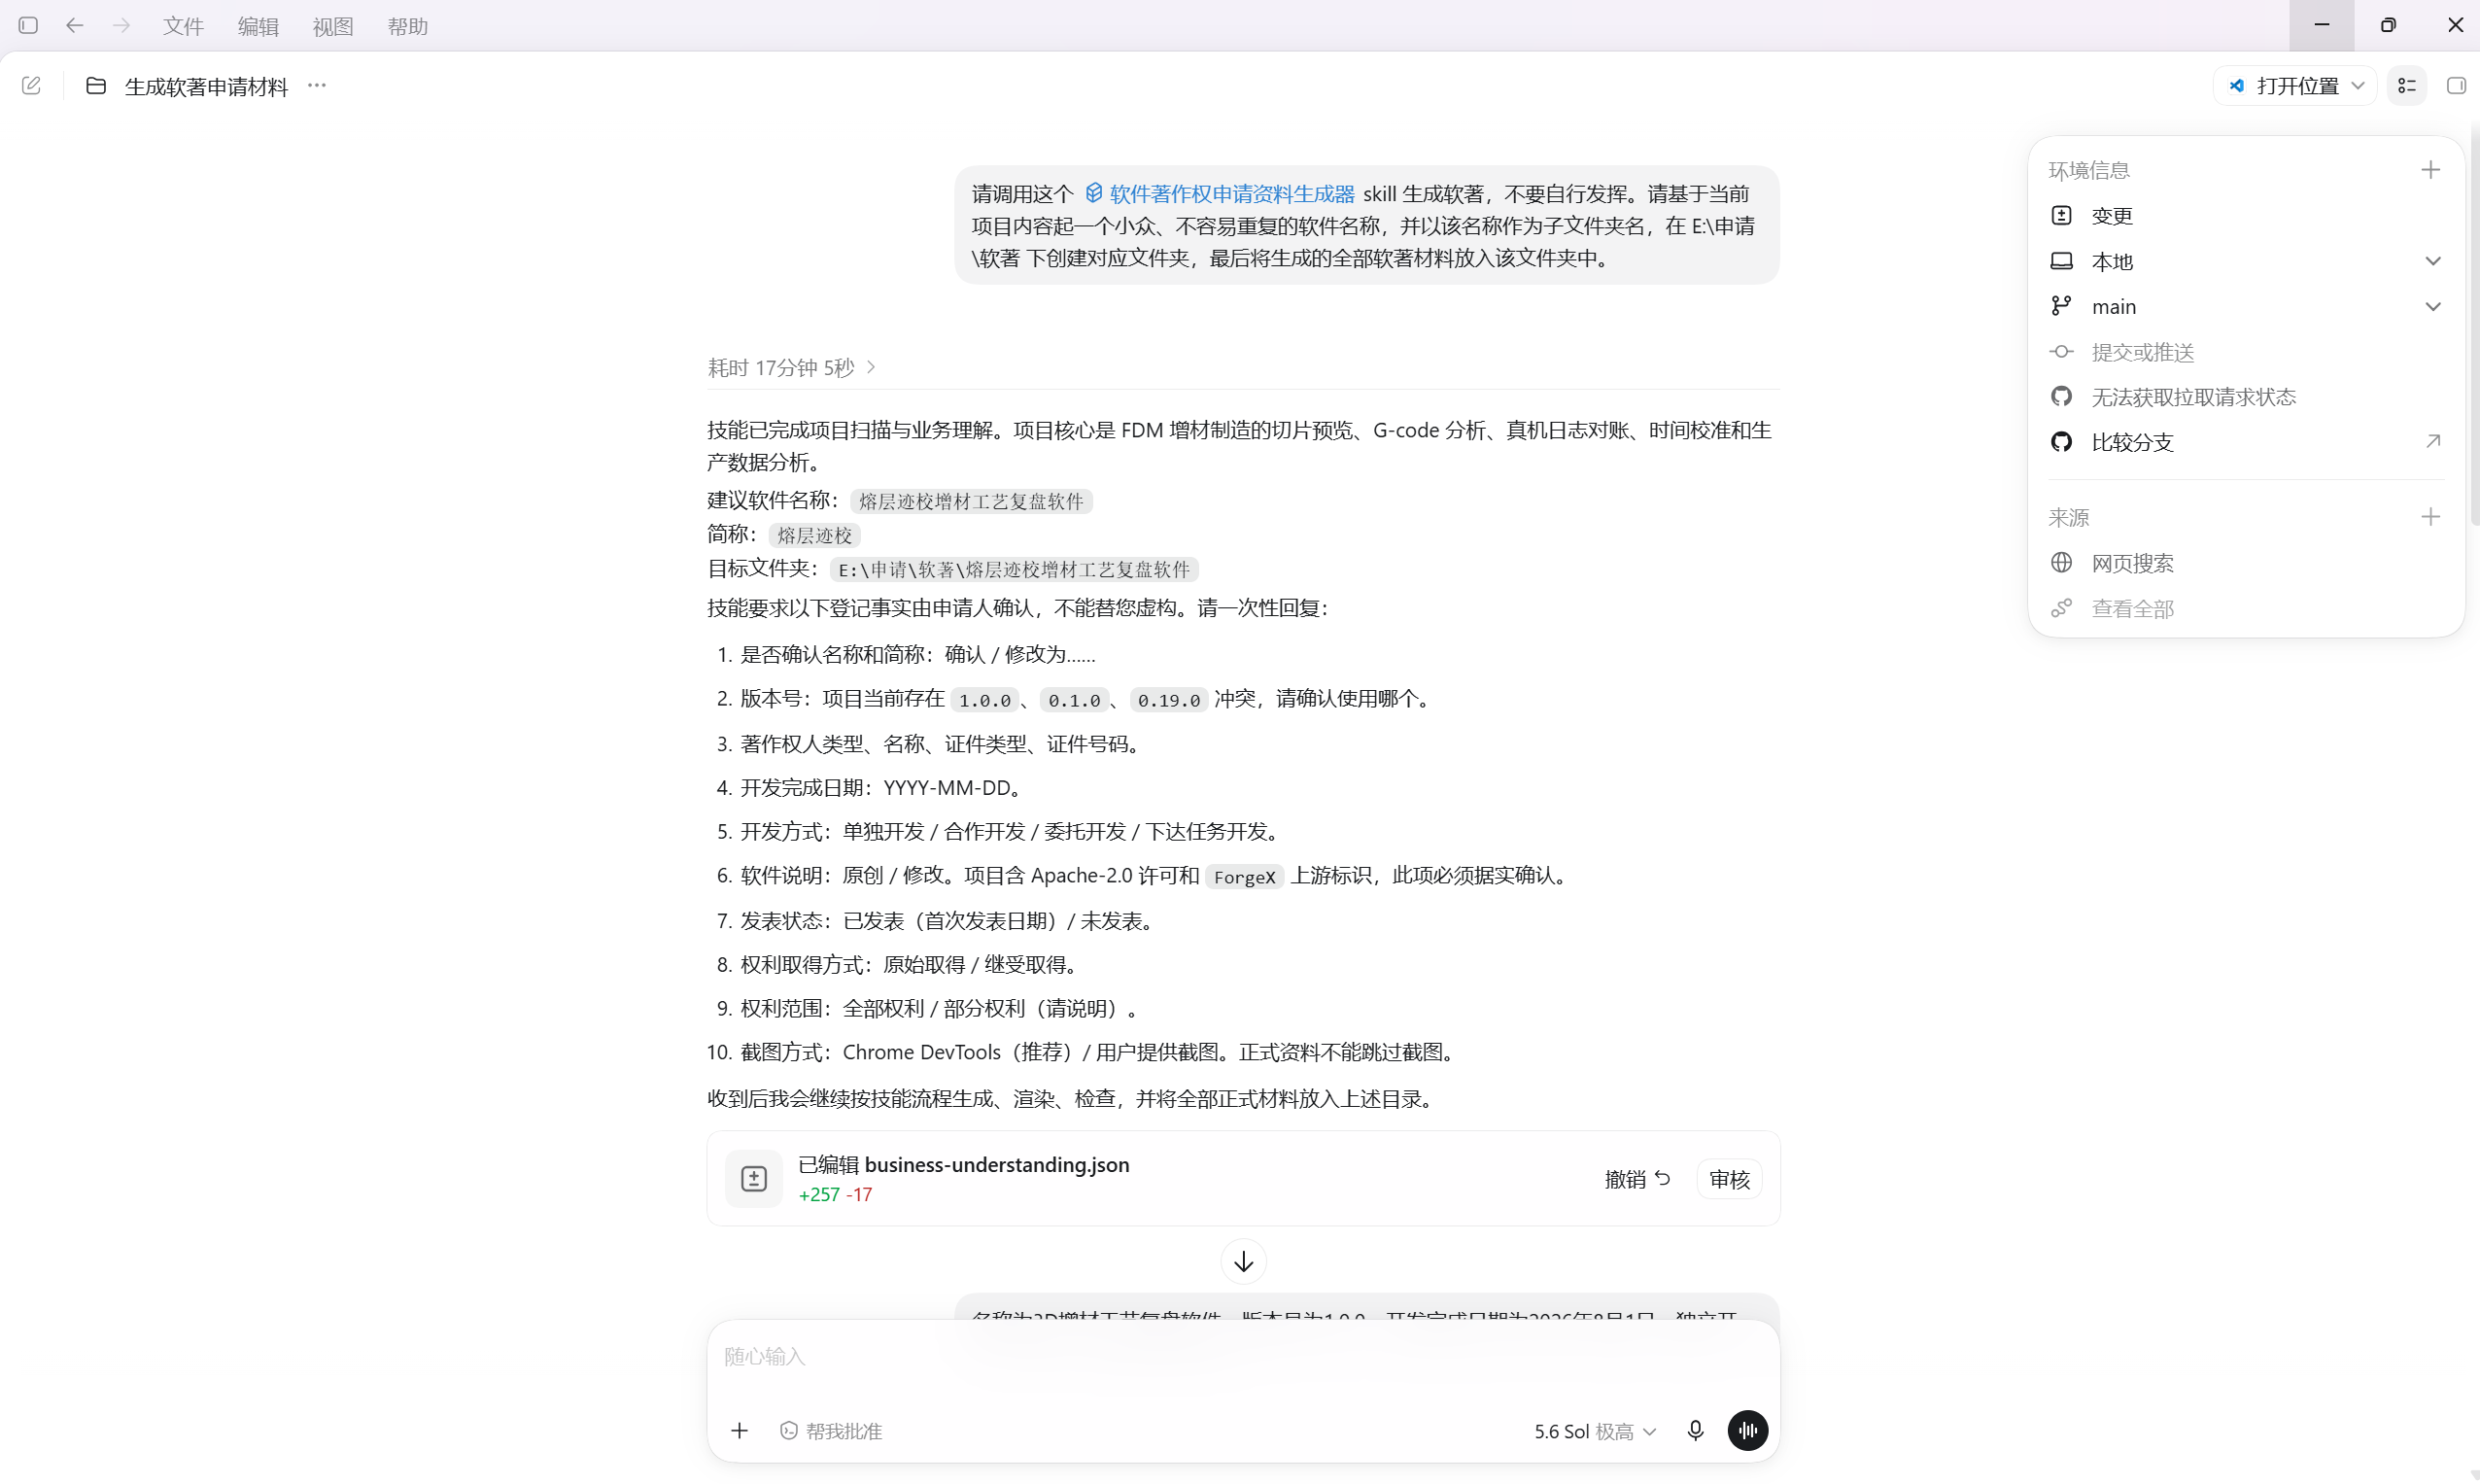
这时候你的Agent 会先读取当前项目,然后集中确认一次软件名称、版本、著作权人、完成日期和发表状态等信息。这些内容不能只根据代码来判断,所以仍然需要自己填写或者确认。
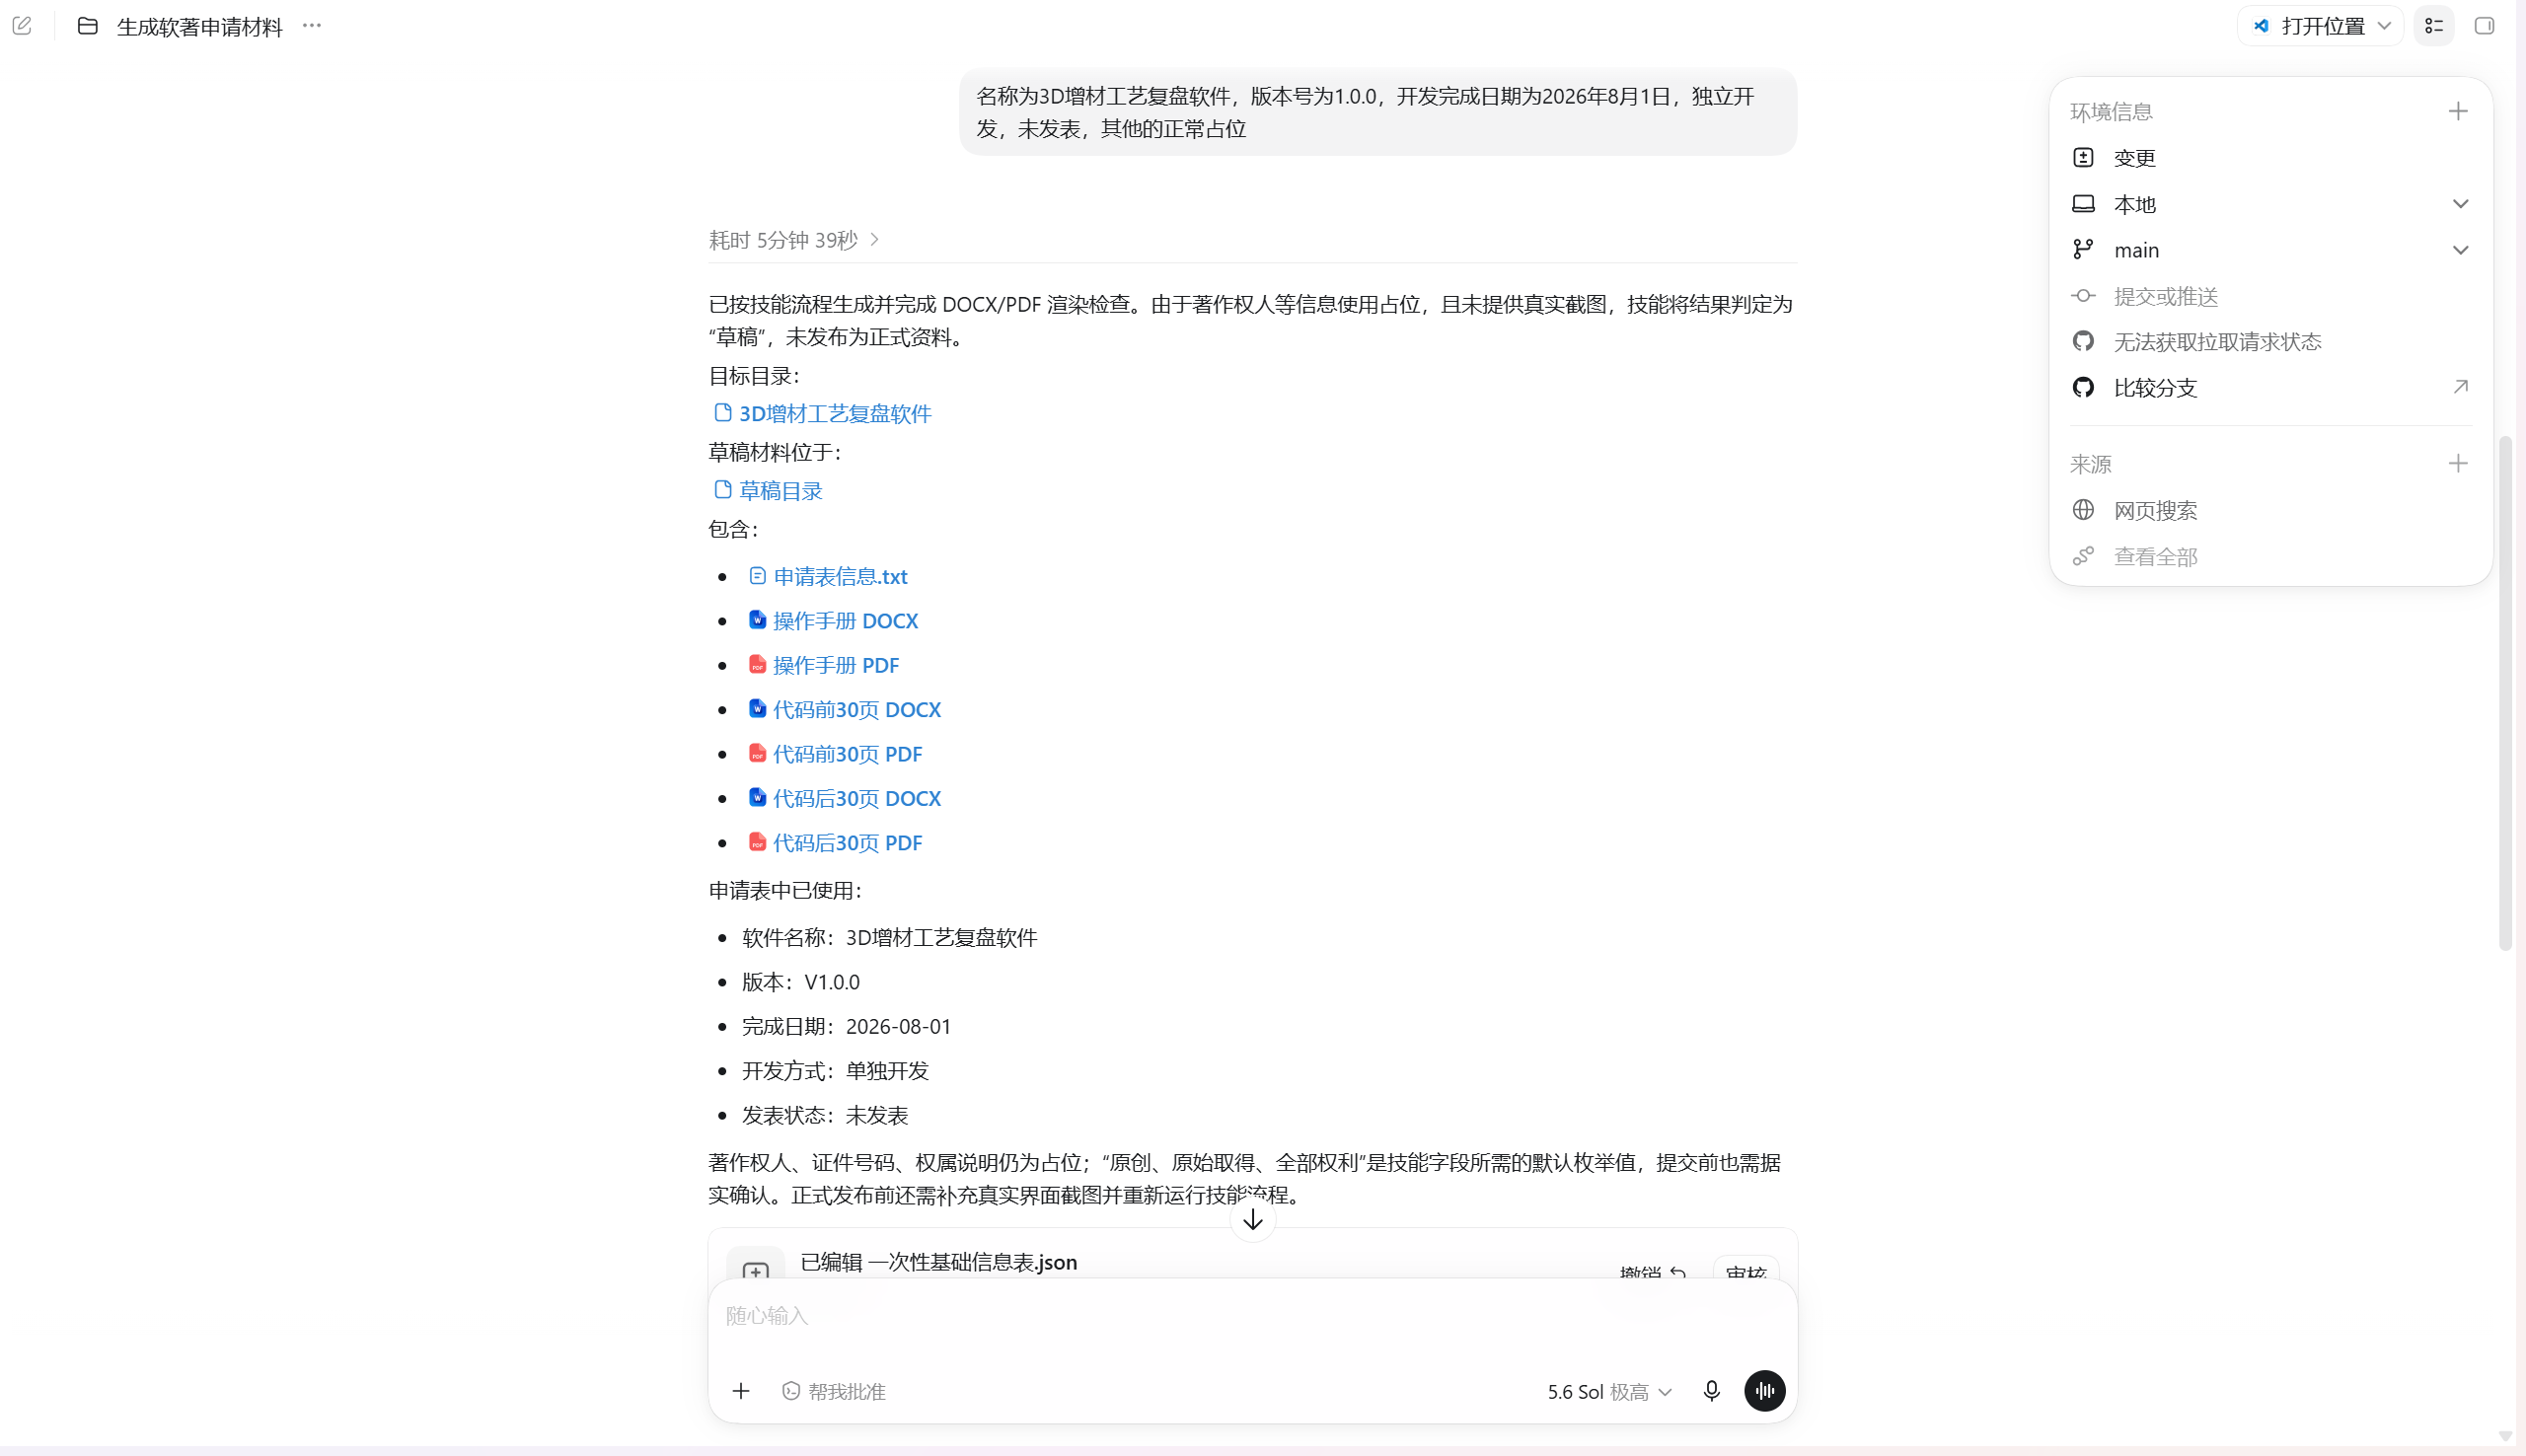
信息确认完成以后,后面的项目分析、源码选择、截图、文档生成、PDF 转换和检查会继续执行。最后生成的正式资料单独放在项目目录中,中间用到的证据和诊断文件则保存在系统临时目录。
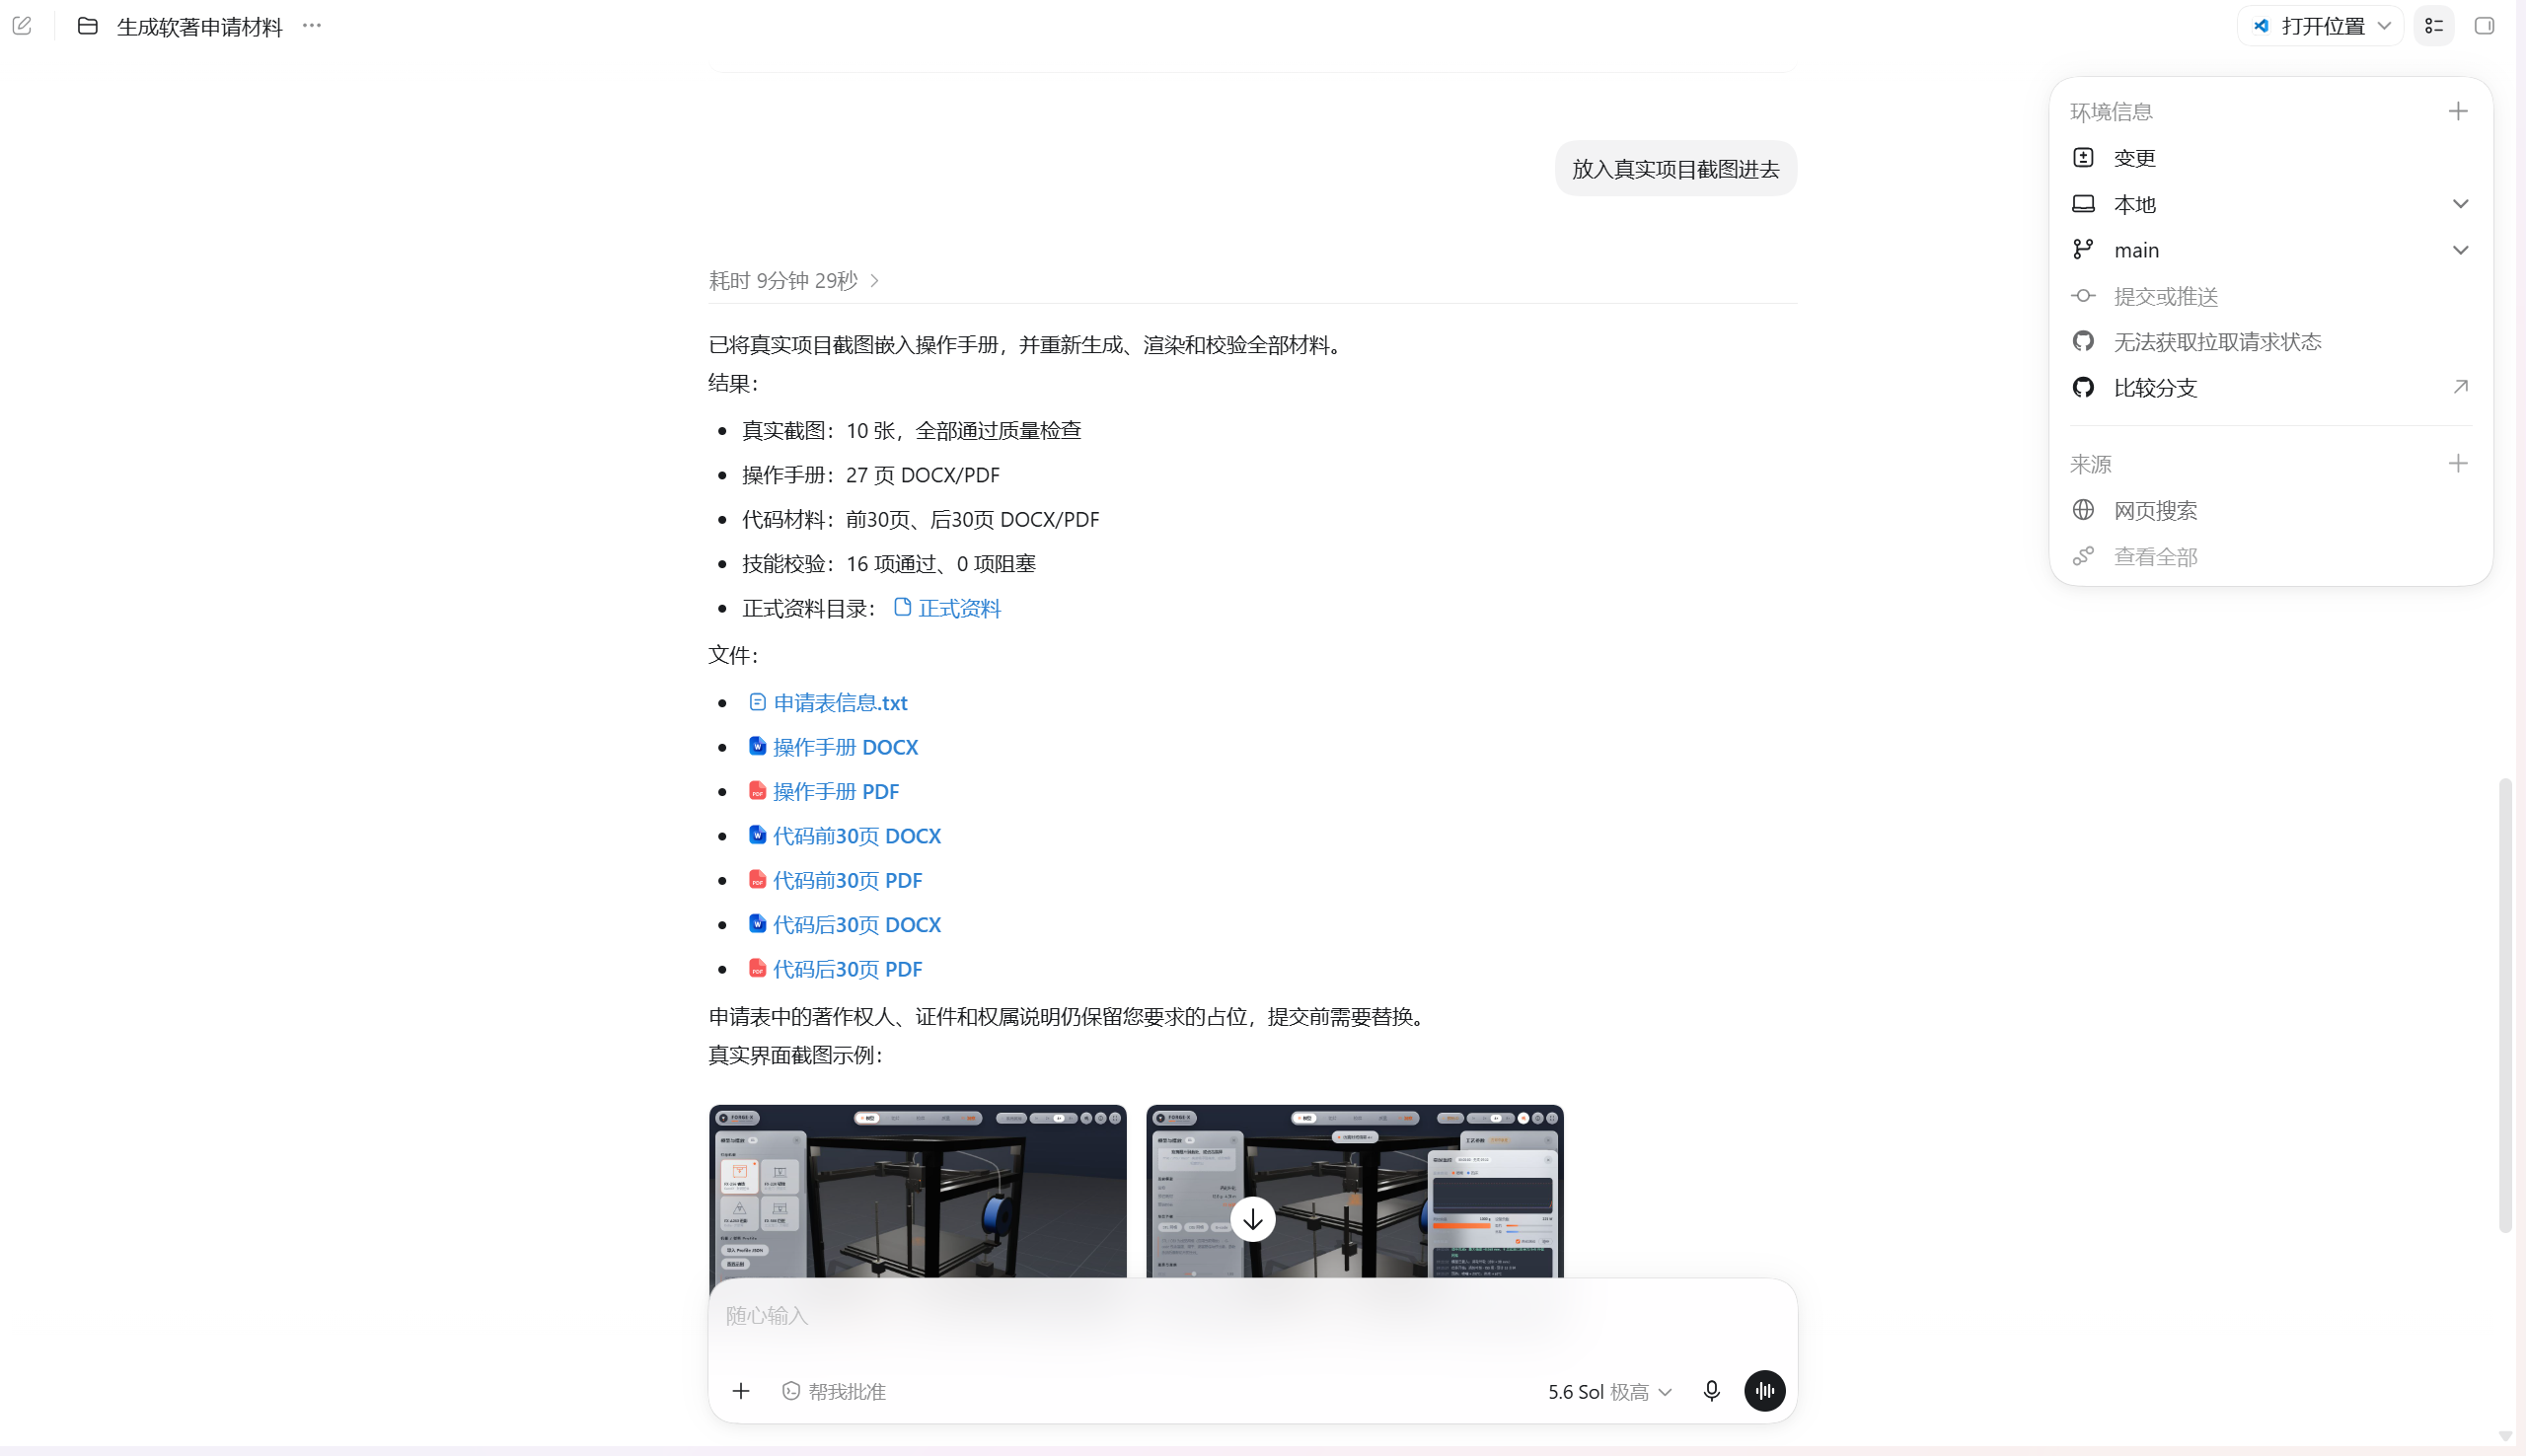
三、生成的材料

正式资料目录中会保留下面这些文件:

1正式资料/
2├─ 申请表信息.txt
3├─ <软件全称>_操作手册.docx / .pdf
4├─ <软件全称>-代码(前30页).docx / .pdf
5└─ <软件全称>-代码(后30页).docx / .pdf
6

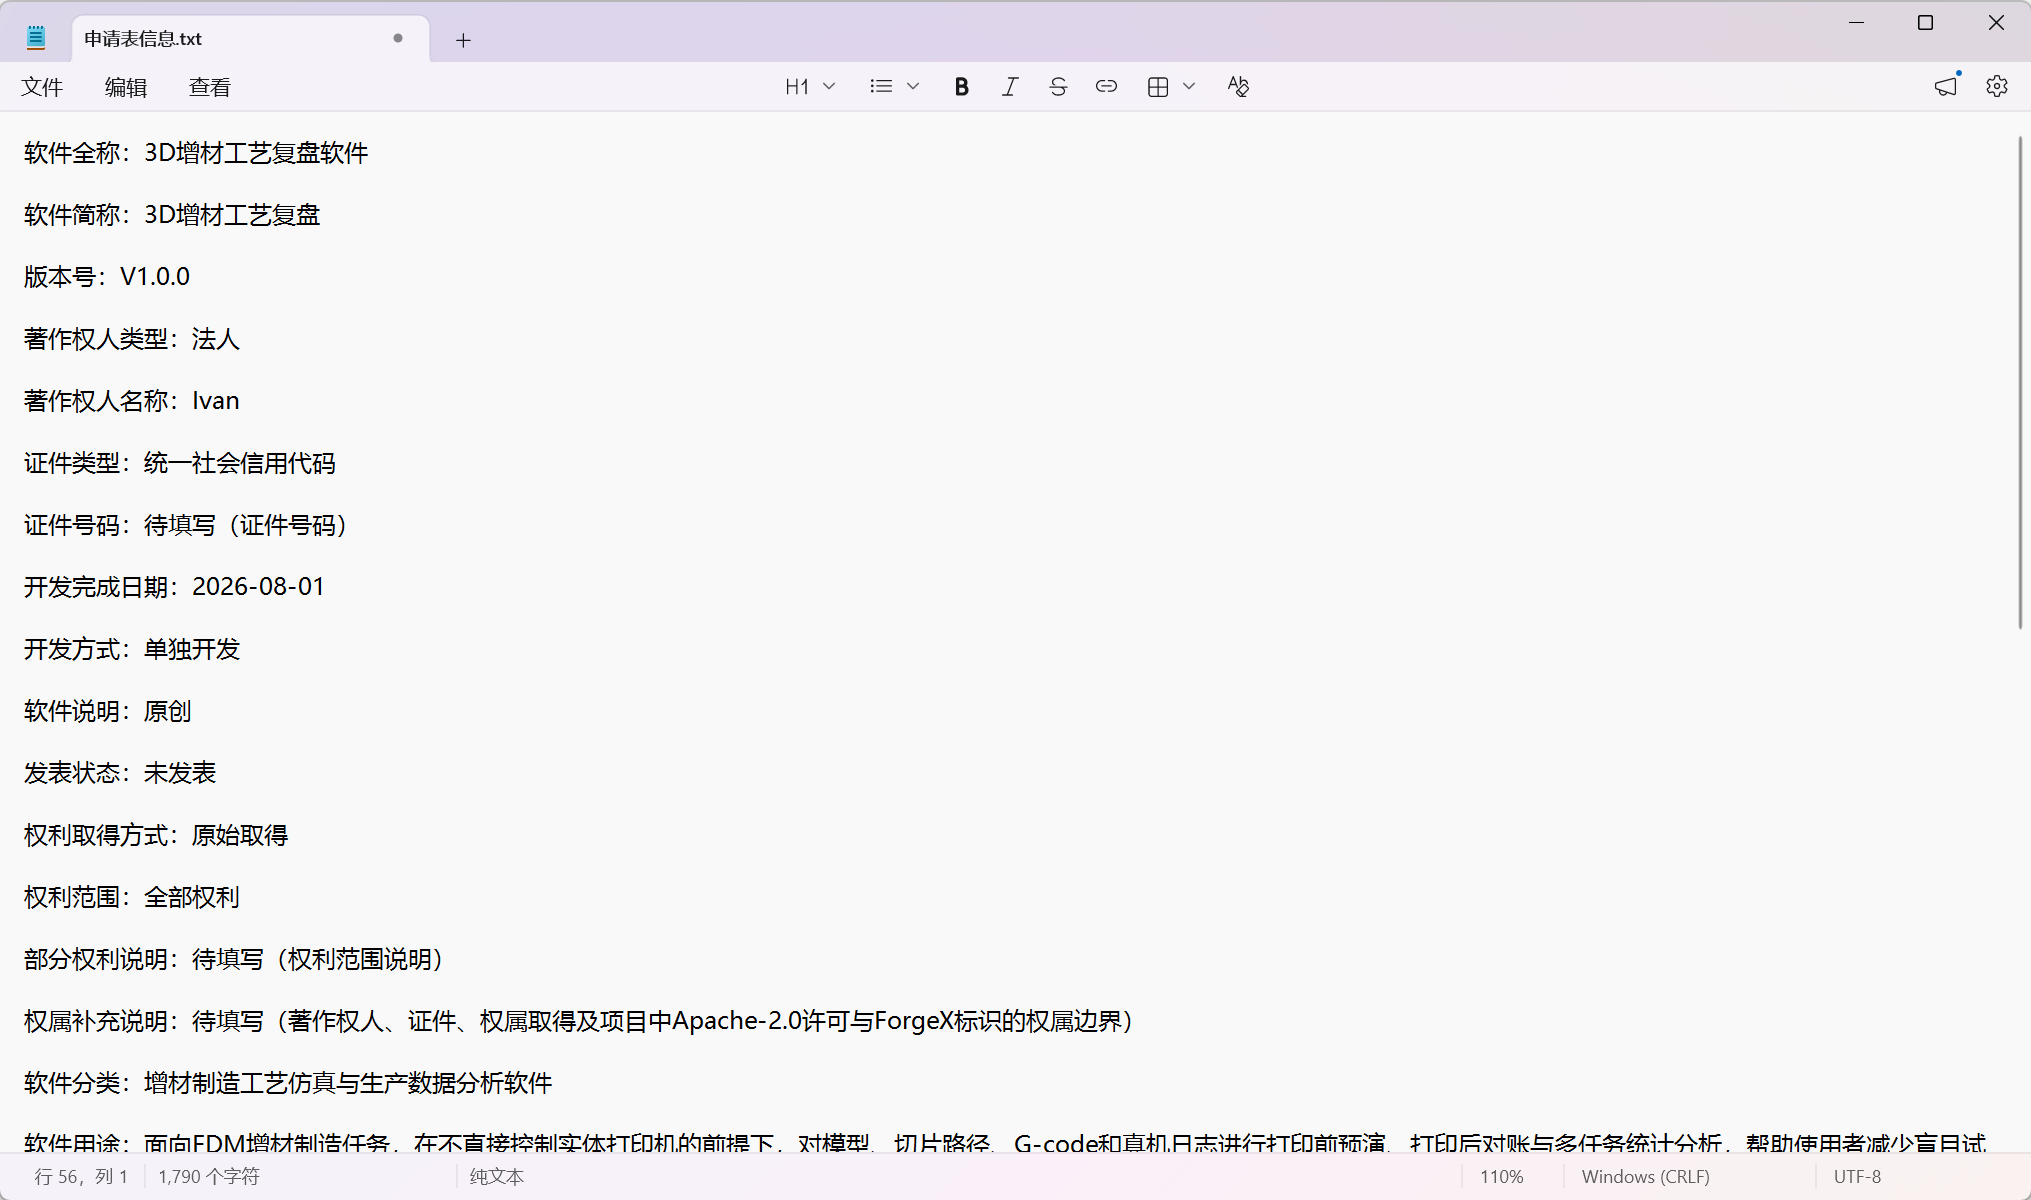
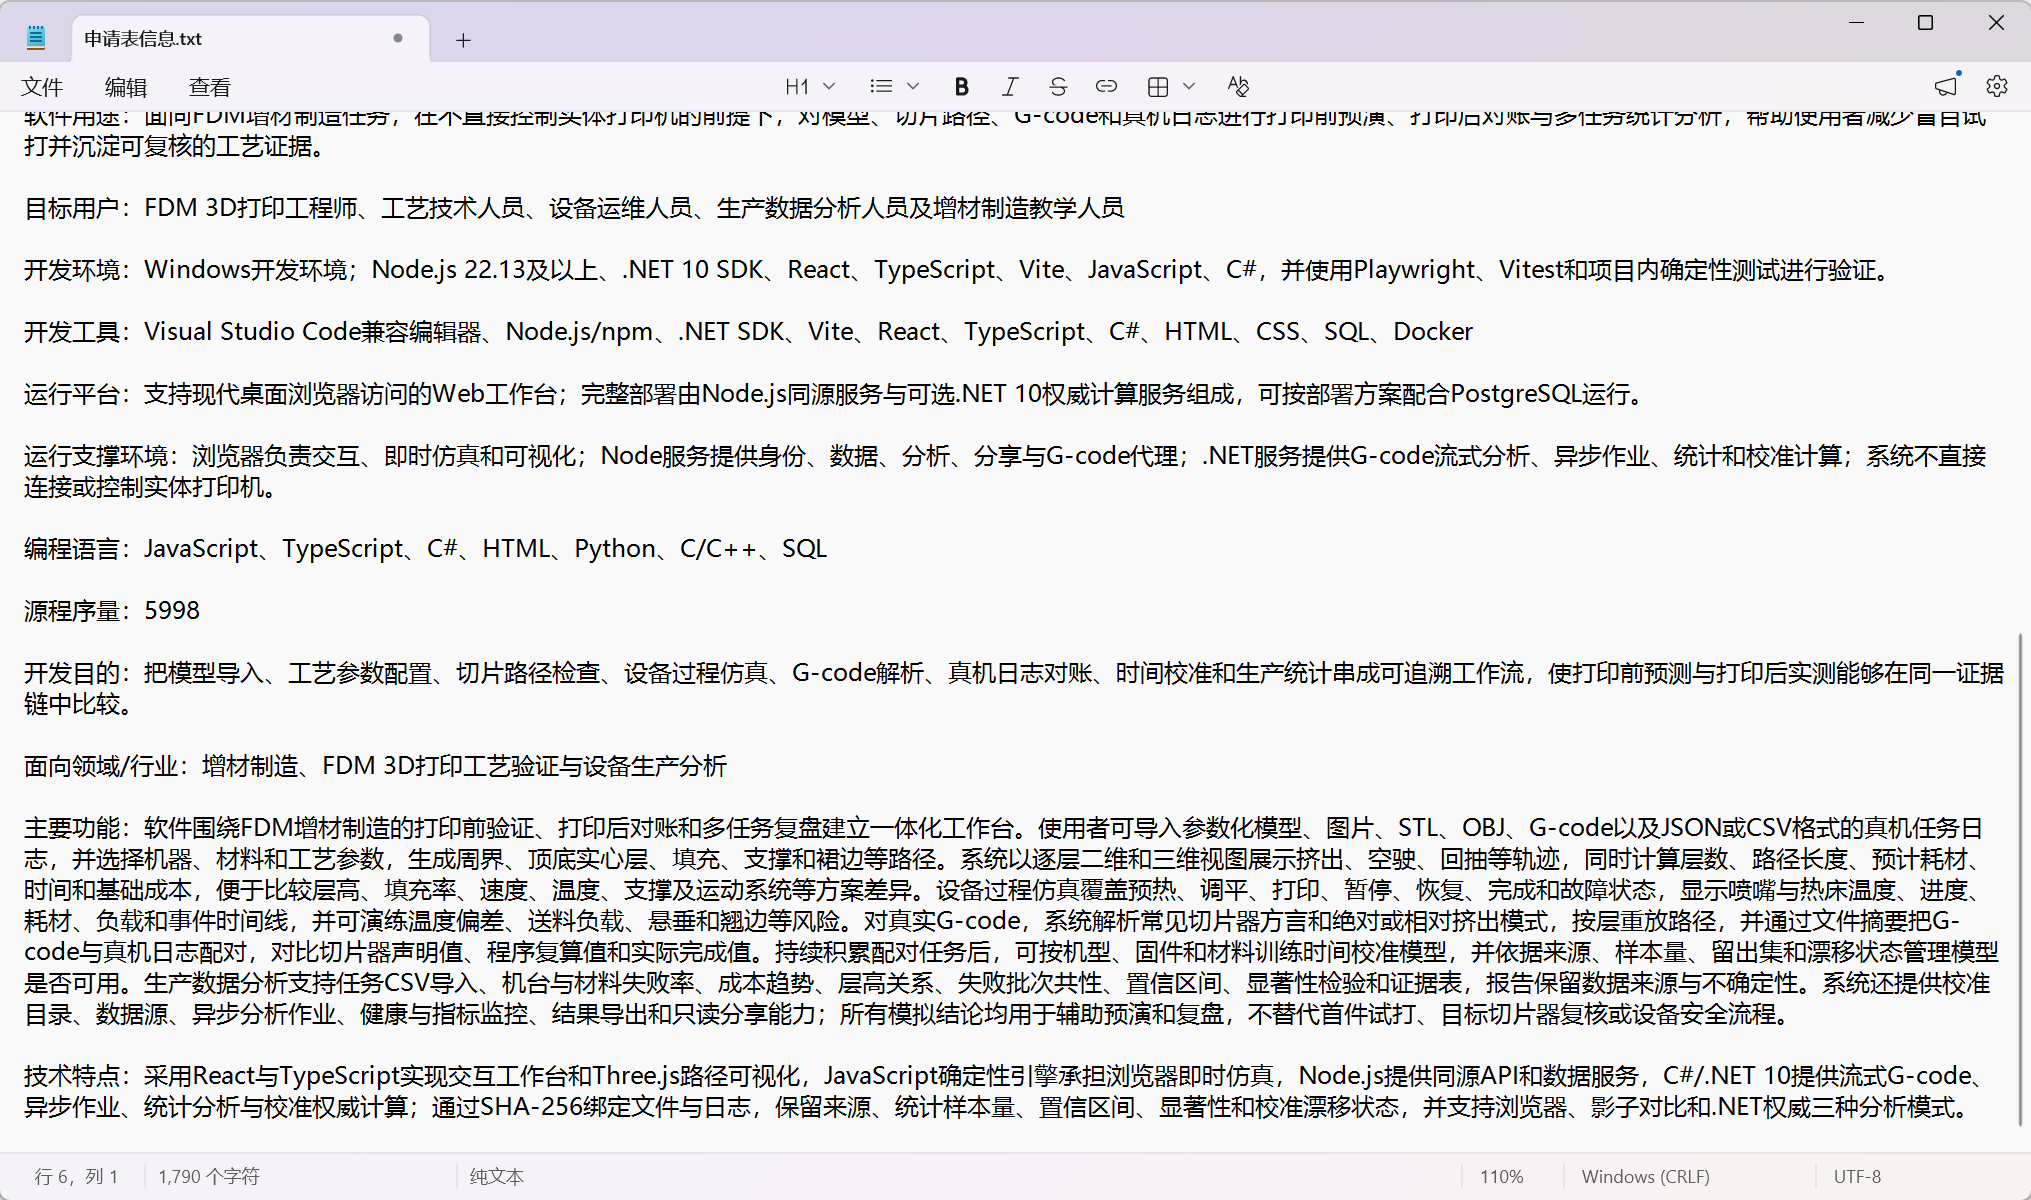
申请表信息.txt 用来整理登记系统中需要填写的内容。操作手册和代码材料都会生成 DOCX 和 PDF,DOCX 可以继续检查和修改,PDF 用来准备上传。

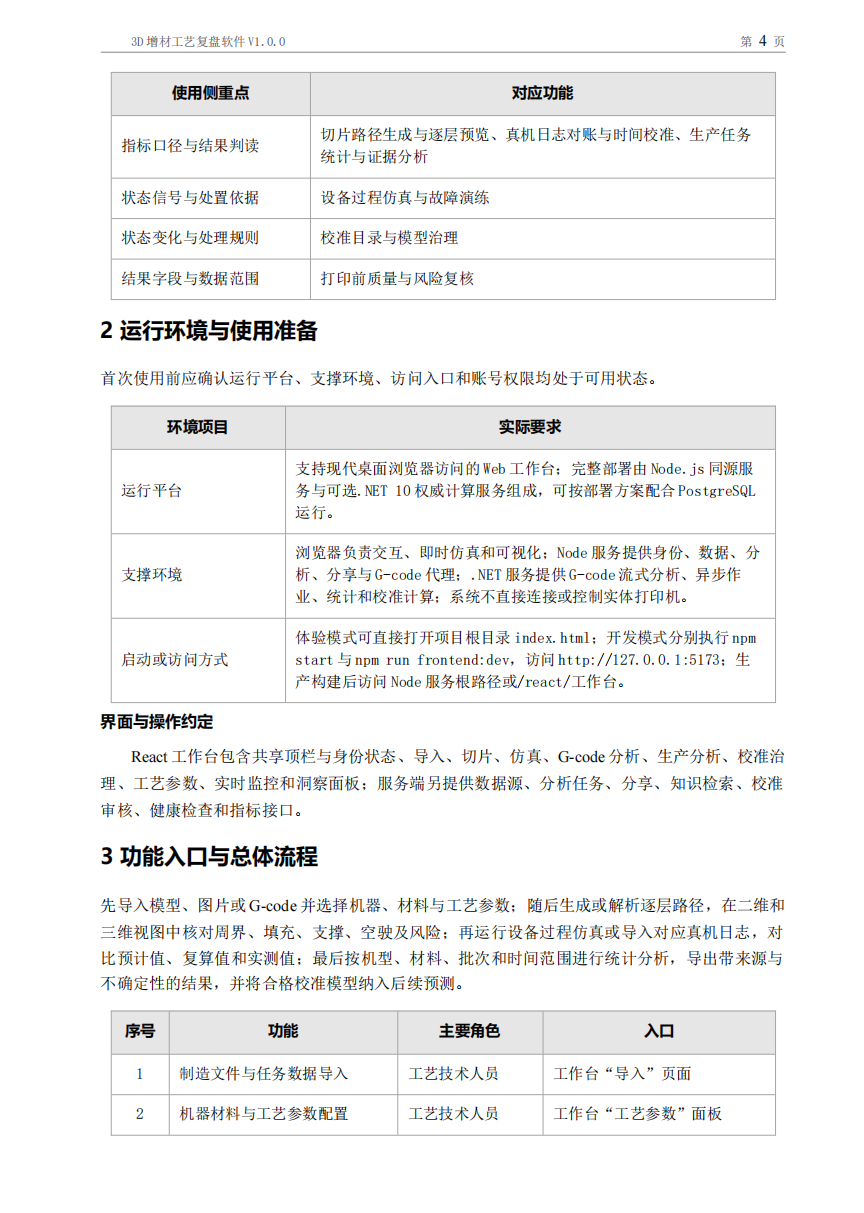
操作手册根据项目里的真实功能组织章节,使用 A4 和黑白灰排版。项目内容比较多时,通常会生成 40 至 60 页,小项目则按照实际内容缩短。

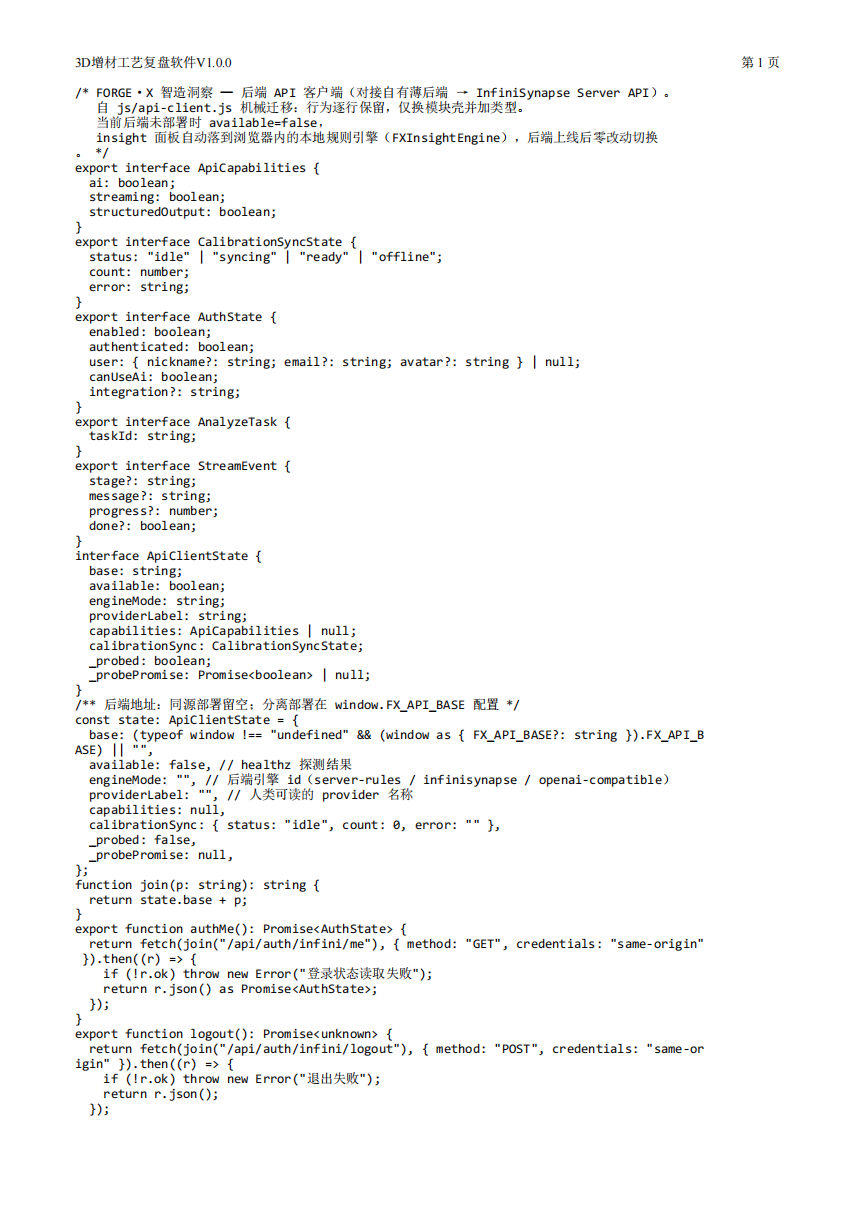
代码材料会从项目的入口、路由、页面、组件、服务、API、模型和算法中选择,同时排除依赖、构建文件、锁文件和无关代码。源码达到 60 页时生成前后各 30 页,不足 60 页时提交全部。
申请表信息也会单独整理出来,提交时可以对照当前的登记系统填写。
四、项目里做了哪些处理

这个 Skill 不会只根据 README 生成材料。它还会扫描你的配置、路由、页面、组件、服务、API、模型、测试、部署文件和已有截图,生成的功能需要能够在项目中找到对应的内容。
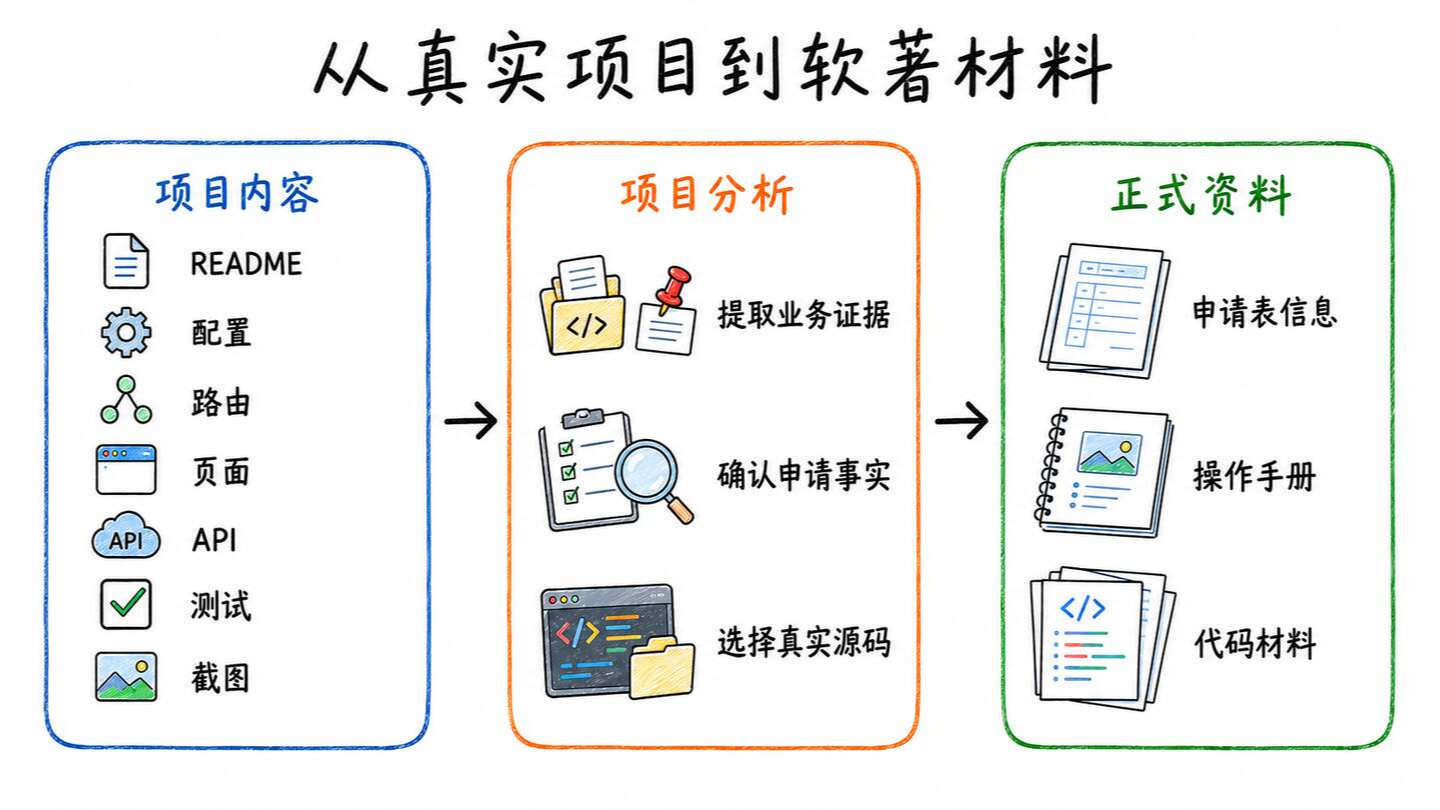
skill在生成代码材料的时候,会保留源文件、原始行号和哈希,生成 PDF 后检查页数、页眉和前后卷是否连续。在生成操作手册的时候,支持自动截图、Computer Use 和手动上传,没有截图时也可以先生成草稿。
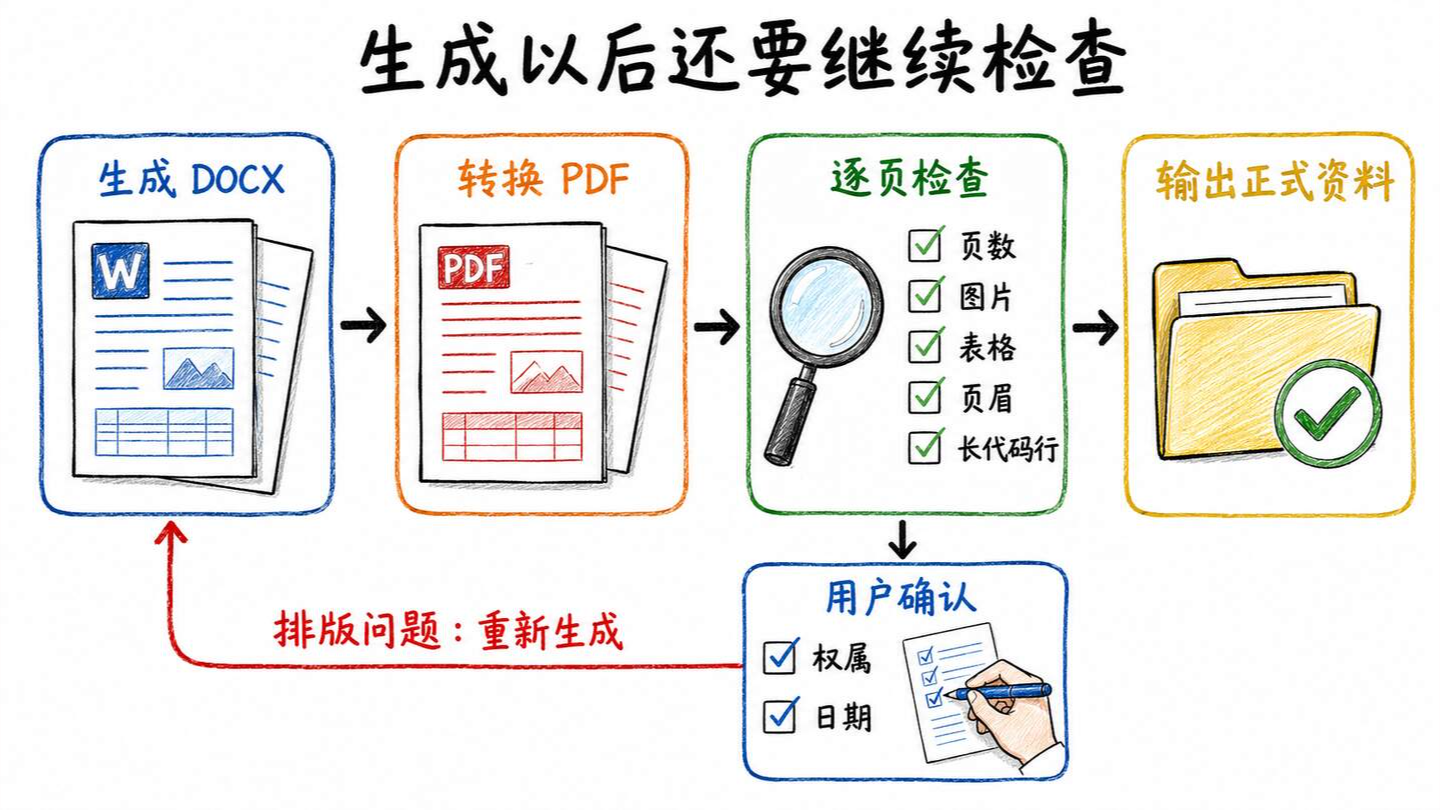
申请表、操作手册和代码材料共用同一份信息,名称或版本修改后只更新相关文件。DOCX 转成 PDF 后会再次检查分页、图片和表格,权属和日期仍由用户确认。

五、在 Qoder 中验证

我们也可以拿一个国产的AI IDE —— Qoder试试,也是同样的效果。直接说帮我安装一下这个skill就可以了。
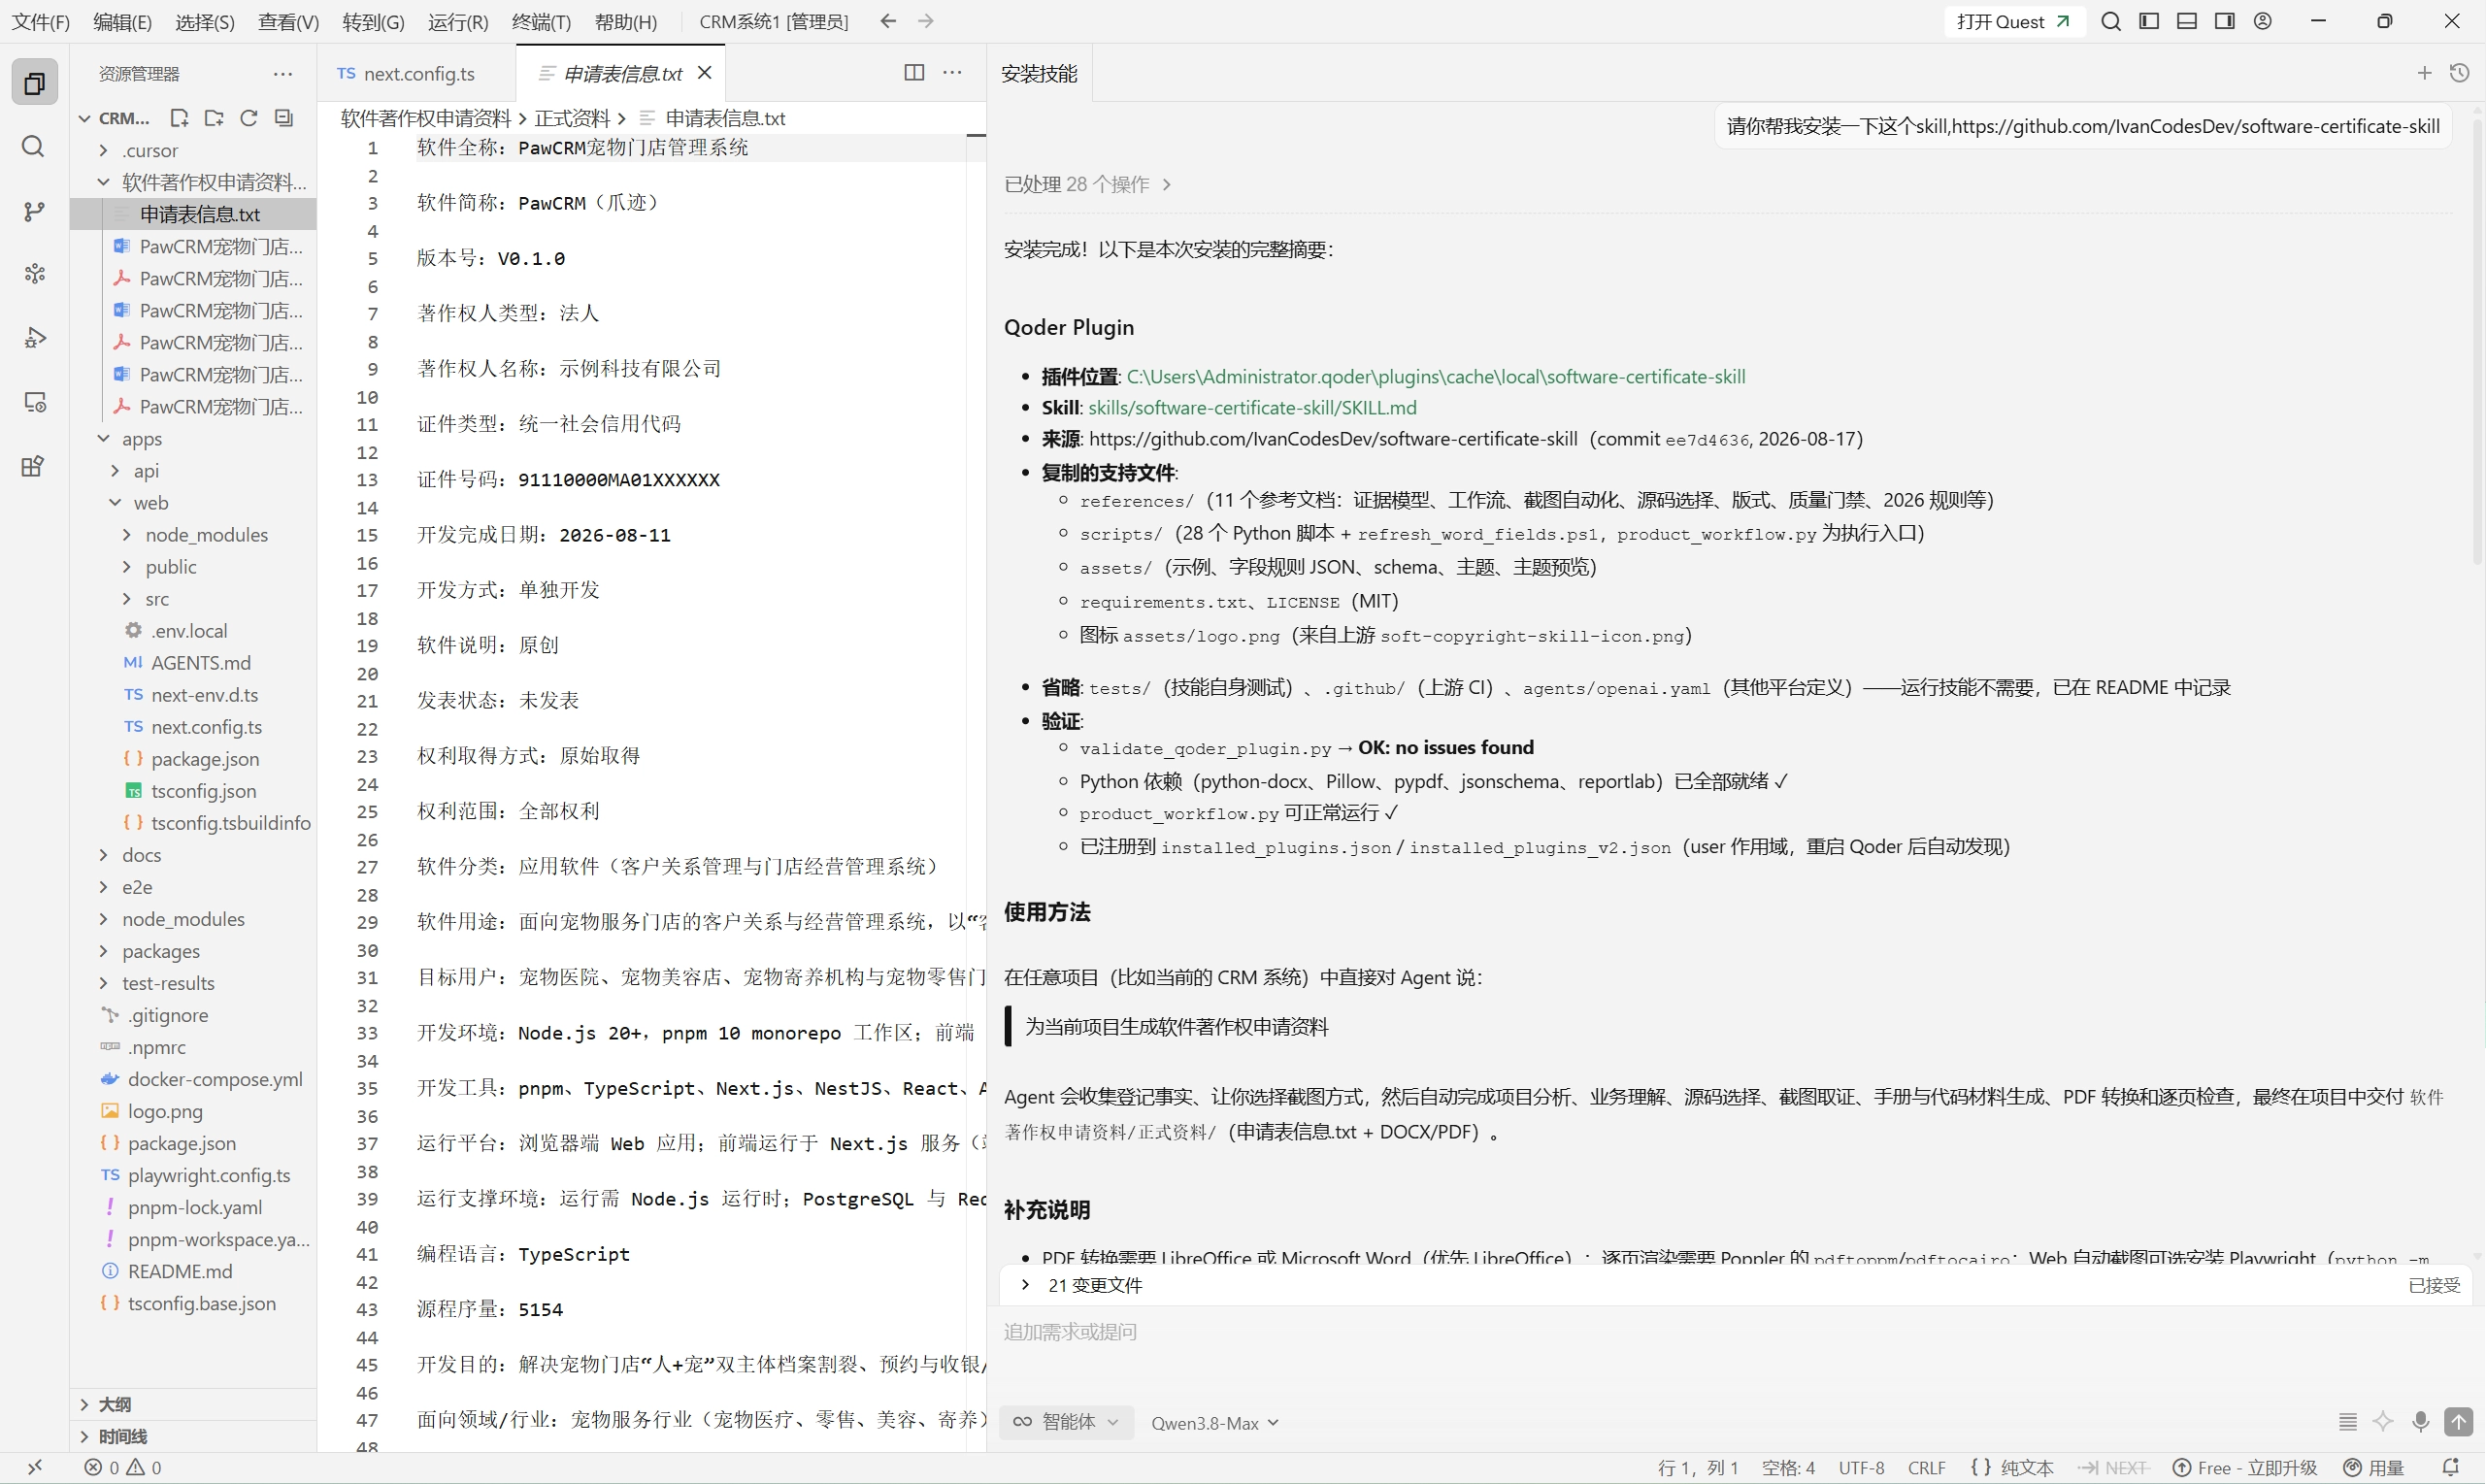

最后生成的操作手册、代码材料也同样很不错。
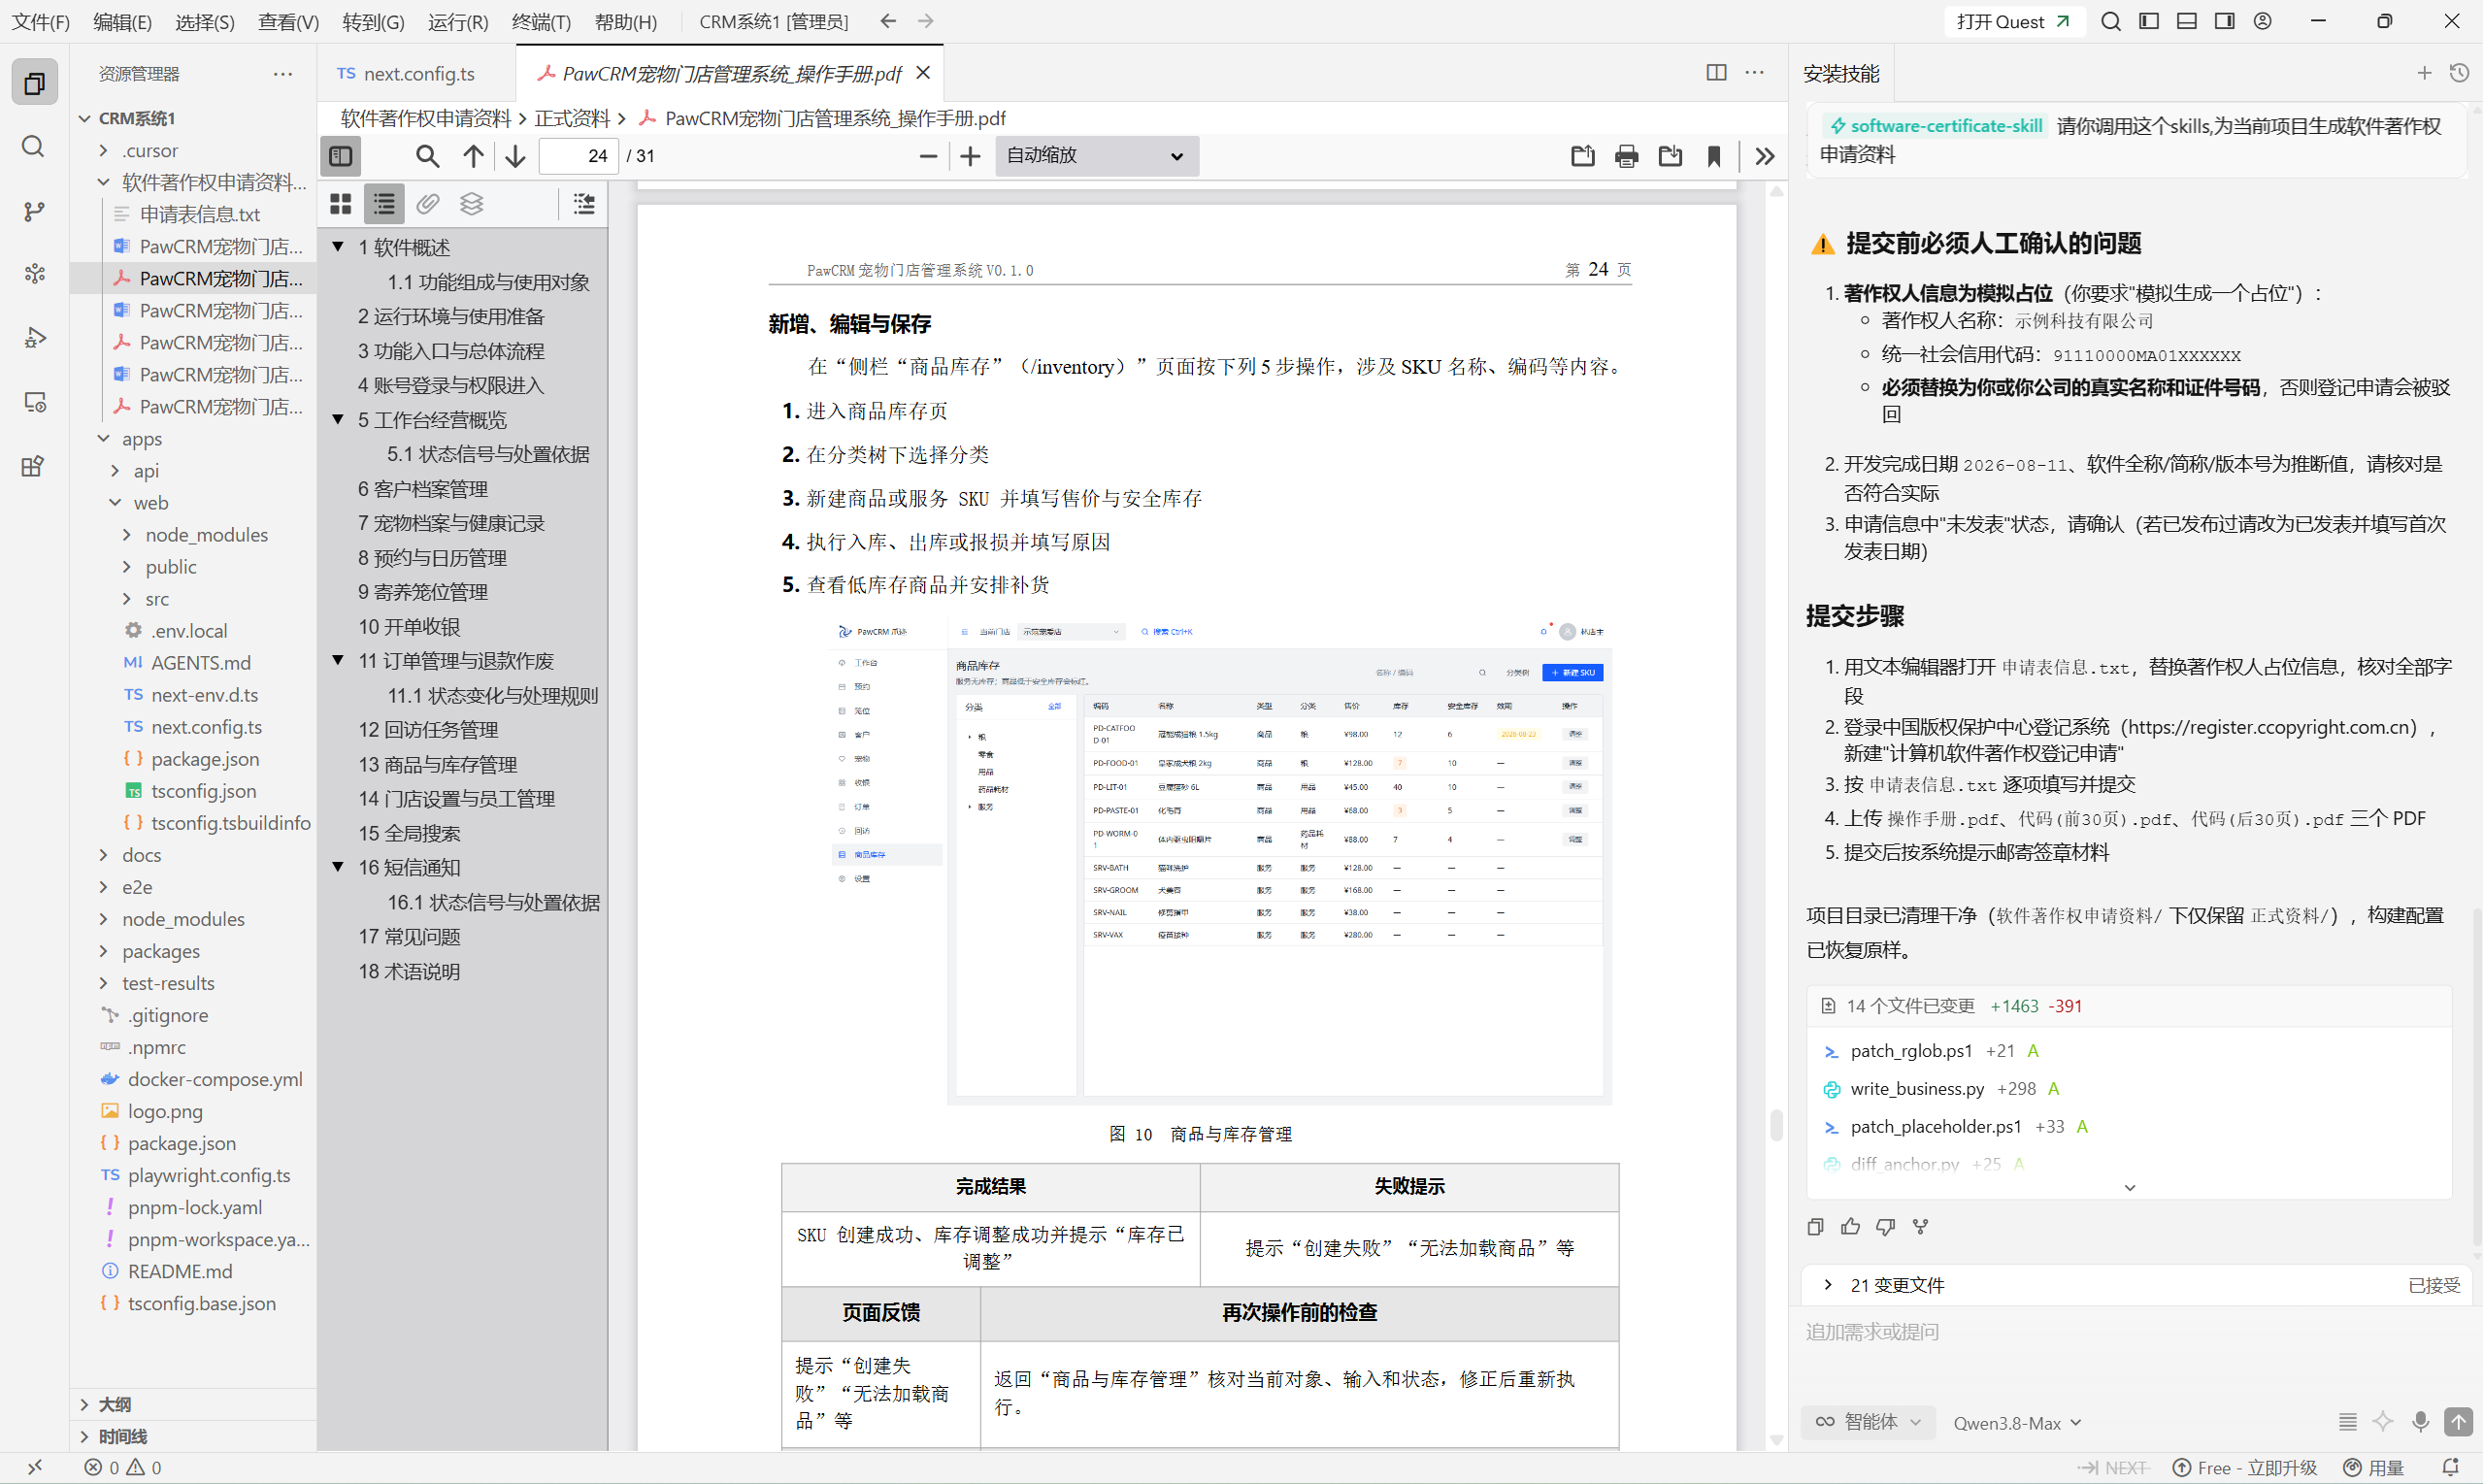

六、测试

仓库里提供了单元测试、Skill 检查和自测试脚本:

1python -m unittest discover -s tests -v
2python scripts/validate_skill.py
3python scripts/self_test.py --workdir "${TEMP}/software-certificate-self-test"
4

测试时会在系统临时目录中创建脱敏项目,完成以后自动清理。

七、总结

目前整套流程,我已经在各个Agent平台成功跑通。大家如果使用时遇到问题,欢迎在 GitHub 提 Issue。
日期:2026 年 8 月 18 日
专栏:Agentic Skills


我做了一个软著 Skill,可以一键生成申请材料》 是转载文章,点击查看原文


相关推荐


鸿蒙应用开发:V1与V2版本数据持久化实战教程
程序员黑豆2026/8/6

这是一个使用鸿蒙技术开发的本地原生记账应用,非常适合大家用来练手。相关源码已上传至 Github,点击此处查看项目。欢迎大家交流、指正,也欢迎提交 PR。 一、引言 在鸿蒙应用开发中,数据持久化是构建完整应用体验的关键一环。无论是保存用户的登录状态、个人偏好,还是缓存应用的核心数据,都需要一套可靠且高效的持久化方案。随着HarmonyOS版本的演进,数据持久化能力也从V1版本进化到了V2版本,带来了更强大的功能和更灵活的使用方式。 本文将深入对比V1(PersistentStorage + A


上线一个人静态网站需要多少钱,难不难?
五阳2026/7/28

不难,有合法身份证就能办,只需要花费 10 元,就能发布一个网站。 但是有门槛,先说门槛,如果你的网站需要中国大陆访问,那么必须要域名备案,不同省份等待时间不同。不过最多两周,最少 1 周也能审核完成。 有人问域名不备案就访问不通吗?不是的,我在阿里云申请的域名还没来得及备案,据我观察,大约有 2-3 周时间内,是允许中国大陆用户访问的,但是三周以后如果你还没有备案,那么就会被封掉,但是海外用户还能访问。 这是上线一个网站最困难和煎熬的环节了。 注意:国内个人用户备案域名,只能备案个人博客用途,


Agentic RAG 入门:从固定检索到自主决策
copyer_xyf2026/7/20

普通 RAG 的思路很直接:用户提出问题,系统从知识库检索相关片段,再让大模型根据这些片段生成回答。 这条链路解决了一个重要问题:模型不必只依赖训练时记住的知识,而是可以在回答前读取企业文档、产品手册、业务数据等外部资料,再根据资料组织答案。 但传统 RAG 的执行流程通常是固定的。这里的“固定”,不是说每次召回的文档都相同,而是说无论用户问什么、检索结果质量如何,程序都会按照上图展示的同一条路径执行。它不会在运行过程中重新判断,也不会主动改变检索策略。 但是,这种固定流程会遇到几个实际问题:


AEO 答案引擎优化:从“被搜索”到“被引用”的 AI 营销下一站
A亨日记2026/7/11

一、AI 正在改写“搜索”的默认行为 过去二十年,用户打开百度、Google 的第一件事是输入关键词,然后在十条蓝色链接里选择。但今天,越来越多的人直接向 DeepSeek、豆包、Kimi、ChatGPT 提问,并期待得到一个“直接可用”的答案。 这意味着企业的营销目标正在发生根本转移: SEO 时代:争取搜索结果页的前十排名;GEO 时代:争取被生成式引擎在回答中主动引用;AIO 时代:用结构化数据与反馈闭环持续优化 AI 对企业的“认知”;AEO 时代:直接为答案引擎生产“可被引用的高置信度


解决方案十八-企业级发音评测技术使用
Liu202605172026/7/3

在人工智能与教育深度融合的今天,语音评测技术(Speech Evaluation)已成为语言学习、在线教育、智能客服等领域的核心基础设施。无论是英语四六级口语考试、普通话水平测试,还是儿童语言启蒙应用,都离不开稳定、精准的语音评测能力。 然而,对于许多前端开发者而言,语音评测似乎总隔着一层“黑盒”——如何从前端采集音频?如何与云端AI服务建立稳定连接?如何处理流式数据并实时展示评测结果?这些问题往往让人望而却步。 本文将带你从零开始,基于Vue.js和WebSocket协议,构建一个完整的语


Claude Code上手指南:安装、部署、接入大模型
小此方2026/6/25

◆ 博主名称: 晓此方-CSDN博客 大家好,欢迎来到晓此方的博客。 ⭐️现代AI系列个人专栏: 【别传】AI应用与开发 ⭐️ “当AI能力被内化,智能就不再是成本,而是生产力。”——李彦宏 概要&序論    Hello,大家好,我是此方。 本文将带大家从零开始,完整走通 Claude Code 的安装、配置与部署流程。 一,让你的 Claude Code 动起来 1.1 安装前置软件 1


K-Means 聚类的目标函数:簇内误差平方和
F_D_Z2026/6/16

1. 什么是 K-Means? K-Means 是一种无监督、迭代式的聚类算法: 给定数据集 {x₁, x₂, …, xₙ} 与预设簇数 K,算法把样本划分为 K 个不相交的簇 C₁, C₂, …, Cₖ,使得同一簇内样本尽可能相似,不同簇间样本尽可能远离。 核心思想: > “让簇内‘抱团’,让簇间‘疏远’。” 2. 目标函数 J:簇内误差平方和(WCSS) K-Means 用几何距离衡量相似性,目标函数 J 定义为: J=∑k=1K∑x∈Ck∥x−μk∥2 J = \sum_{k=1}^{K


STM32F4 TIM定时器HAL库源码完全解析
冉卓电子2026/6/9

一、前言    在STM32嵌入式开发中,TIM定时器是使用频率最高、功能最丰富的外设之一,几乎所有嵌入式项目都会用到定时中断、PWM输出、输入捕获、编码器解码等功能,而这些功能的底层支撑都是TIM外设。   很多开发者只会调用HAL库现成函数,却不懂底层实现逻辑,遇到定时器卡死、PWM波形异常、捕获数据不准、DMA传输失效等问题时无从排查。   本文基于STM32F4xx HAL库 tim.c 完整源码,保姆级拆解TIM定时器全套底层架构、功能模块、核心函数、回调机制与使用规范,带你从源


【GaussDB】会话里出现大量idle in transaction状态的问题排查
DarkAthena2026/6/1

【GaussDB】会话里出现大量idle in transaction状态的问题排查 背景 客户DBA给应用开发人员宣讲GaussDB数据库的idle in transaction会话的监控告警后,开发人员自查,发现在开发环境中存在大量的idle in transaction会话,一时恐慌,于是来找DBA帮忙排查是不是应用代码哪里写得有问题。 数据库内核版本是 506.0 SPC0500 集中式。 检查应用 应用软件使用的spring框架接mybaitis,连接使用基于DBCP修改的连


Milvus 实战:当 RAG 遇上向量数据库,从"玩具 Demo"到"生产可用的"那一步
Lee川2026/5/25

Milvus 实战:当 RAG 遇上向量数据库,从"玩具 Demo"到"生产可用的"那一步 前面的文章讲过,RAG 的第四步是"向量存储"。在原型阶段,一个 MemoryVectorStore 就能跑通全链路。但问题是:程序一关,所有向量灰飞烟灭;数据一多,内存直接爆掉;更别提多用户隔离、权限控制、分布式检索这些生产环境的刚需。 MemoryVectorStore 是 Demo 的终点,却是向量数据库的起点。 本文通过一段与 Milvus(Zilliz Cloud)交互的真实代码,拆解向量数据库

首页编辑器站点地图

本站内容在 CC BY-SA 4.0 协议下发布

Copyright © 2026 聚合阅读