引言
今天我们也是正式进入到Linux的学习,想必大家对Linux这个名字都不陌生,Linux是一套开源、免费、多用户和多任务的类Unix操作系统内核,也是所有程序员必学的系统,今天我们就先来了解一下Linux的一些基本命令和原理。接下来的讲解我用的是Ubuntu系统。
一、目录
目录是Linux系统的核心骨架,整个系统所有资源,全部挂载在目录树下,目录就相当于是windows系统的文件夹,所以要打好Linux的基础,我们第一步要做的就是先了解Linux目录的相关知识。
我们今天要学的基础命令有:ls、pwd、cd、mkdir、rmdir、rm、touch、stat、tree、alias、man、cp、mv、echo、cat、which、more、less、head、tail、date、grep、zip、unzip、tar
1、pwd
pwd这个命令的用法很简单,就是显示当前所处的路径。如下所示,“/home/ubuntu”就是我们当前所处的路径。

此时显示的这个路径,最右边的是我们当前所处的位置,在它前面用一个斜杠‘/’进行分割的就是它的上级目录,‘/’在Linux中是路径分隔符,这时候就出现了一个问题,最前面那个斜杠是什么?它前面也没有目录名称了,它的作用是什么呢?这个斜杠在Linux中表示的是整个系统的根目录的意思,系统里的所有目录和文件都是包含在‘/’这个根目录下的子目录。
Linux的文件结构时一颗从根目录/开始的一个多叉树,叶子节点一定是普通文件或者空目录,非叶子节点一定是一个非空目录。
2、ls
ls的功能是显示当前路径下的文件,它一般有三种常见的不同写法,你既可以直接写成ls,也可以写成 ll 或 ls -l ,其中 ‘-l’是命令行选项,命令行选项可以是零个也可以是多个,多个选项既可以用空格隔开,也可以直接连在一起写。
那么它们三个有什么区别呢,“ls”是只显示当前目录下文件的名称,“ls -l”的功能是列出文件名称的同时,还会显示文件的属性。“ll”则是在“ls -l”的基础上将隐藏文件夹也显示。这是个重点知识,文件并不单单只有内容,而是由内容+属性共同构成的。学习文件,要么对内容操作,要么对属性操作

ls
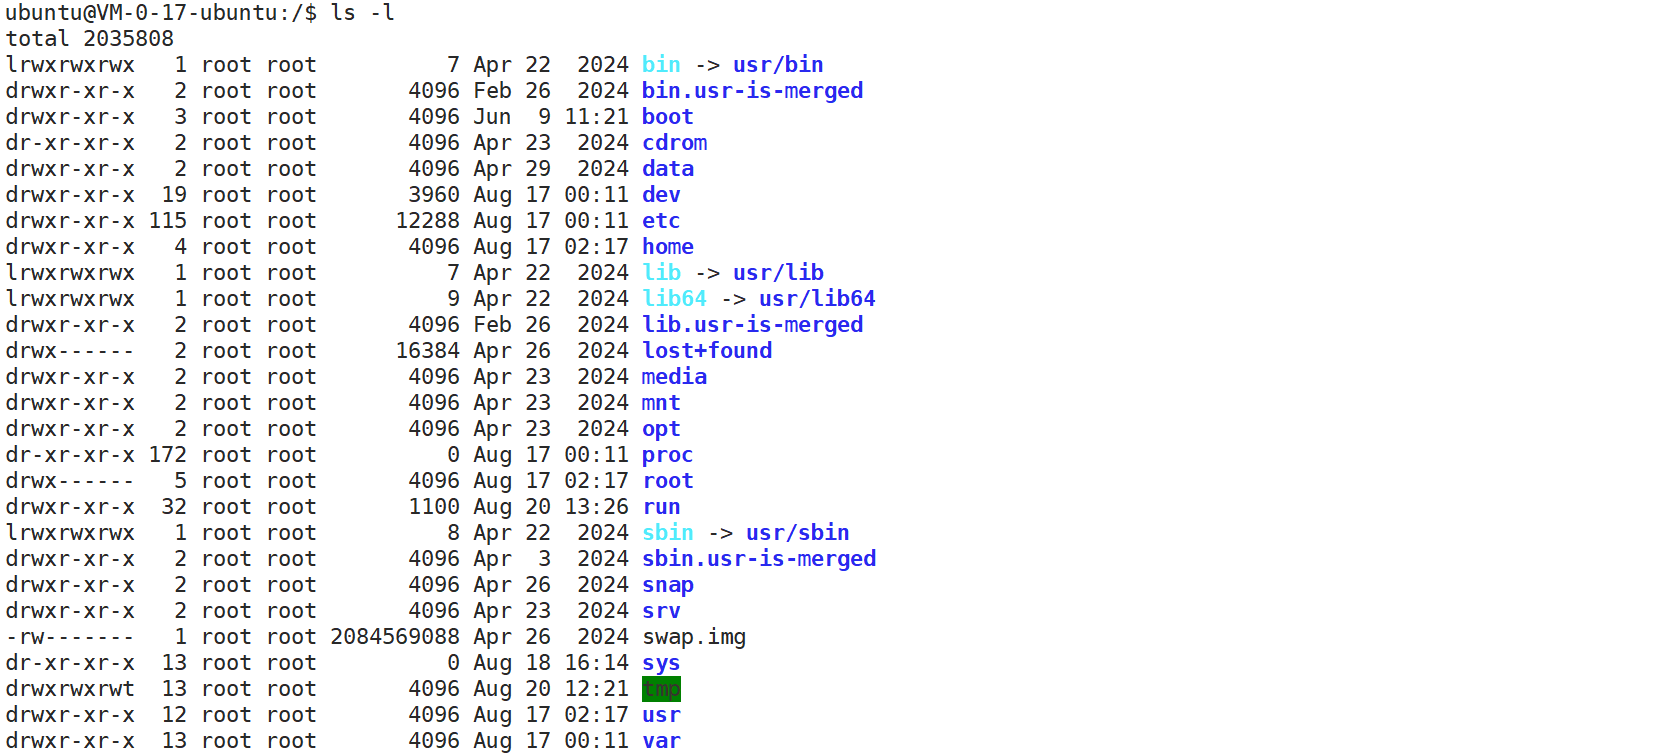
ls -l
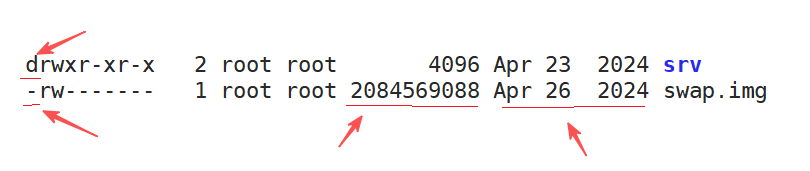
我们可以很明显的看出它们的区别。其中,文件属性最前面的单词首字母代表该文件的文件类型,d则代表它是一个目录文件,- 则代表它是一个普通文件,后面那串数字就表示它的文件大小,文件大小后就是它的最后修改时间。
ls还有一个常见的命令行选项‘-a’,上面三个命令,都只能显示普通的文件,而-a的功能就是可以列出所有的文件,包括被隐藏的文件,在Linux中,文件名前面有 ‘.’ 的文件是隐藏文件。可以看到,加上-a后上面就出现了三个以‘.’开头的文件,它们就是隐藏文件,其中有两个名字很奇怪的隐藏文件**‘.’ 和 ‘..’** ,这个我们后面会专门进行讲解。
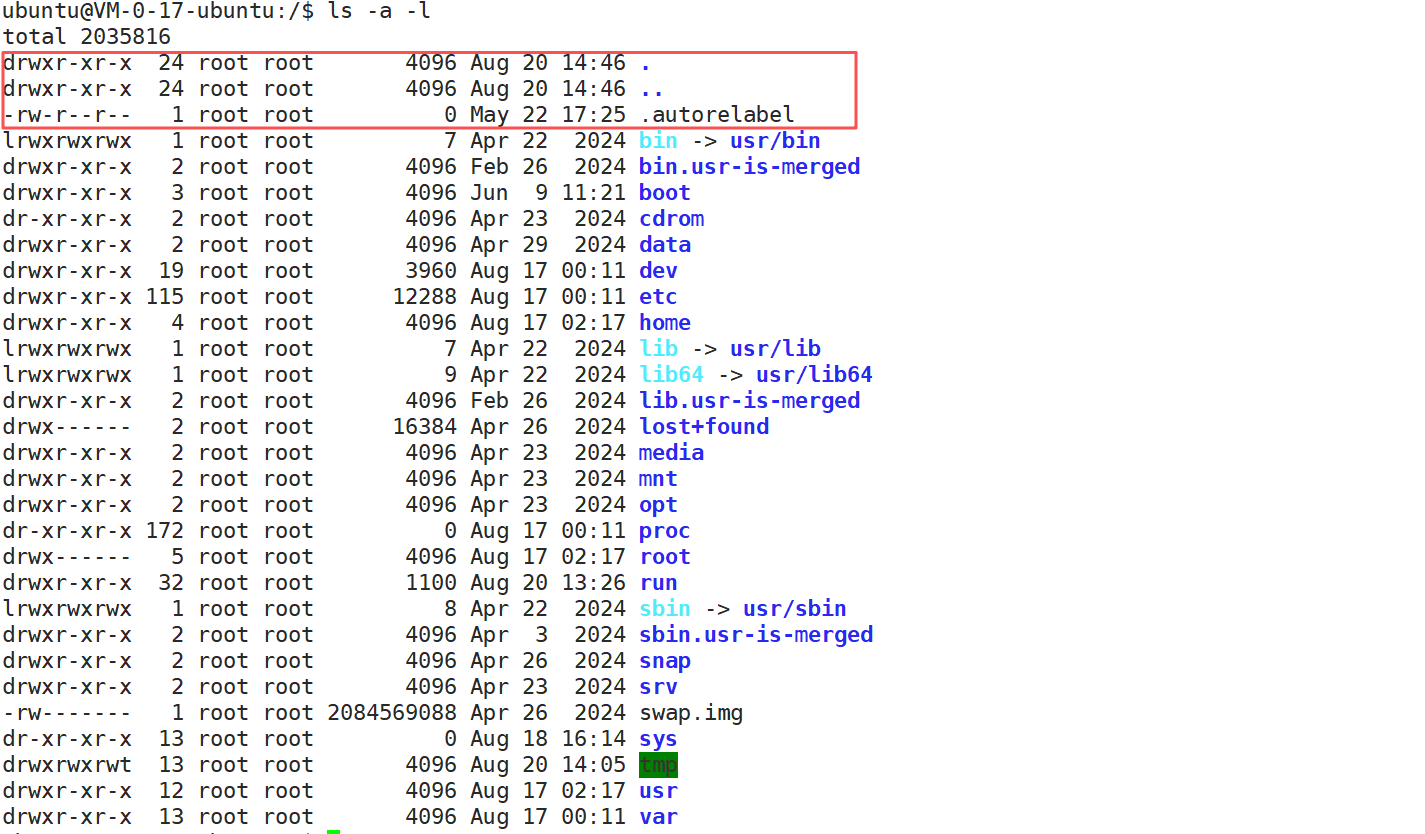
ls -a
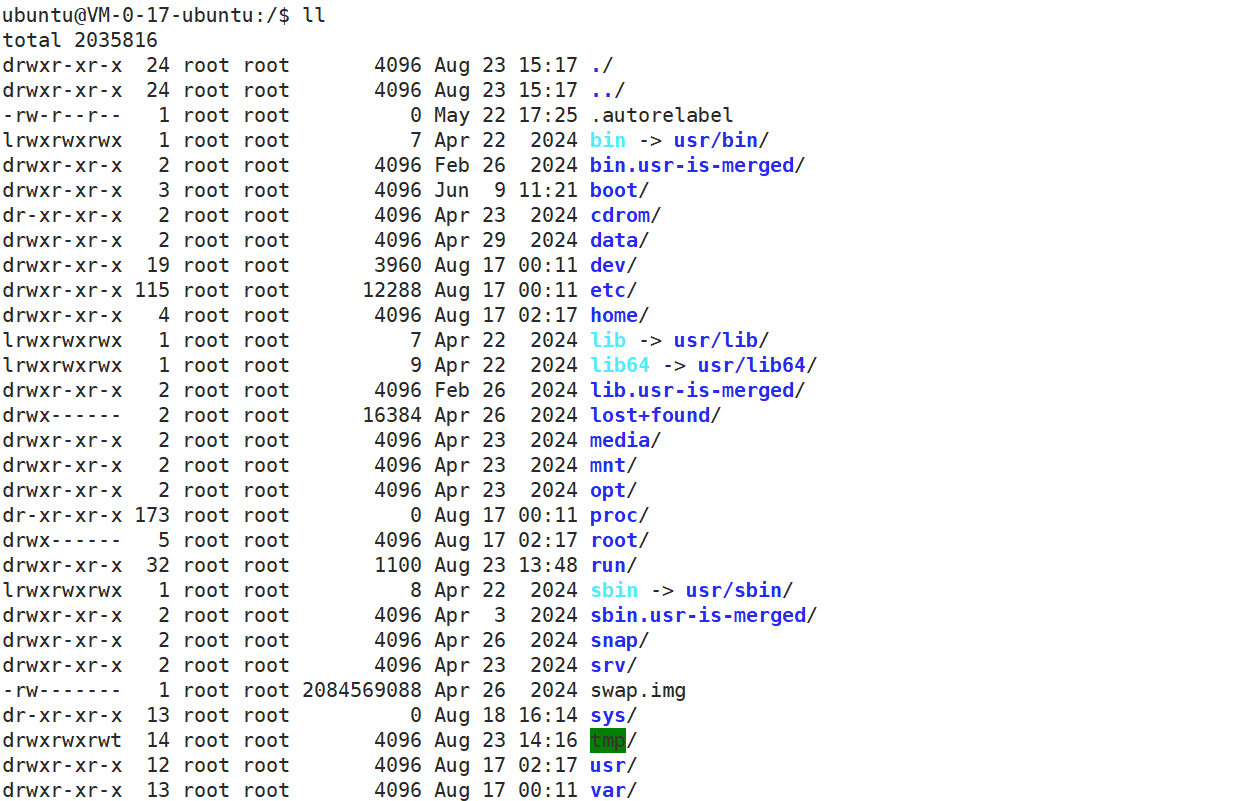
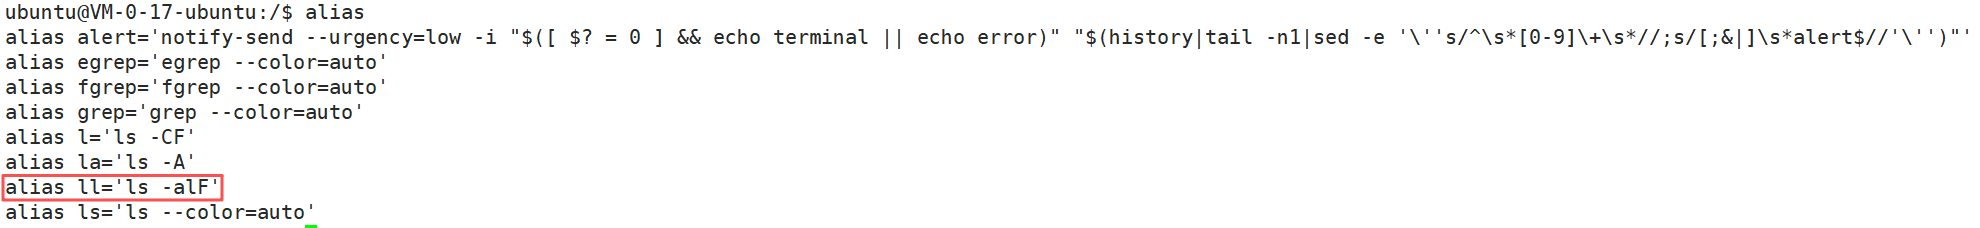
大家应该能很明显的看出来,“ll”的功能似乎就是“ls -l” 和“ls -a”的结合体,这是为什么?就像C++一样,在Linux中你也可以给命令起别名,而ll就是ls -l -a的别名,在Linux中使用alias命令就可以给其他命令起别名,具体写法是**“alias 别名 = ‘命令’ ”。**这个别名只是个临时别名,一旦你退出当前机器,别名就会消失。直接输入alias可以看到当前机器的所有别名:
3、tree
tree和ls类似,也是用于显示当前路径下的文件,tree在用的时候要在后面加上文件名,tree与ls不同的地方在于ls是以一个表的形式来展开,tree则是以树形结构展开文件里所有的文件和目录结构。如下所示。
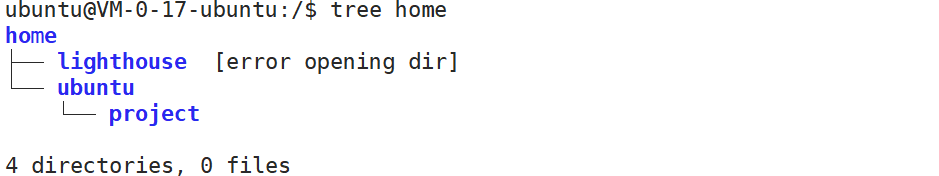
有些系统在刚下载时可能并没有自带tree命令,这时候可以输入sudo apt install tree,就可以将tree配置到系统中。
4、mkdir/rmdir/rm/touch
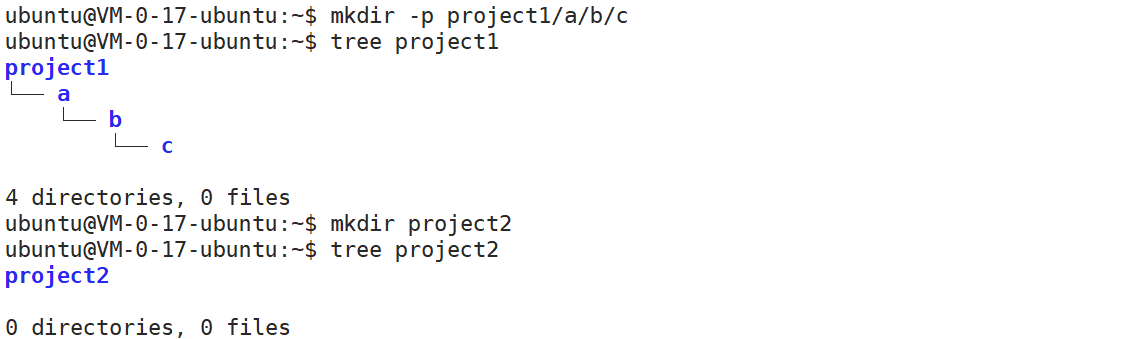
这四个命令都是用于目录/文件的创建和删除,所以我们一起讲。mkdir是创建一个新目录,但是只能创造一个,那如果有人就想连续创建一串目录怎么办呢?这时候就可以用到一个命令行选项-p, mkdir -p +一串路径,就可以一次创建一串路径。
rmdir的功能是删除目录,但需要注意的是它只能删除空目录,不能删除非空目录,如果想要将一个非空目录里所有的东西都删除,就需要使用rm,rm本身的功能是用来删除普通文件的,但是如果它加上命令行选项-r,就可以递归地删除整个目录内的所有内容

rmdir

rm -r
最后一个touch则是用来创建一个普通文件,没什么好说的。
5、cd
cd这个命令的用途是用来更改工作目录,简单来说就是进入目录的意思,最常见的用法就是直接在cd后面加上文件名。
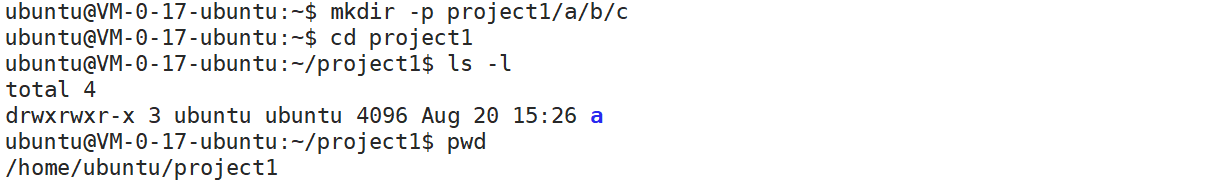
如果你想要进入的文件并不在当前目录下,而是在子目录下,就得在cd后面加上路径来进入。假设我现在想进入c目录,可以看到我们就进入了c目录里面。
cd还有两种特殊的用法,cd ~就是进入当前用户自己的家目录,家目录的意思就是,任何一个Linux用户,用特定用户名登录系统时,默认就在家目录下,比如说我当前的家目录就是ubuntu。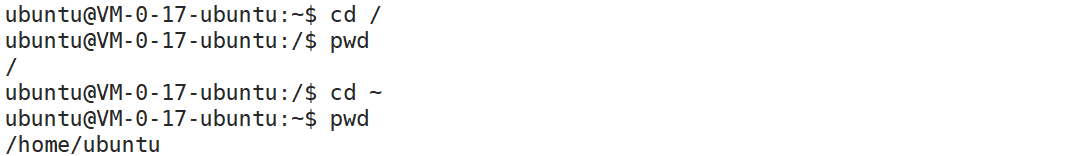
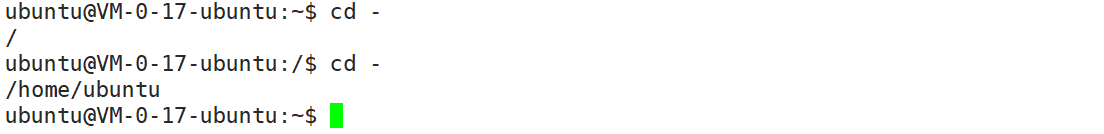
cd -可以进入最近所处的路径,是一个很方便的功能,比如我刚刚所处的文件是根目录/,此时我输入cd -,就会从ubuntu进入/,再输入一次又会从/进入ubuntu。
接下来我们将在这里隆重介绍之前提到的 ‘.’ 和 ‘..’ 两个隐藏文件,因为和cd以及tree命令结合起来比较好理解,我们就放在这里进行讲解。所有目录里都有这两个隐藏文件,它们都是目录,其中 ‘.’ 代表的是当前目录, ‘..’ 代表的是上级目录,任何一个目录,即使是空的,系统也要默认给该目录自动生成这两个文件,我们来结合cd和tree来演示一下。
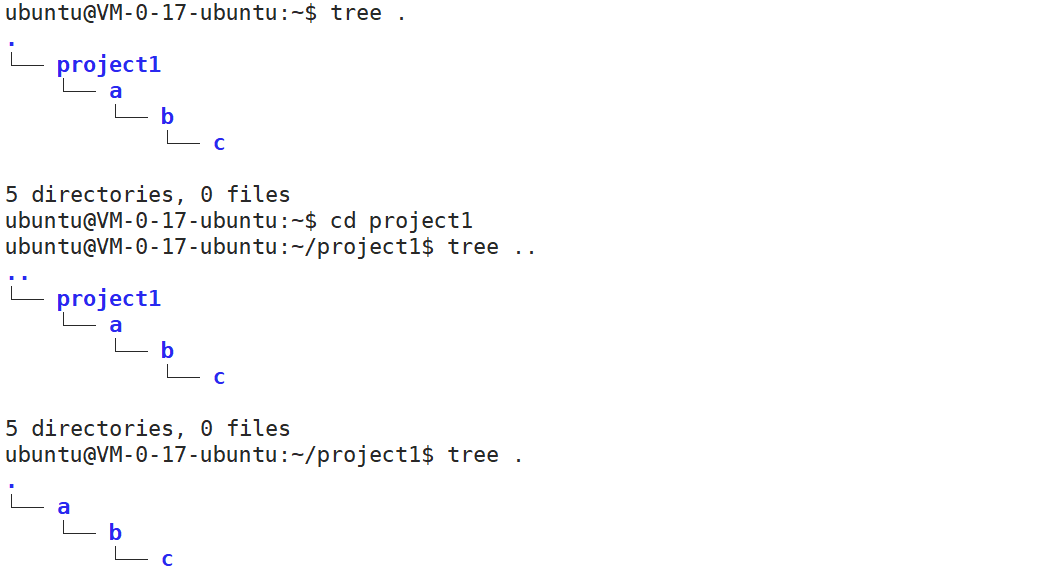
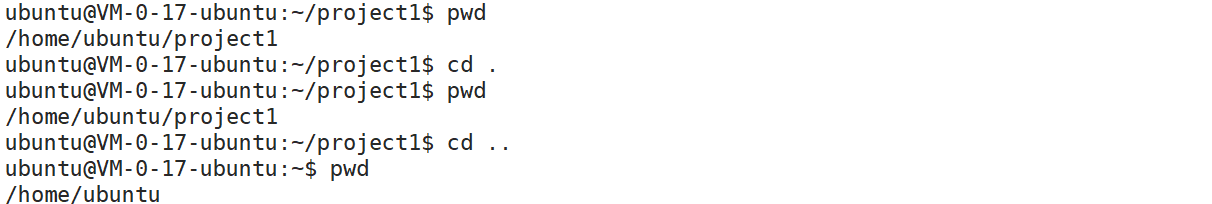
从以上例子我们可以很明显的看出来这两个目录的作用,**cd ..**我们就进入了上级目录,**tree .**就列出了当前文件的树形图。据此,我们可以拓展一个知识,关于Linux系统里面的路径显示,Linux系统里有两种显示路径的方式,一种叫绝对路径,一种叫相对路径。绝对路径指的就是以根目录为参照路径定位一个文件,一般在文件配置中使用的比较多;相对路劲就是以非/为参照位置定位一个文件,一般日常操作用得多,pwd显示的当前所处路径就是绝对路径。

绝对路径
举个例子,我先进根目录,然后再cd绝对路径进入ubuntu,如上所示。然后我在ubuntu里再多创建两个文件,进入project1,再cd ../project2,这行命令意思就是,以上级目录为参照位置定位project2文件,这就是Linux路径表示方式中的绝对路径和相对路径。
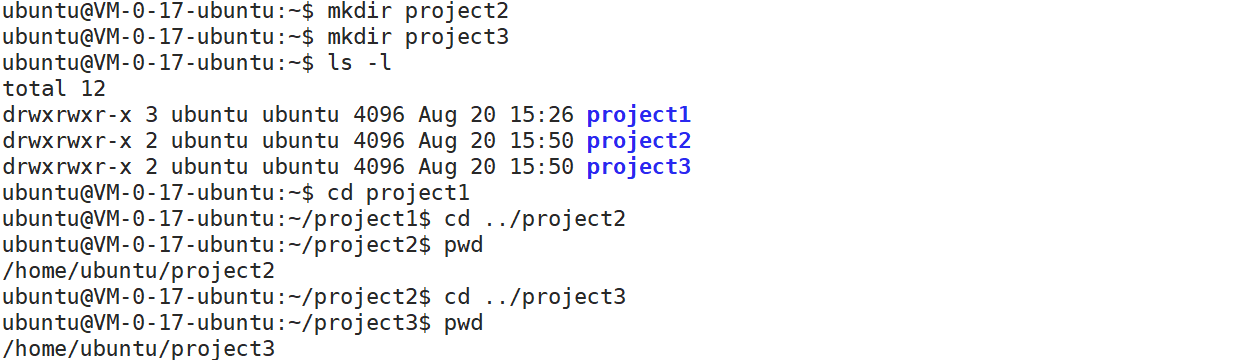
相对路径
6、stat
之前我们知道了ls -l和ll在显示当前目录中的文件时会显示文件的部分属性,stat这个命令可以显示文件更详细的属性。
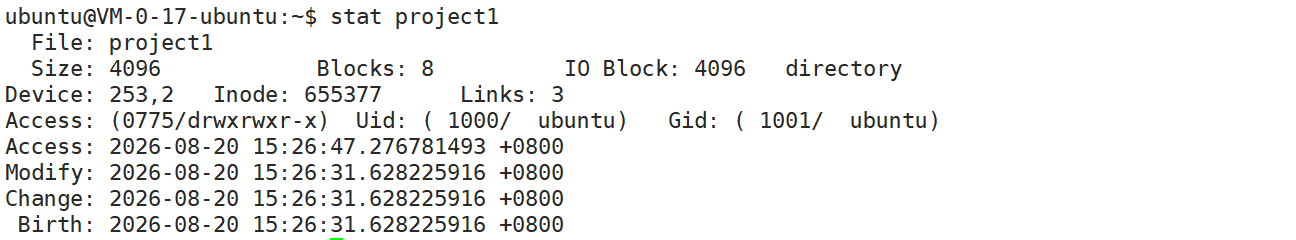
可以看到出现了更详细的文件属性,其中比较显眼的是,这份属性里有四个时间,分别是Access、Modify、Change和Birth,为什么会有四个时间呢?它们又分别代表什么。Access表示文件的最后访问时间,Modify表示文件内容被修改的时间,Change表示文件属性被修改的时间,Birth表示文件诞生的时间。那么为什么需要记录这么多份的时间呢?因为有的时候,我们不仅仅想要获取文件中的内容,我们也想监控文件的状态,比如什么时候被访问了,什么时候被修改了,什么时候创建的。所以这四个时间是文件的重要属性之一。
7、man
man命令是一个对新手很友好的命令,当你有一个命令你不清楚它的功能是什么时,你可以输入man + 命令,这样可以打开Linux中内置的命令手册,并查找手册中对应的命令,里面就会把该命令的所有用法都列出来,假设我现在不懂ls怎么用,或者是想知道它的其他命令行选项,就出现了下面这个界面,在这里就可以看到它的各种用法,然后按q就可以退出
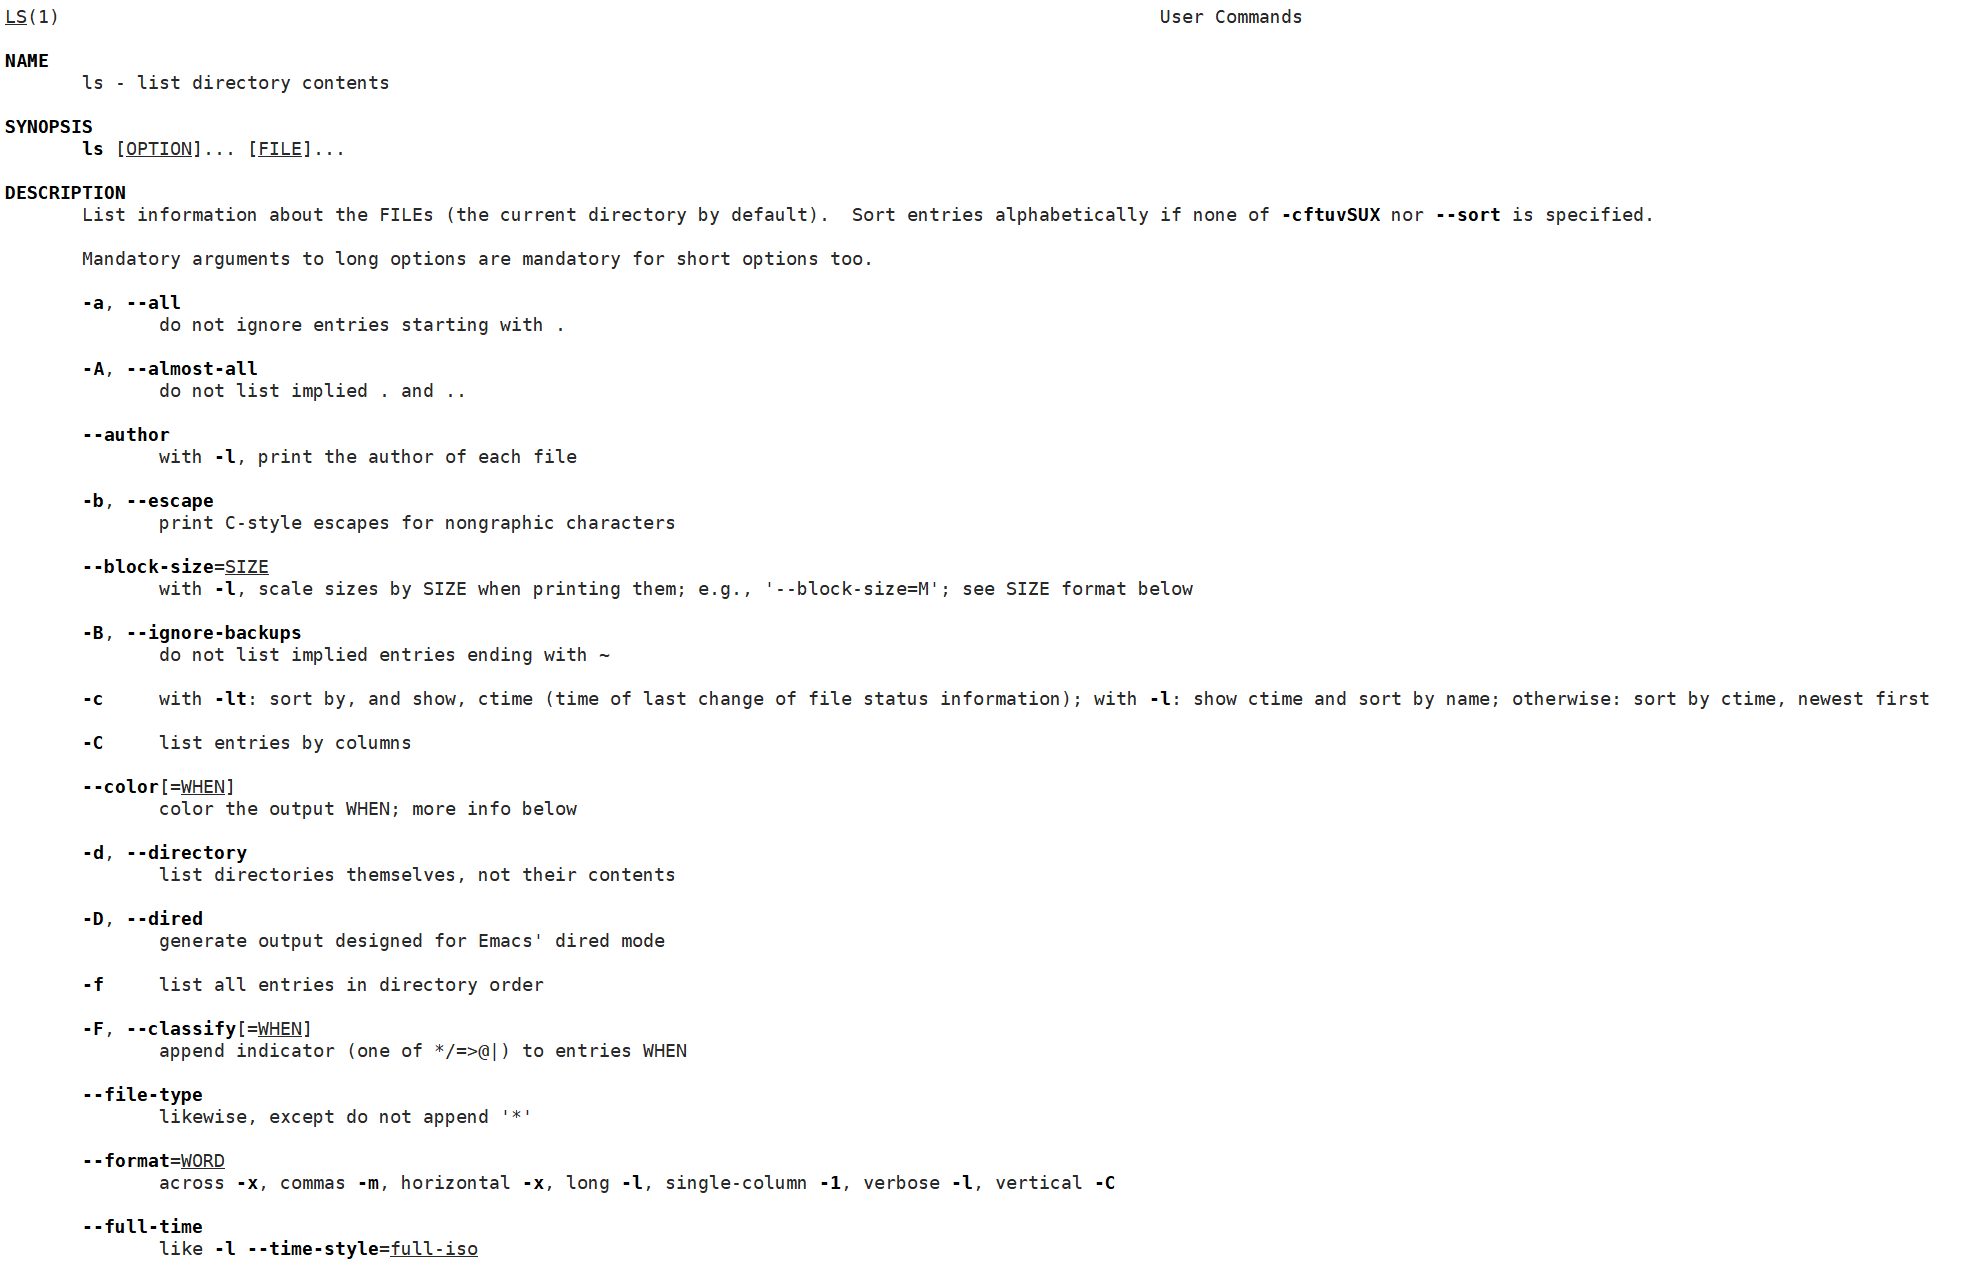
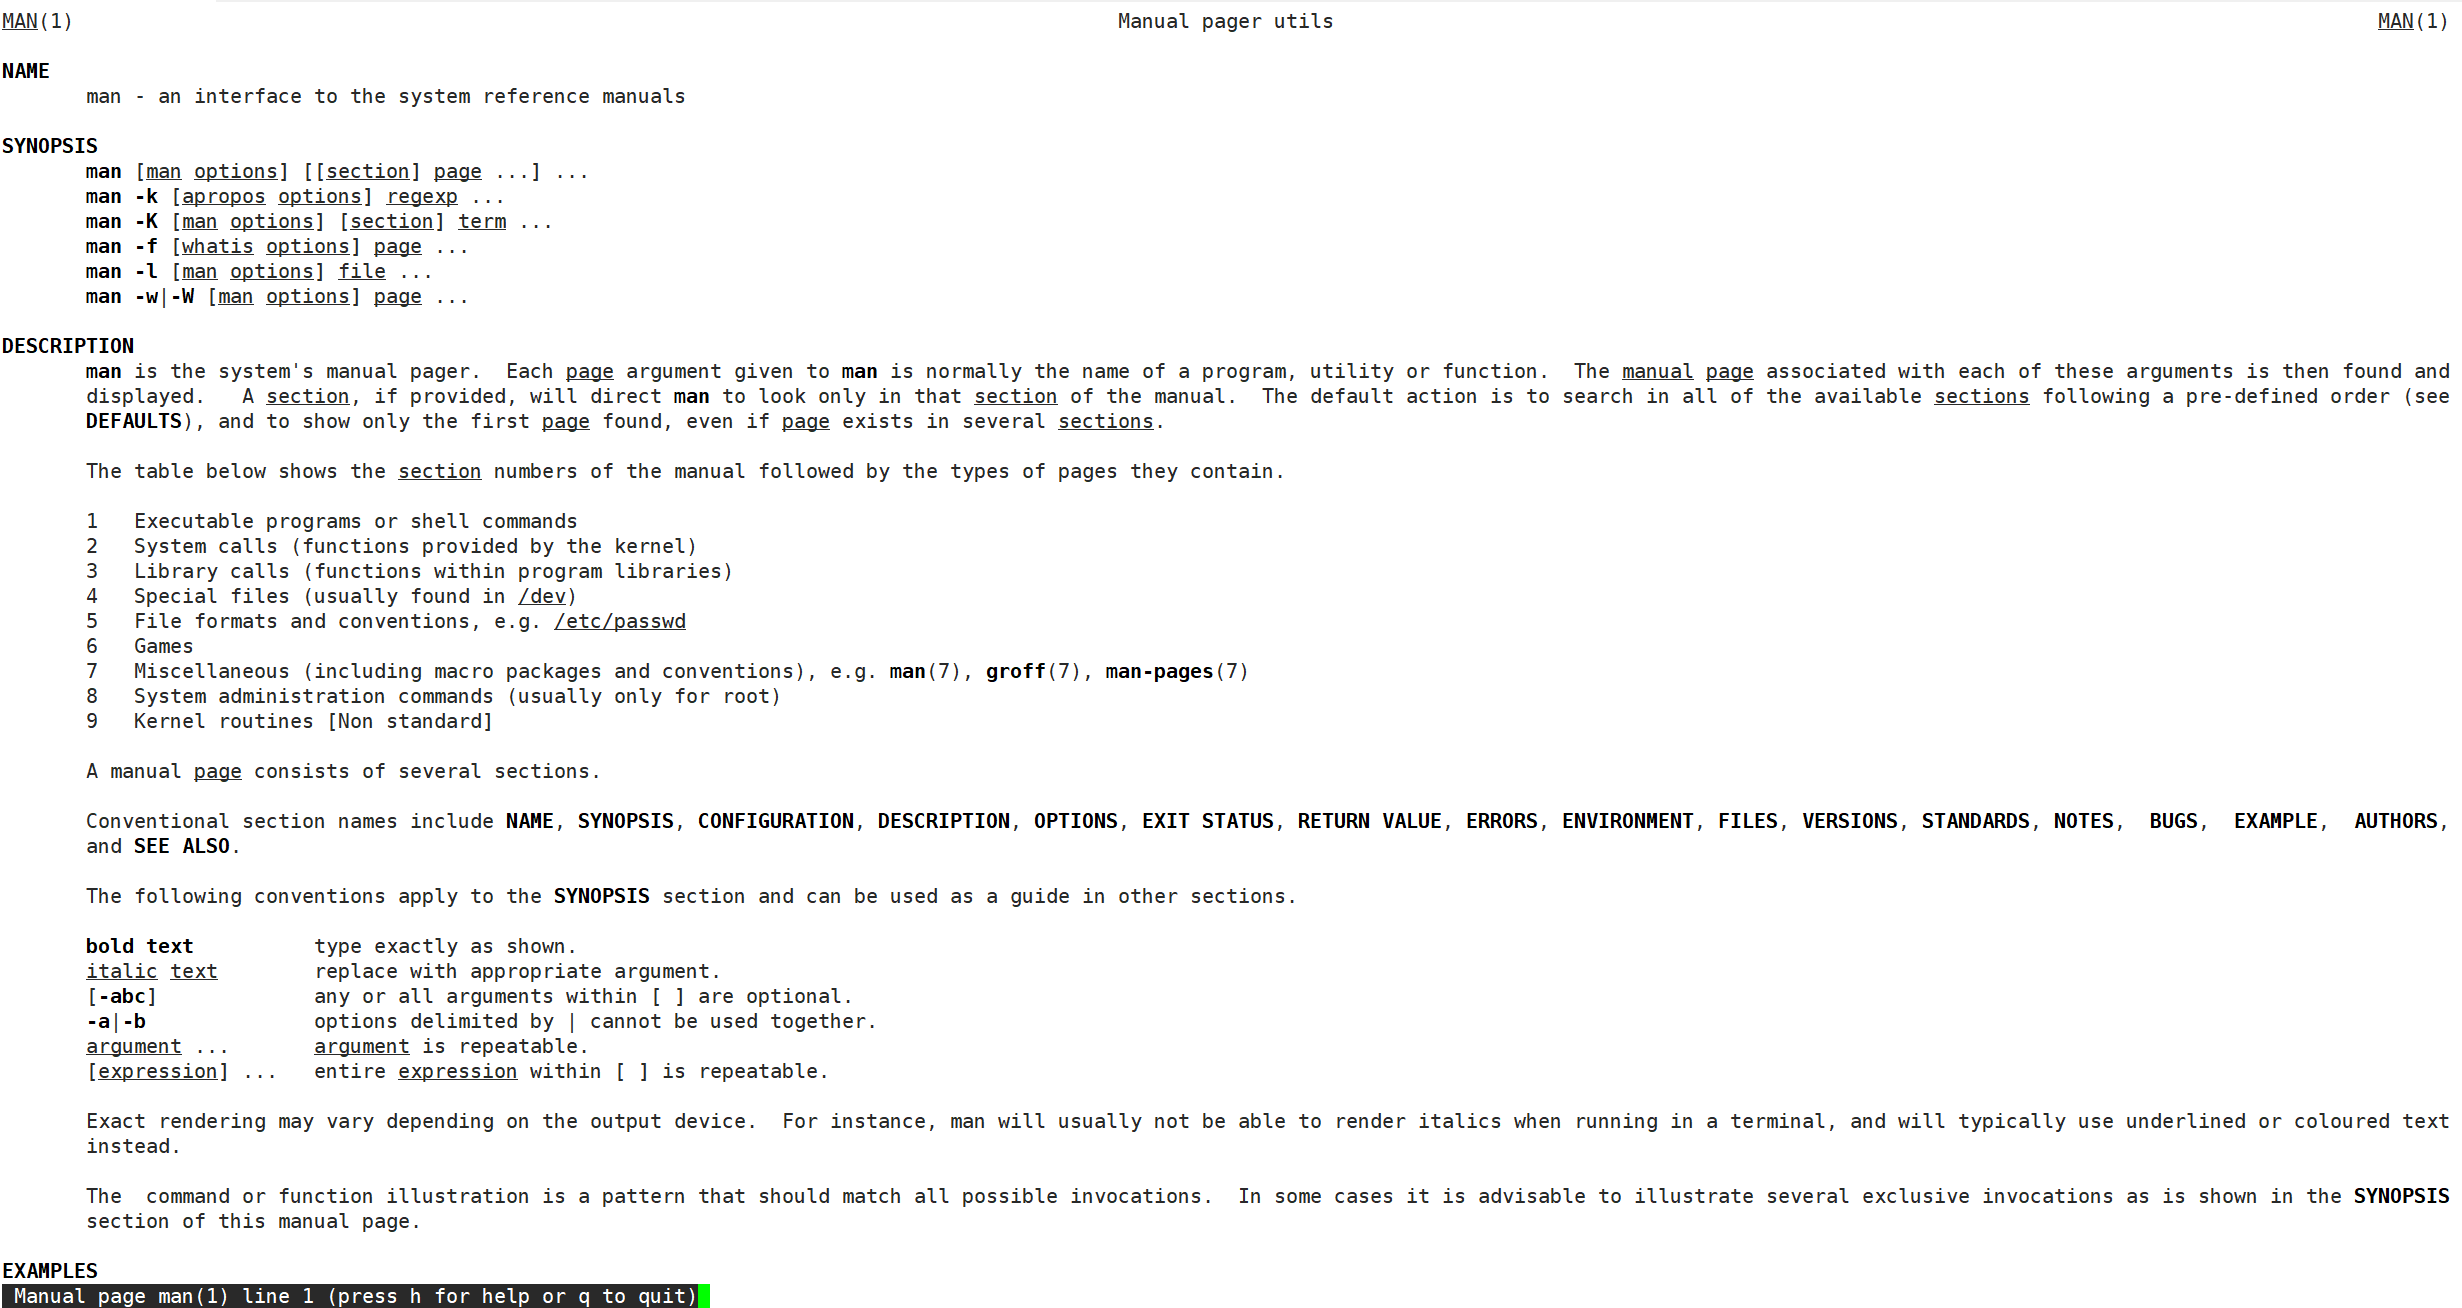
如果你不知道具体要查什么命令,只想打开命令手册,可以直接输入man man,就可以打开命令手册。
8、cp
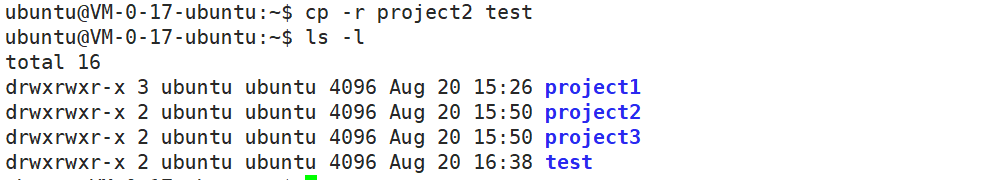
cp,拷贝命令,将一个文件内的内容拷贝给其它文件。同样,cp无法直接拷贝目录,得写成cp -r递归拷贝目录才行,当你的拷贝地点不存在时,系统会自动创建一个跟你给的目标文件名字一样的文件或目录。
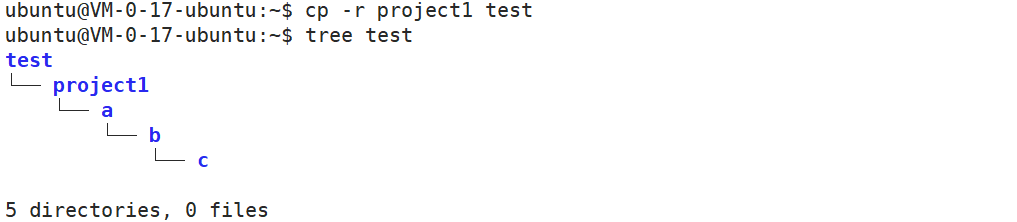
如果拷贝地点也是个目录,就会将起始位置的目录拷贝到目标目录内部。
9、mv
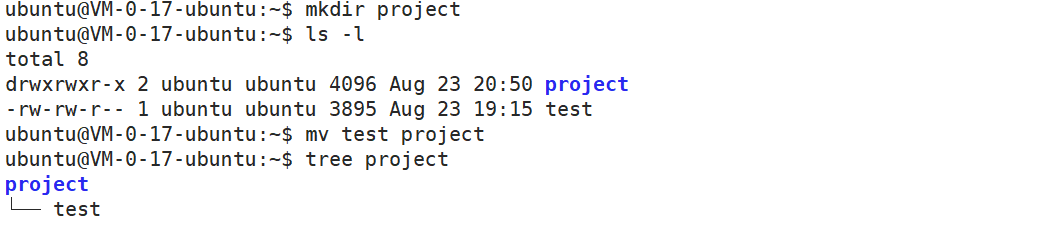
mv主要是用来移动文件或者将文件改名,假设我现在创建了一个普通文件test,我想将它移动到project目录中。
如果想给文件改名的话,也是直接在原文件名后面写上新名字就行了,那么系统如何辨别用户到底是要改名还是剪切呢?如果后面跟的名字是已有的目录名的话,系统就会认定为是剪切,如果后面跟的名字不是已有的目录名,就认定为给文件改名
10、echo
在进入接下来这几个命令的讲解之前,我们需要先来讲解一些Linux的基本知识。首先我们要明确一个概念:在Linux系统中,一切皆文件。这句话的意思就是,在Linux系统里,我们所看到的画面,我们所打的各种命令等,Linux系统将它们都看作是文件,甚至连键盘还有两种显示器都是文件,分别对应stdin、stdout和stderr这三个文件。**所有输入输出操作在本质上就是文件操作。**这两个显示器有什么区别我们以后再说,这篇文章不需要理解。这三个文件是在启动程序时系统就自动帮我们打开了,为了了方便用户在默认情况下就能直接输入和直接显示,方便操作。
接下来开始讲解命令,echo这个命令很简单,它的作用就是将它后面跟着的内容看作字符串并将字符串写入文件中。根据我们对echo命令的学习,我将引入一个拓展操作来证明我上文引入的概念,这个操作的名字叫做重定向操作。

我们看上面echo命令的执行结果好像和我讲的有一点出入,它直接就在终端显示出来了,此时如果我将这个输出操作重定向一下。

输出重定项的符号就是 ‘>’ ,可以看到我给echo加上输出重定向后,这回并没有直接在终端中显示,而是将其写入了test文件内,通过这个例子就能很明显的看出来,我们现在看到的终端界面实际上也就是一个文件,在我们没有进行重定向时,echo默认就是写入终端文件中。终端的文件名称是 /dev/pts/xxx 。
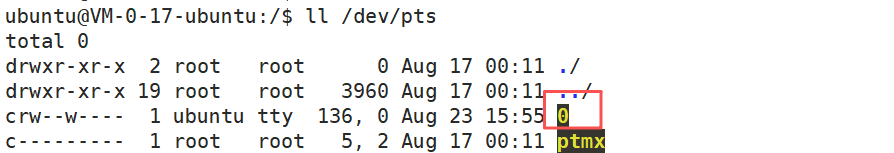
这个0就是我当前所处的终端,那么我们能不能做到往其他终端内写入呢?毕竟本质都只是文件,我们来新打开一个终端看看。可以看到,当我们新打开一个终端时,出现了一个新文件‘1’,这个‘1’就是我们打开的新终端。
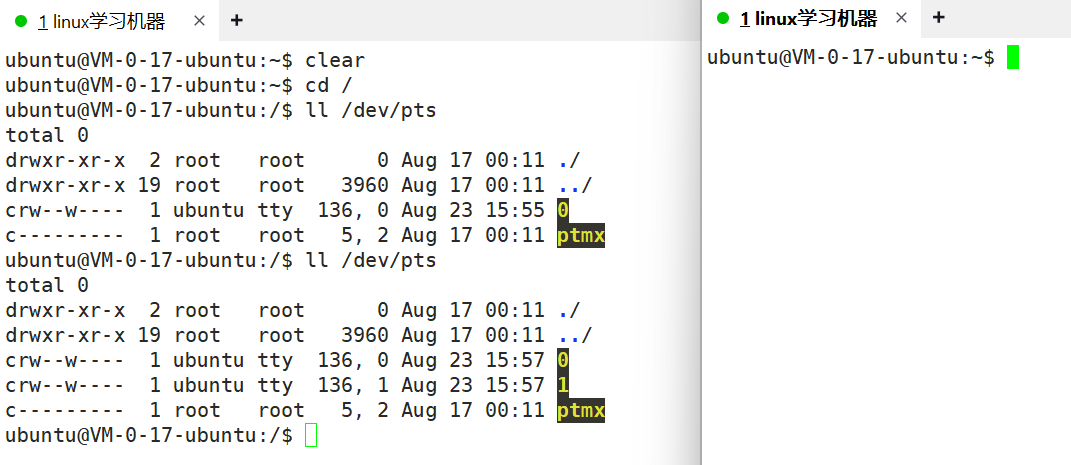
我们现在试试往里面写入。可以看到我们也是成功往1号终端中输出了字符串。

关于终端也是文件的概念我们已经讲完了,关于重定向操作我们还有一些需要补充的内容。我们多运行几次输出重定向就会发现,每一次重定向都会将文件清空,然后才往里面写入。此外,如果我们要写入的文件不存在,它会怎么做呢?
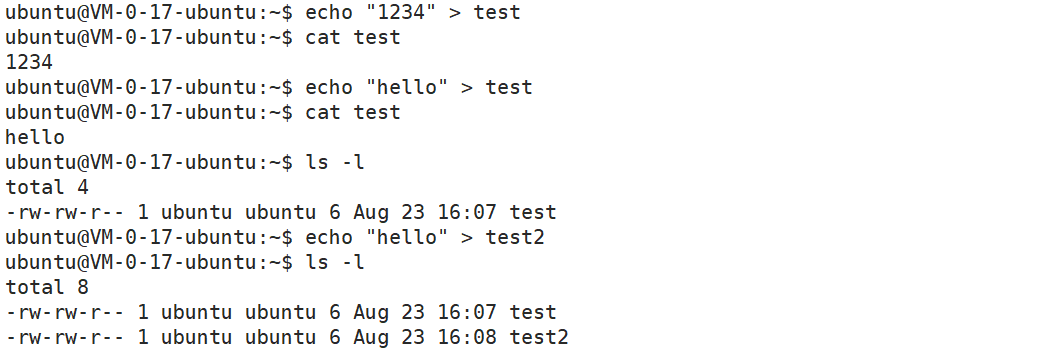
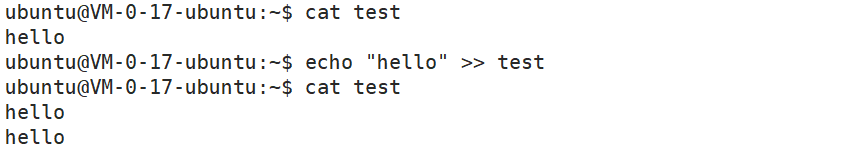
根据演示我们可以总结出输出重定向的两个特点:1、如果后续文件不存在,就新建一个;2、先清空文件再写入。那如果我不想它每次都清空文件,我想接着写入怎么办?这时候只要多打一个 ‘>’,就会变成追加重定向,在原先的文本后面接着输入。
11、cat
在上面对echo指令的学习中,大家其实也应该看出来cat的作用是什么了,就是将文件内的文本打印到显示器。但此外,cat这个命令还有一些知识我们需要学习。首先,cat如果后面不接文件名的话,就默认直接从键盘文件里读取内容,再写到显示器文件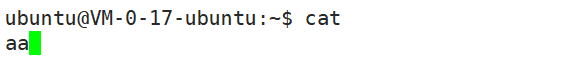
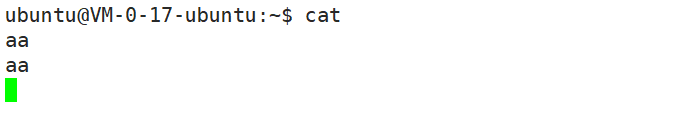
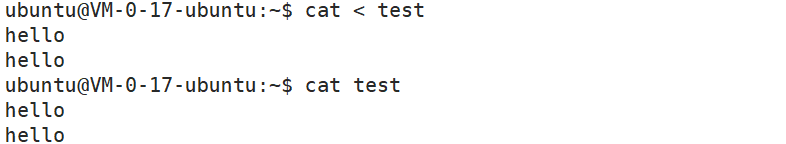
可以看到,我们先输入aa,再点击回车,就自动帮我们打印一行aa,如果想要退出的话,只要点ctrl + c就行了。此外,cat也是可以进行重定向的,在cat后加上 ‘<’,再加文件名就是输入重定向了,虽然它们两个的结果看上去是相同的,但它们的内部逻辑其实不一样,不加重定向符时,是cat自己打开文件进行打印,加上重定向符时,则是shell,也就是命令行解释器打开文件,再通过stdin交给cat。shell的具体概念我们之后再来进行讲解。
12、which
在上面对echo和cat的学习中,我们已经了解了:在Linux系统内,一切皆文件,也证明了终端实际上也是文件。显然,命令肯定也是文件,命令的本质其实就是一个个在Linux系统中封装好的可执行文件,其实也就等价于我们平常写的C/C++程序。which这个命令的功能就是查找命令的可执行程序所在的路径。

我们可以看到,其实ls就是在bin目录里的一个可执行文件,我们平常用的所有命令都是被存在这个目录里的。
13、more/less
当我们想打印大量内容时,很容易出现一个屏幕打不下的情况,要如果我想看的是最上面几行的文本,就得往上划很长时间,很不方便。而more的作用就是,在打印过多的内容时,它默认只打满一屏幕的内容,按回车可以进行逐行下翻。假设我现在在test里输入了大量内容,然后用more打印。

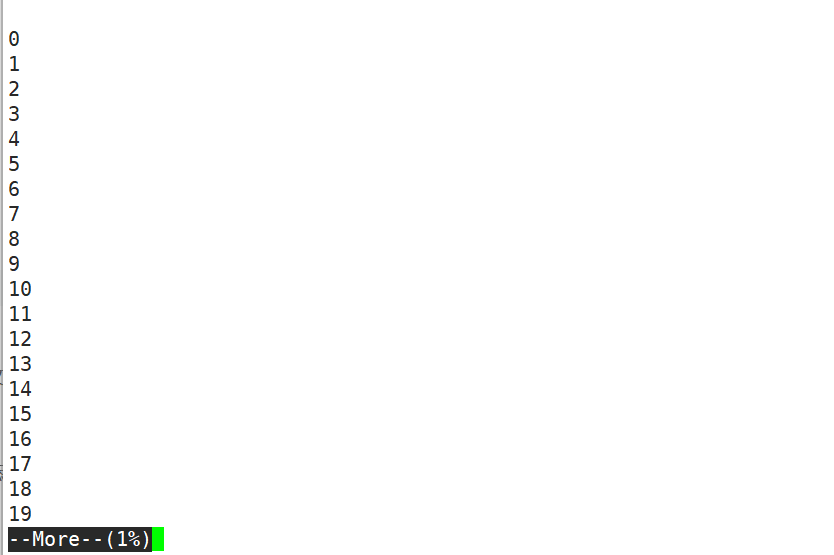
但是要注意的是,more只能进行下翻而不能进行上翻,翻过了就是翻过了。而less的功能与more几乎完全一样,但是less不仅能上翻,还能进行下翻,而且只用滑动鼠标滚轮就可以进行上翻下翻,所以一般只推荐用less,不推荐用more。如果想退出的话,按q就行了。
14、head/tail
head和tail这两个命令,一个的功能是,只打印开头n行的内容,tail是只打印结尾n行的内容,具体用法如下所示
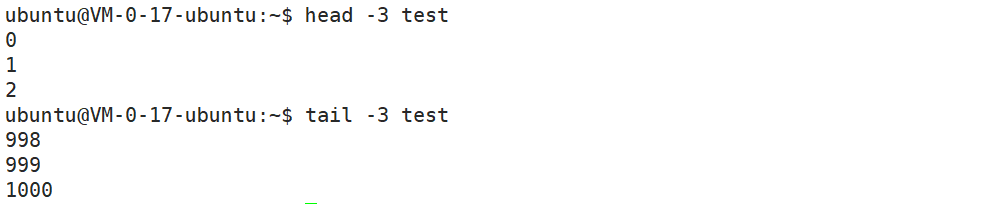
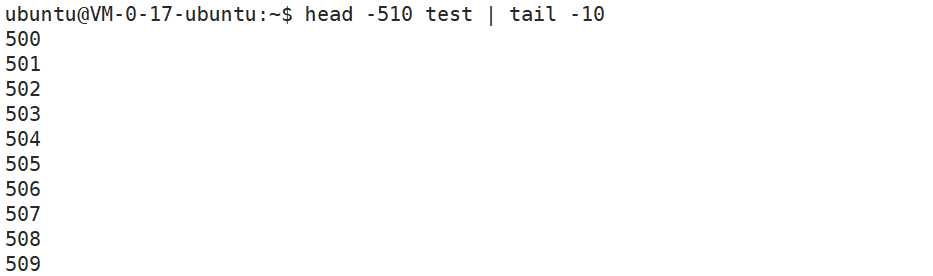
这样就显示出了前三行和后三行的内容,那如果我想看中间几行的内容呢?假设我现在想看第500到第510行的内容,我们可以使用 ‘ | ’,这个符号来进行对命令的级联,‘ | ’是管道符号,它相当于直接将前段命令的输出结果(stdout)当成输入(stdin)传给后段,就比如说下面这个例子。之前我们的tail是读取test文件的后十行,现在变成head先读取test文件的前510行,然后将其传给tail,tail再从这510行里读取后十行。
15、date
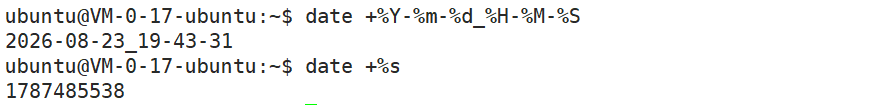
date相信很多人看名字就能猜出来,这就是一个用于打印时间的命令,注意大小写一定要打对,中间的分隔符没有要求,怎么写都可以。如果单独只打date +%s的话,打印的是格林威治时间戳。
16、grep
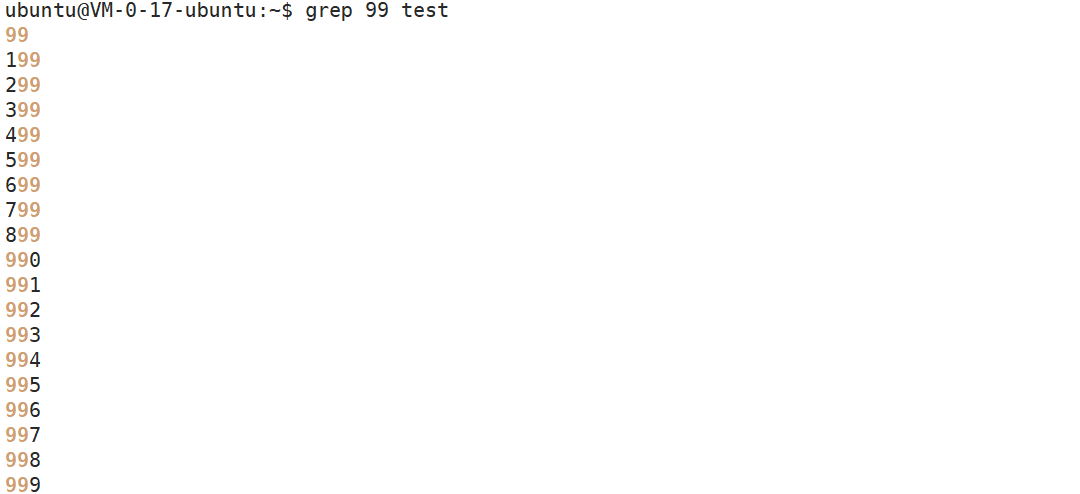
grep这个命令可以看作是一个行文本过滤工具,可以帮用户把包含某些关键字的行筛选出来,就拿刚刚的test文件举例,我想检索所有含有‘99’的行。
除此之外,grep还有几个比较好用的选项, -n可以将筛选对象的行号一起打印出来; -v可以反向筛选,将匹配成功的去掉,匹配失败的留下; -i可以忽略大小写。
17、zip/unzip/tar
在讲解这几个命令之前,我先来介绍一下打包和压缩的区别,打包是将文件合并,主要目的是防止文件丢失,压缩则是将多个文件压缩为一个文件,减少体积,节省存储空间,可以有效减少网络传送的时间。
zip和unzip这两个命令分别是压缩和解压文件,不过这个命令Ubuntu系统是不自带的,需要自己输入sudo apt install zip unzip来下载。
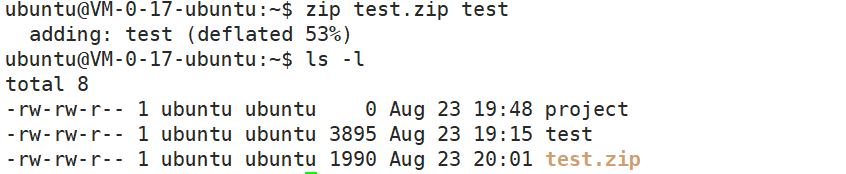
可以看到,在输入命令后,目录中成功出现了test的压缩包。需要注意的是,zip只能压缩你给的文件本身,也就是说如果你想压缩的是一个非空目录的话,目录中的其他文件是不会被一起压缩的。如果想整个目录一起压缩的话,就要写成zip -r,递归地将整个目录压缩。解压的话直接使用unzip + 压缩包名就可以直接原地解压。
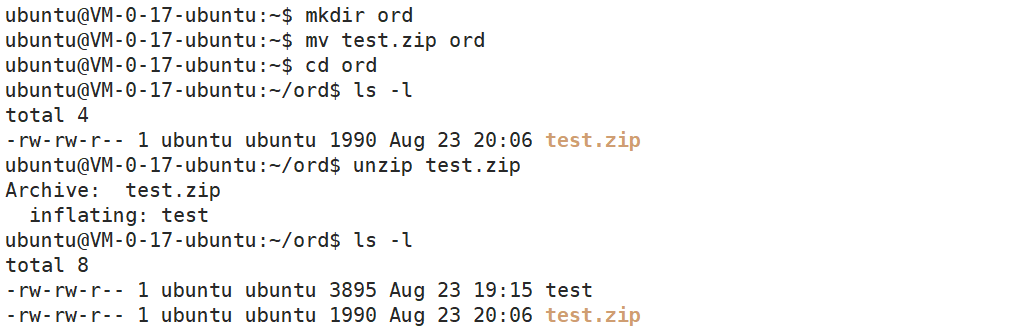
如图所示,test.zip直接在ord目录里原地解压,那如果想解压到其他文件怎么办?也有办法,假设我现在想将它解压回家目录,先将家目录里的test删掉,方便观察。
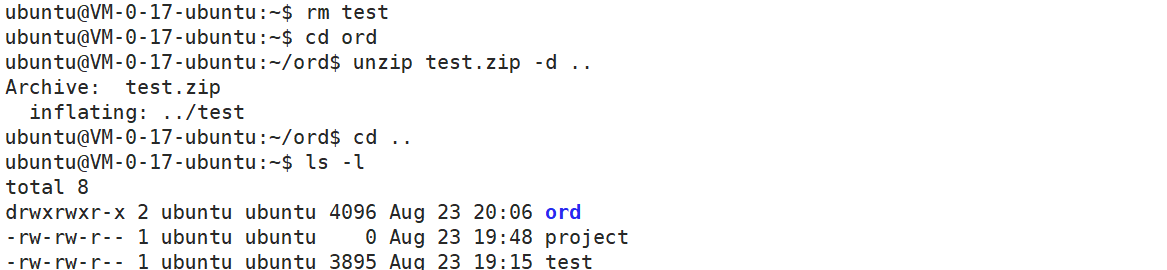
可以看到只要在文件名后加上-d再加上目标目录名就可以解压到对应目录内。还有一个重要的知识点,Linux和Windows系统的压缩包是可以互传的,只要使用sz/rz就可以进行互传。
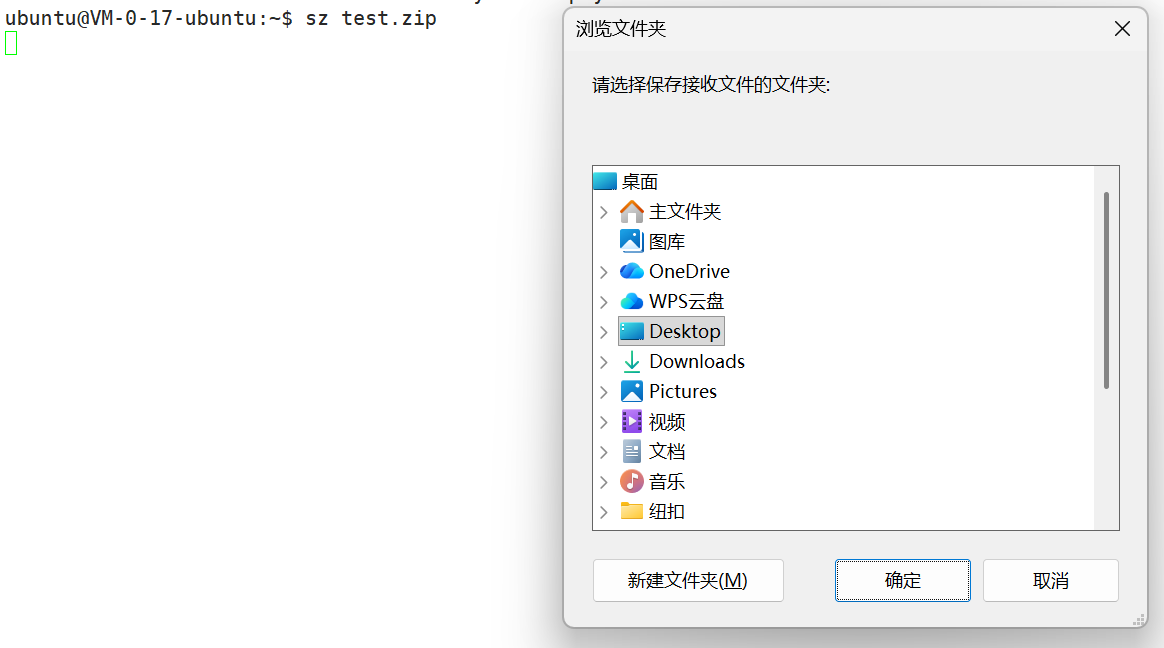
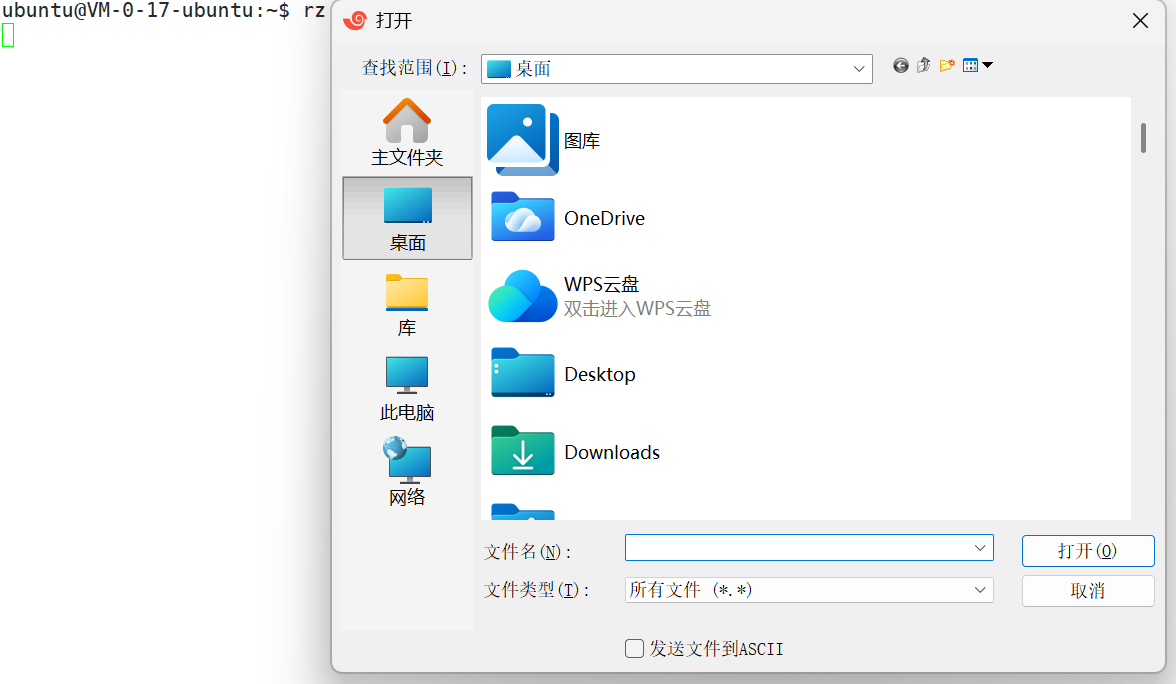
在输入sz 加压缩包名后,就会自动唤起这个选择文件夹的窗口,就可以将该压缩包传到任何文件夹内了。同理,输入rz就可以直接唤出窗口,选择要传进来的压缩包。
压缩包不仅可以支持Linux和Windows之间的互传,也支持Linux和Linux之间的互传,具体写法是scp xxx.tgz 用户名@公网IP:传输路径,由于我没有两个服务器我就不做演示了
zip和unzip对应的压缩和解压讲完了,接下来的是tar,也就是打包,与zip不同的是,tar命令不用进行递归,因为它本身就具备打包功能,可以直接帮用户将整个目录内的所有内容打包后再进行压缩。
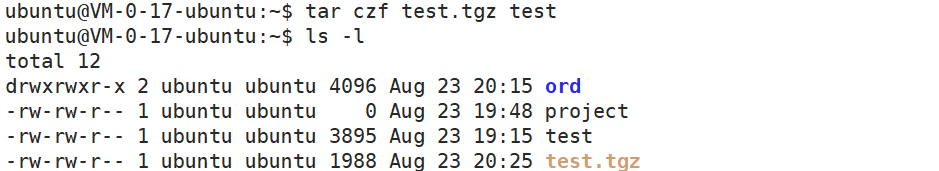
压缩
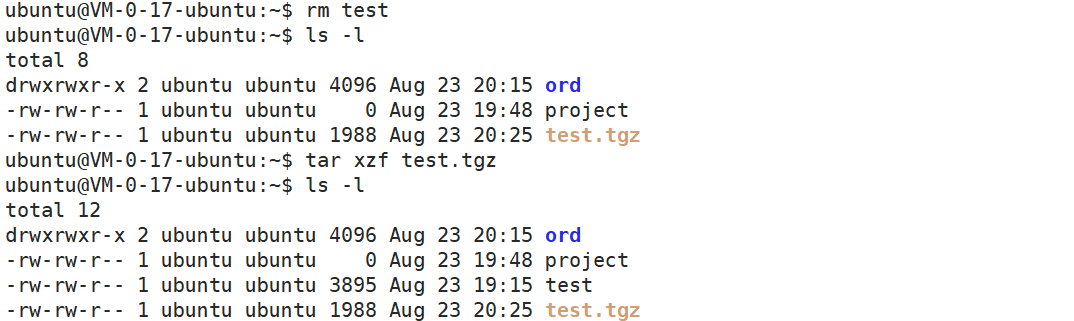
解压
tar还有一个和zip不同的地方是,当你想将其解压到其他目录下时,不再是使用-d,而是使用 -C。
二、shell(命令行解释器/外壳程序)
我们在Linux系统中输入命令时,命令并不是直接传递给Linux系统内核进行执行的,而是要先经过外壳程序(shell)。那么为什么要有这一层外壳程序呢?
首先,我们平常输入的这些命令其实Linux系统的内核是无法理解的,我们输入的命令先进入外壳程序,外壳程序将它们转化成内核能够理解的语句,再将它们传给内核,内核根据语句执行完后,将执行结果传给外壳程序,外壳程序将执行结果转化为具体的文字给用户看。所以,外壳程序的第一个用处就是,方便用户进行操作。我们上面所讲的各种重定向操作,管道等都是通过外壳程序来实现的。
其次,如果用户在输入命令时,输入了很多错误的命令甚至是很严重的错误命令,外壳程序会将这些错误命令退回,保证这些错误命令不会影响到Linux的内核。所以外壳程序的第二个作用就是保护内核。
Ubuntu中的外壳程序叫做bash,当我们输入错误指令时,有时候就可以看到以bash开头的报错。
总结
今天,我们学习了Linux系统中的各种常见指令,了解了外壳程序的定义和功能。其实本节课学习的重点并不在于这些基础的命令,因为在我们后面漫长的学习中,这些都是最基础的,重要的是我们要通过对这些基础命令的学习,了解Linux的底层结构和运行原理,这些才是我们这节课需要进行掌握的。
《Linux第一课:Linux的基本命令和底层结构的理解》 是转载文章,点击查看原文。


