目录
MAC地址
一、MAC地址的格式特征
二、MAC地址的获取
三、什么是ARP?
四、ARP缓存
五、RARP
IP地址
一、为什么要有IP地址?
二、既然IP地址存在,那它的意义是什么?
三、那又如何表示呢?
1、IP地址的定义
2、IPv4地址的表示方法
2.1、IPv4地址的分类编址方法
2.2、IPv4地址的划分子网编址方法
2.2.1、为什么要划分子网?
2.2.2、怎么划分子网?
2.2.3、总结
2.3、IPv4地址的无分类编址方法
3、构造超网
3.1、需求分析
3.2、路由聚合
3.3、如何判断子网还是超网
结语
在上节中,我们讲解了计算机网络的组网模型,那么这次,我将会在此基础上进行MAC地址与IP的讲解。
(此系列目前会用到软件Cisco Packet Tracer,若有需求请移至此系列第二篇博客进行下载。)
MAC地址
一、MAC地址的格式特征
● 每一个网卡都有一个6字节(48bit)的MAC地址(Media Access Control Address),MAC 地址的结构如下:
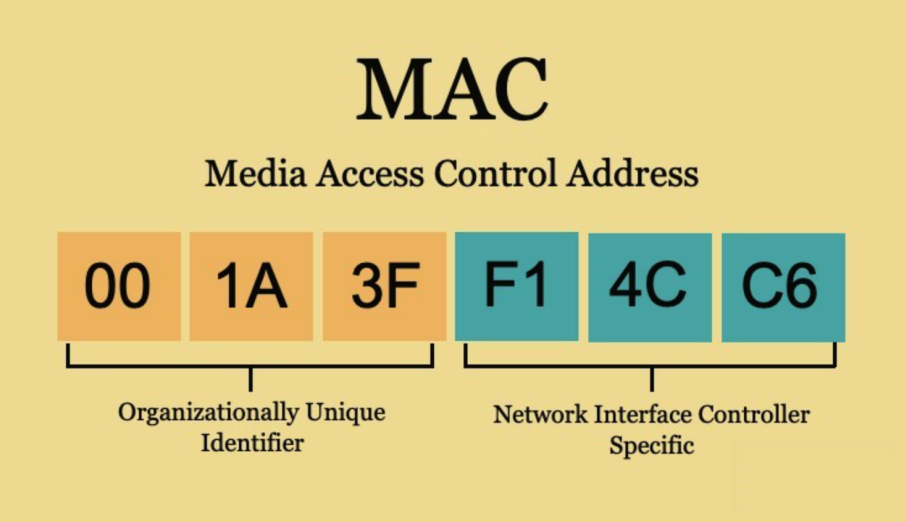
根据图片我们也能看出,前三个字节是OUI(组织唯一标识符)由IEEE的注册管理机构分配给各厂商,而后三个字节则是由厂商自己去分配。
● OUI查询
○ https://standards-oui.ieee.org/oui/oui.txt
我们可以去查询自己的MAC地址,并在此处进行验证。
不过有一点需要强调下:
MAC地址确实是唯一的,但即使现在有两个人的MAC地址都改为一样的了,只要这两个人不在一个局域网,那么就不会出现问题,这部分的原因主要是,在路由器的发送端和接收端也有两个MAC地址,这两个MAC地址肯定是不会相同的,那么就会避免这种冲突行为,从而使其正常通信。
● MAC地址的表示格式
○ Windows: xx-xx-xx-xx-xx-xx
○ Linux、Android、Mac、iOS: xx:xx:xx:xx:xx:xx
○ Packet Tracer: xxxx.xxxx.xxxx
○ 当48位全为1时,代表广播地址: FF-FF-FF-FF-FF-FF
各厂商虽然表达MAC地址的格式不同,但均是6字节大小
二、MAC地址的获取
● 当不知道对方主机的MAC地址时,可以通过发送ARP广播获取对方的MAC地址
○ 获取成功后,会缓存IP地址、MAC地址的映射信息,俗称:ARP缓存
○ 通过ARP广播获取的MAC地址,属于动态(dynamic)缓存
■ 存储时间比较短(默认是2分钟),过期就自动删除
● 相关命令
○ arp -a [主机地址]: 查询ARP缓存
○ arp -d [主机地址]: 删除ARP缓存
○ arp -s 主机地址 MAC地址:增加一条缓存信息(这是静态缓存,存储时间较久)
我们不妨在我们的软件中,试一下瞅一瞅
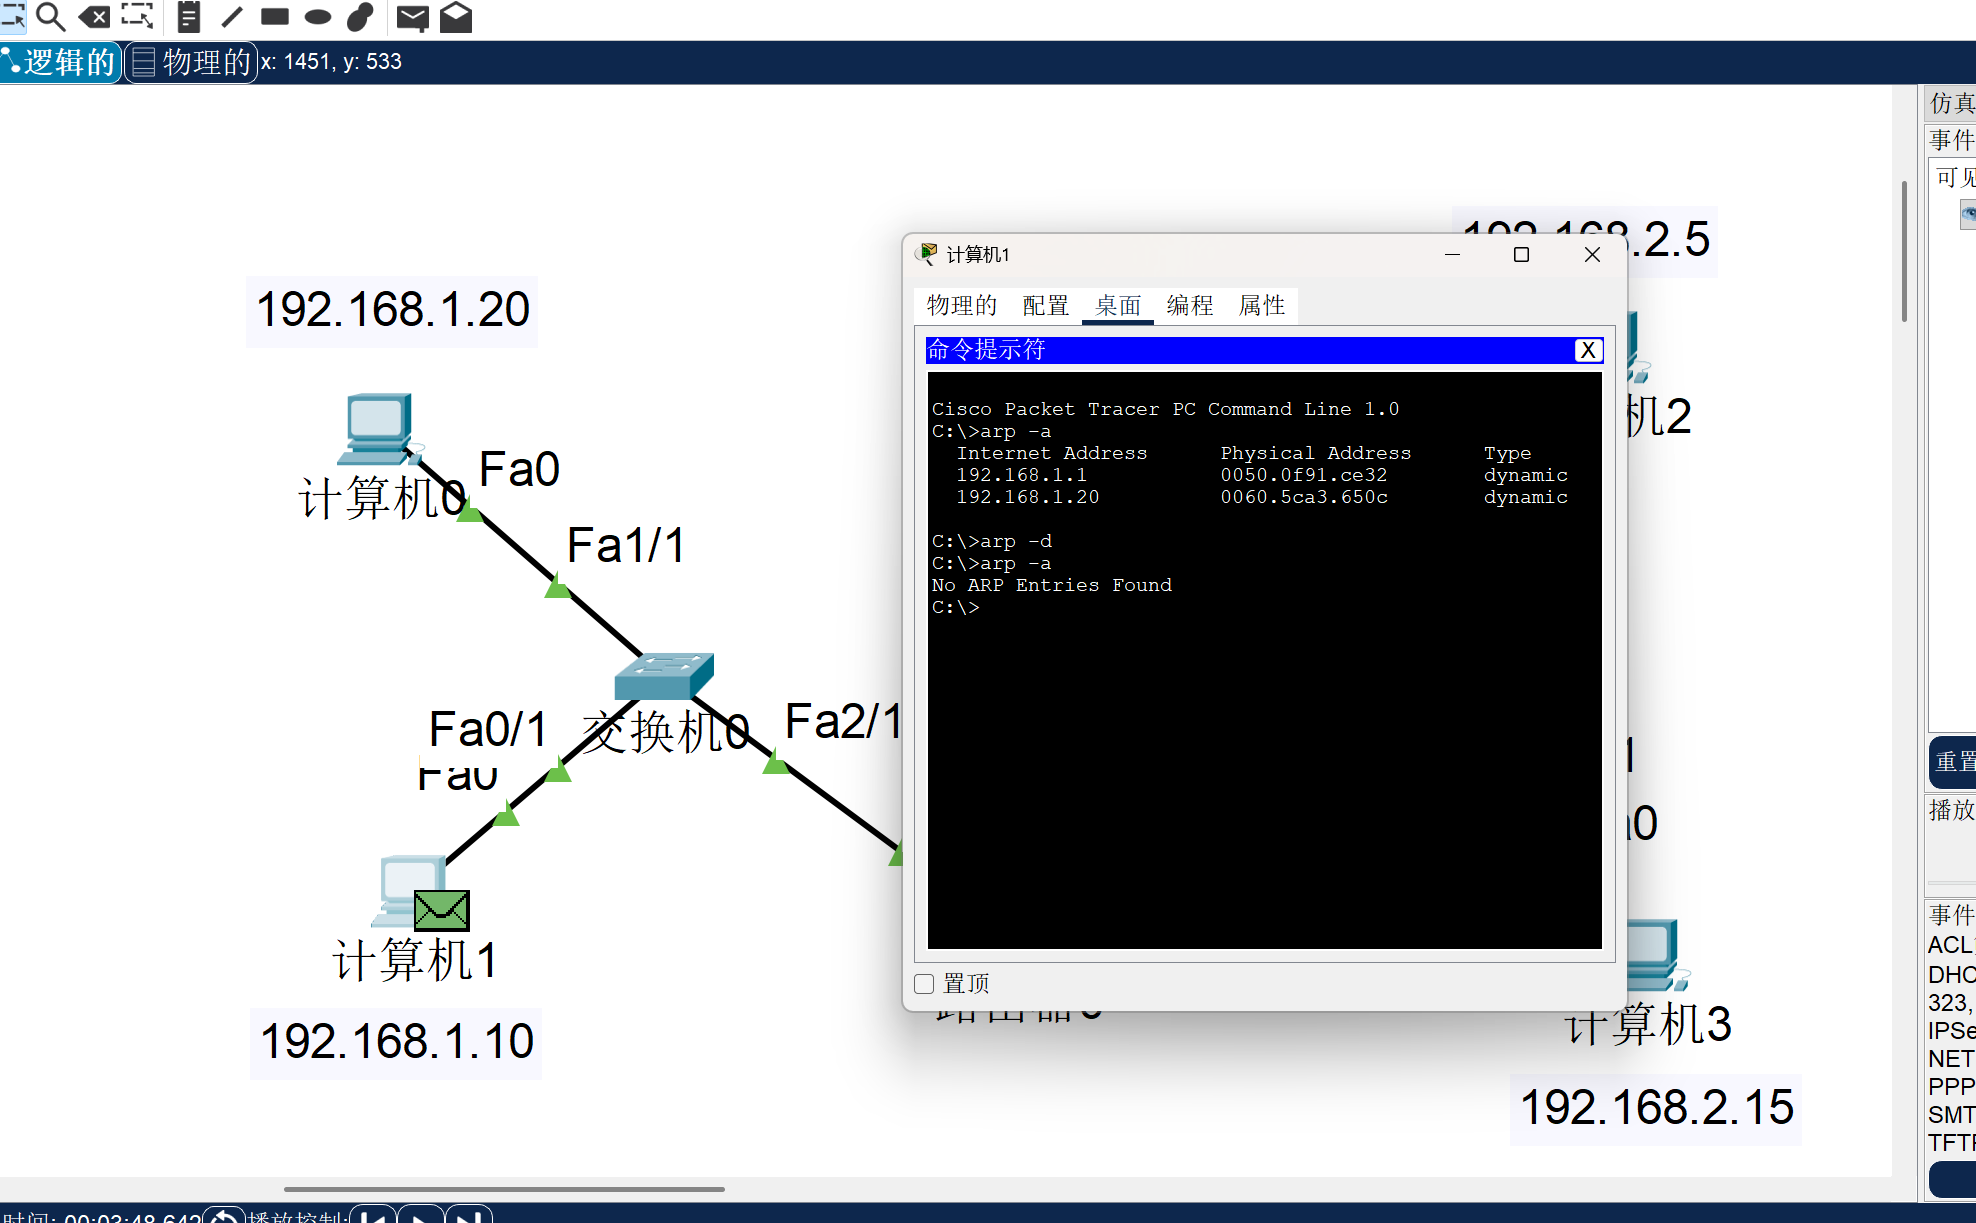
可以看到,我们的计算机1现在有着路由器的网关IP及其MAC地址和计算机0的IP和MAC地址,然后我们用删除命令进行删除就没有任何ARP了(此软件上的机器不支持指定主机地址的ARP查询,感兴趣的可以试试你们自己的)。
三、什么是ARP?
考虑到上篇目已经将ARP的原理讲的差不多了,这次只用文字和图片带大家再捋一捋思路。
ARP协议的全称是 Address Resolution Protocol(地址解析协议),它是一个通过用于实现从 IP 地址到 MAC 地址的映射,即询问目标 IP 对应的 MAC 地址 的一种协议。ARP 协议在 IPv4 中极其重要。 下面我们再来看一下 ARP 的工作机制是怎样的。
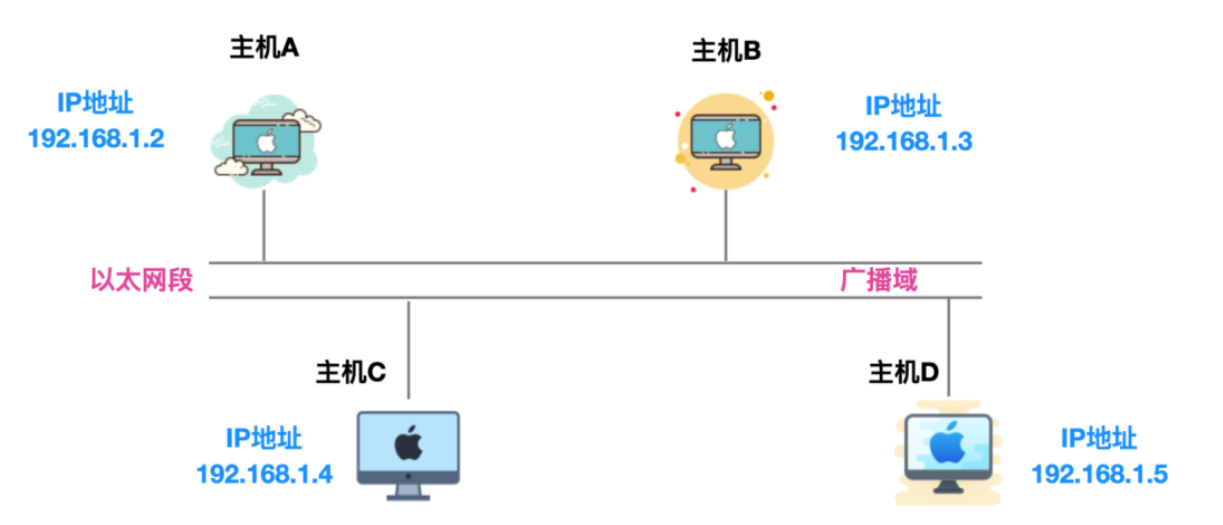
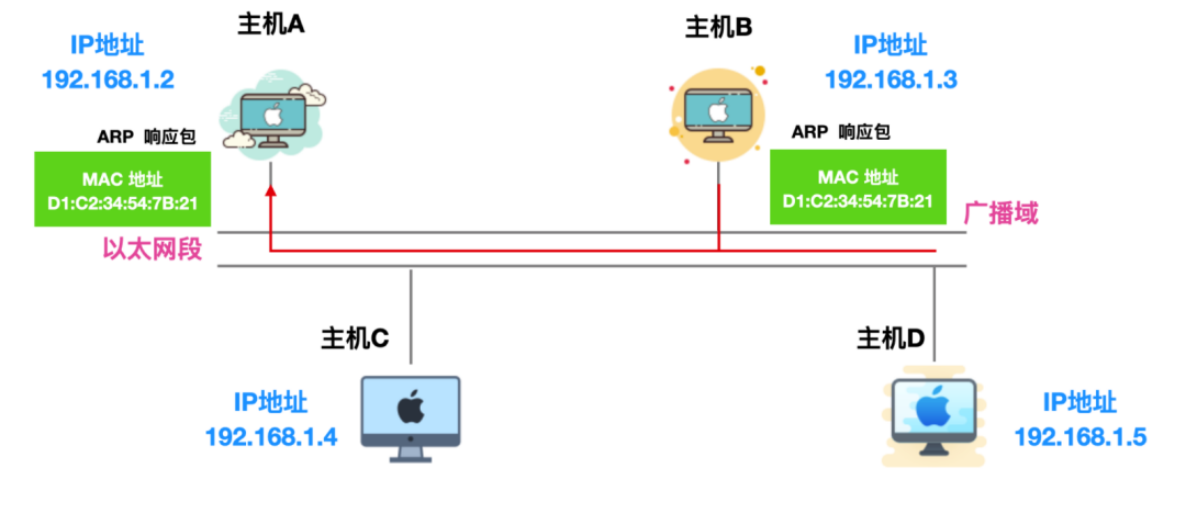
假设 A 和 B 位于同一链路,不需要经过路由器的转换,主机 A 向主机 B 发送一个 IP 分组,主机 A 的地址是 192.168.1.2 ,主机 B 的地址是 192.168.1.3, 它们都不知道对方的 MAC 地址是啥,主机 C 和 主机 D 是同一链路的其他主机。
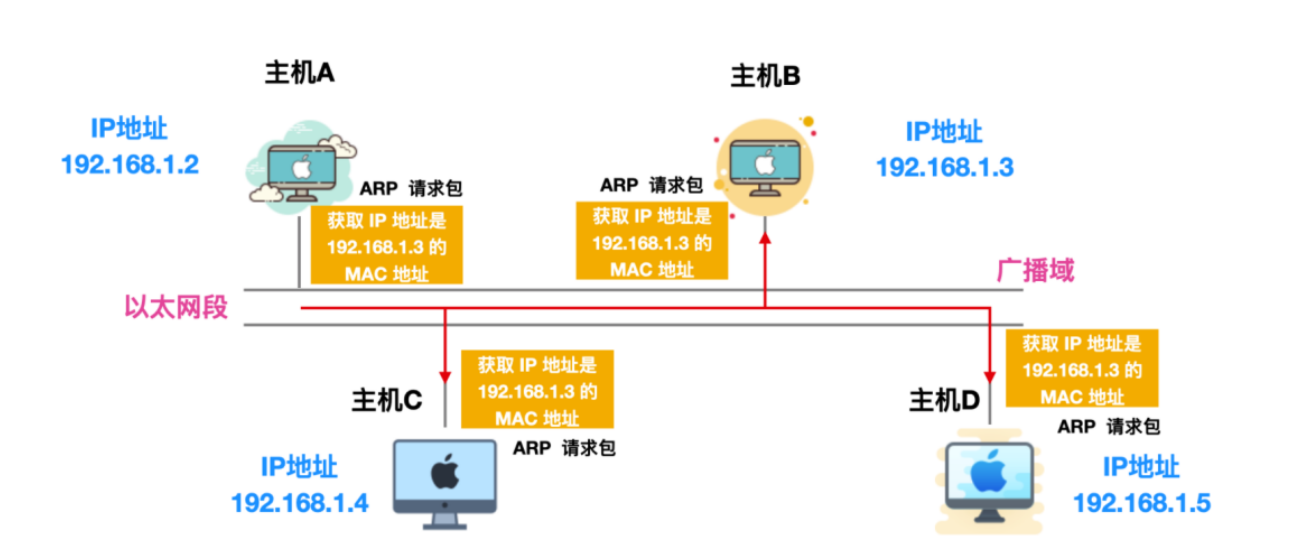
主机 A 想要获取主机 B 的 MAC 地址,通过主机 A 会通过广播的方式向以太网上的所有主机发送一个 ARP 请求包,这个 ARP 请求包中包含了主机 A 想要知道的主机 B 的 IP 地址的 MAC 地址。
主机 A 发送的 ARP 请求包会被同一链路上的所有主机/路由器接收并进行解析。每个主机/路由器 都会检查 ARP 请求包中的信息,如果 ARP 请求包中的目标 IP 地址和自己的相同,就会将自己主机的 MAC 地址写入响应包返回主机 A。
由此,可以通过 ARP 从 IP 地址获取 MAC 地址,实现同一链路内的通信。
四、ARP缓存
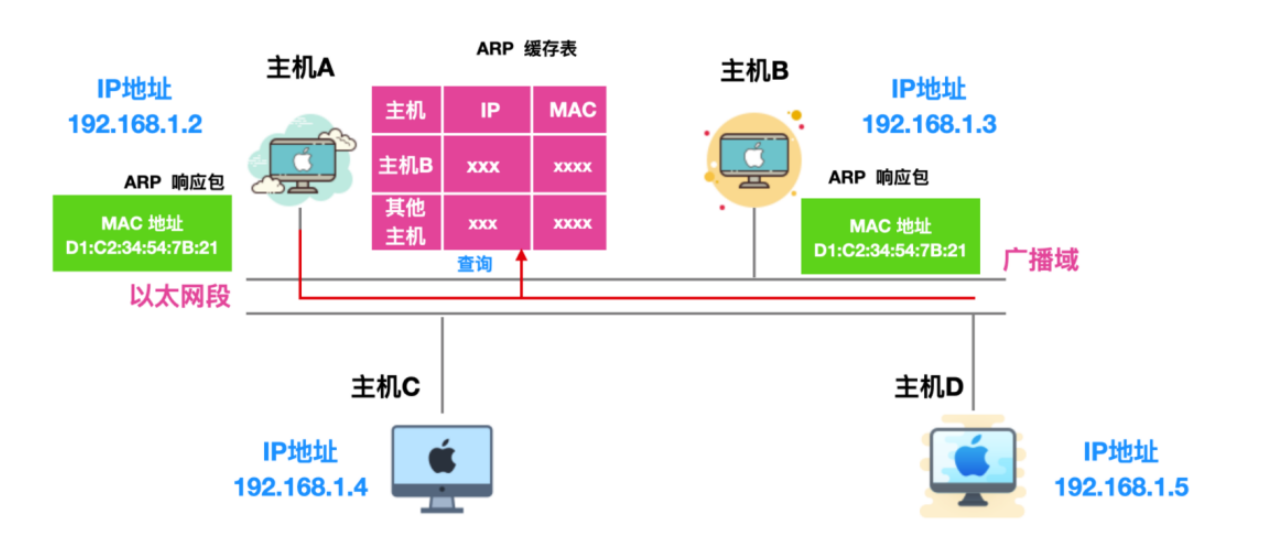
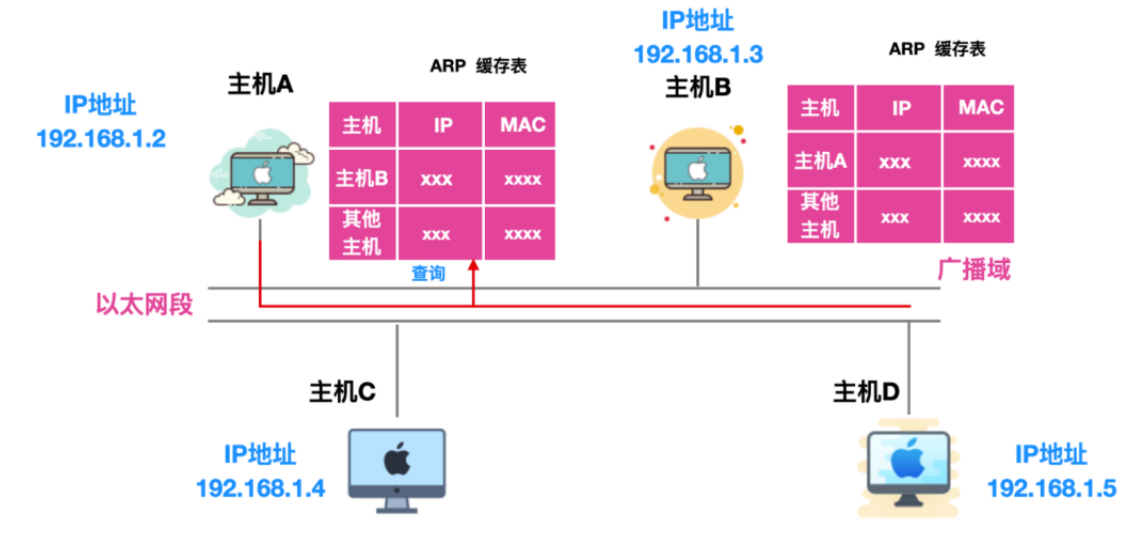
● 通过 ARP 缓存,降低了网络流量的使用,在一定程度上防止了 ARP 的大量广播。
一般来说,发送过一次 ARP 请求后,再次发送相同请求的几率比较大,因此使用 ARP 缓存能够减 少 ARP 包的发送,除此之外,不仅仅 ARP 请求的发送方能够缓存 ARP 接收方的 MAC 地址,接收方也 能够缓存 ARP 请求方的 IP 和 MAC 地址,如下所示:
不过,就如我们上篇章说的:MAC 地址的缓存有一定期限,超过这个期限后,缓存的内容会被清除,需要重新发送并再次缓存。
在linux查询ARP缓存:
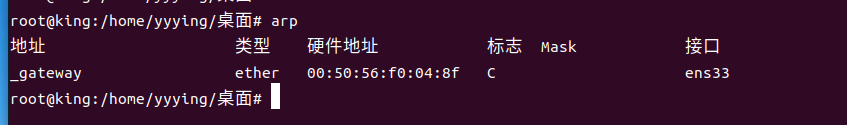
主要包含五项:
● 主机名 --- 对应一个 IP 地址
● 硬件地址类型
● 硬件地址
● 标志
● 本地网络接口
标志主要分为三类: C 、M 或 P,C 表示的是由 ARP 协议动态学习。M 类可以通过 arp -s 增加一 条。P 类表示的是发布,对于任何 P 类项目,主机对输入的 ARP 请求都返回一个 ARP 响应。这个选项用于配置代理 ARP。
五、RARP
与 ARP 相对的,RARP(Reverse Address Resolution Protocol) 是将 ARP 反过来,从 MAC 地址 定位 IP 地址的一种协议,将打印机服务器等小型嵌入式设备接入网络时会使用到。
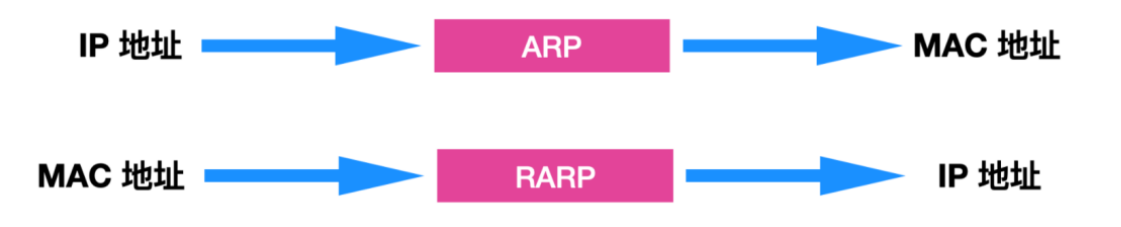
目前已被BOOTP、DHCP所取代。
IP地址
在讲IP地址之前呢,我想问大家几个问题
1、为什么要有IP地址?
2、既然IP地址存在,那它的意义是什么?
3、那又如何表示呢?
我们先来看看第一个问题
一、为什么要有IP地址?
在早期呢,我们的电脑是从物理层设计了电气规范(相当于电子信号的发送)过后,然后有了我们的数据链路层,那么在数据链路层中实现了我们的物理信息的传输,但在其中我们涉及到了多个设备的互联传递,那么MAC地址就应运而生了,我们通过ARP广播来询问“你是谁”这个问题。但此时我们的网络规模要是太大了,就会造成一种问题——“广播风暴”。也就是上一篇我留的那个问题——全球计算机是否都能用交换机相连呢,显然是不行的,上一篇也已经讲过了。
那么这个时候,我们就开始想,我们如果能让一个庞大的网络变的更局部,那么这样是不是就能让我们的网络更高效并且便于管理,那么这种行为我们就称之为 隔离广播域 ,那么什么叫做便于管理呢?这里我举个例子——我们都会有一种叫做身份证的东西,但当我们在互联网上购买东西的时候,你是填你家地址呢,还是填你的身份证号呢,很显然肯定是前者,那么在此处,我们的家庭地址就是我们的IP地址,而我们的身份证号就是我们的MAC地址。我们为了让全球的互联网互联互通,但发现MAC很难做到这样,所以我们通过一个IP协议将整个互联网统一管理起来。
二、既然IP地址存在,那它的意义是什么?
IP协议规定了我们任何计算机,它本身MAC地址毫无意义,只看我们目前所在网络的网络号是多少以及你在这个网络号上属于哪一个主机(号)。
即,IP地址存在的根本意义在于:它通过“逻辑分层”和“拓扑结构化”,解决了大规模网络设备互联的三大核心问题——可扩展性、灵活路由和位置无关性。
● MAC地址回答“你是谁” —— 是固定的、与生俱来的身份。
● IP地址回答“你在哪” —— 是动态的、随拓扑变化的逻辑位置。
三、那又如何表示呢?
那么到现在,才是我们今天IP篇章的开始。
1、IP地址的定义
现如今有两个版本的 IP 地址,IPv4 和 IPv6,我们首先探讨一下现如今还在广泛使用的 IPv4 地址, 后面再考虑 IPv6 。
IPv4 由 32 位正整数来表示,在计算机内部会转化为二进制来处理,但是二进制不符合人类阅读的 习惯,所以我们根据易读性的原则把 32 位的 IP 地址以 8 位为一组,分成四组,每组之间以“.”进行分割,再将每组转换为十进制数。如下图所示:
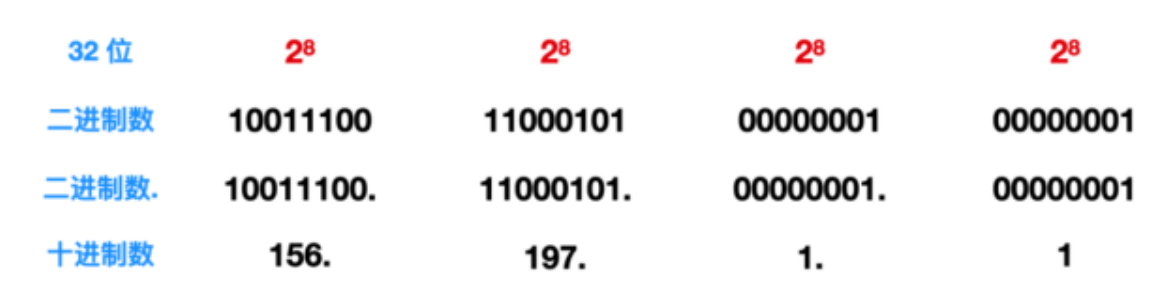
除此之外,从图中我们还可以得到如下信息
每个这样 8 位一组的数字,自然是非负数,其取值范围是 [0,255]。
IP 地址的总个数有 2^32 次幂个,这个数值算下来是 4294967296 ,大概能允许 43 亿台设备连接到网络。实际上真的如此吗?
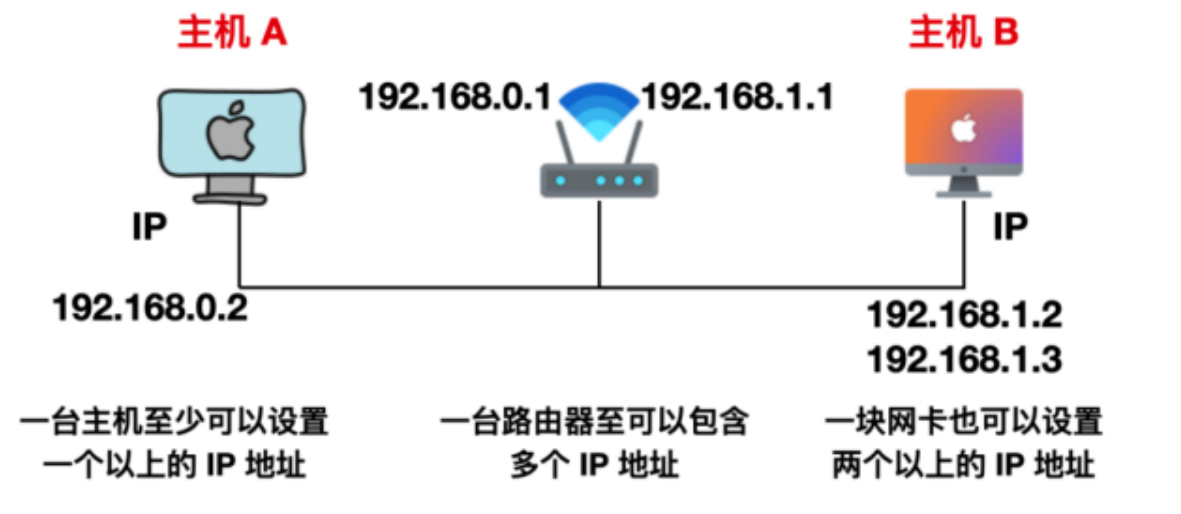
实际上 IP 不会以主机的个数来配置的,而是根据设备上的网卡(NIC) 进行配置,每一块网卡都会设置一个或者多个 IP 地址,而且通常一台路由器会有至少两块网卡,所以可以设置两个以上的 IP 地址, 所以主机的数量远远达不到 43 亿。
2、IPv4地址的表示方法
● IPv4地址由因特网名字和数字分配机构(Internet Corporation for Assigned Names and Numbers,ICANN)进行分配。
○ 我国用户可向亚太网络信息中心(Asia Pacific Network Information Center,APNIC)申请IP 地址,需要缴纳相应的费用,一般不接受个人申请。
○ 2011年2月3日,因特网号码分配管理局(Internet Assigned Numbers Authority,IANA)(由ICANN行使职能)宣布,IPv4地址已经分配完毕。
○ 我国在2014至2015年也逐步停止了向新用户和应用分配IPv4地址,同时全面开展商用部署 IPv6。
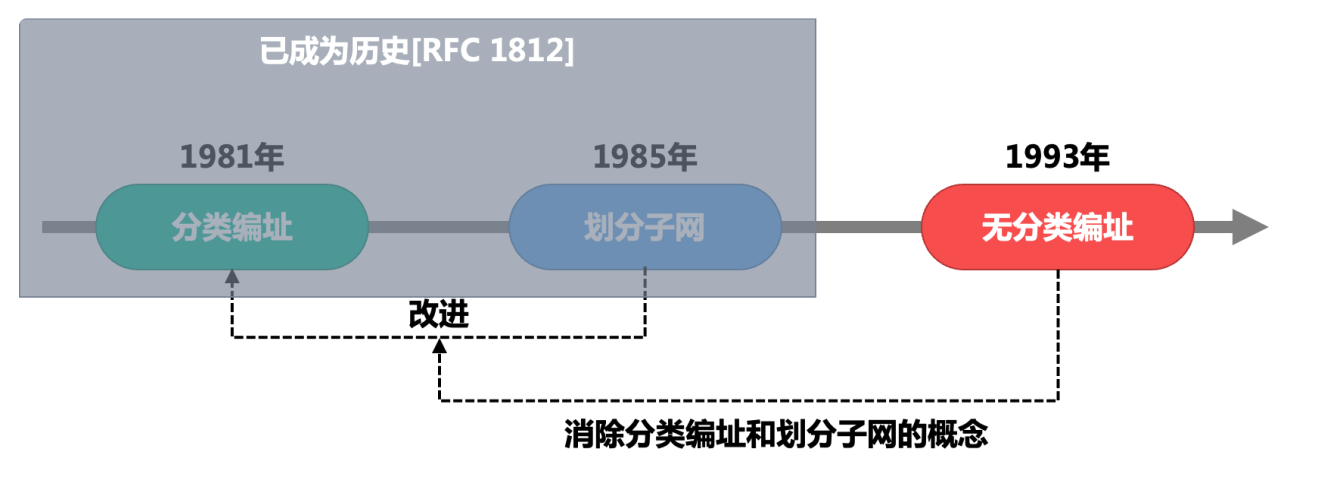
● IPv4地址的编址方法经历了三个历史阶段:
2.1、IPv4地址的分类编址方法
● 网络层如何识别一个设备的信息,就像人有身份证那样。
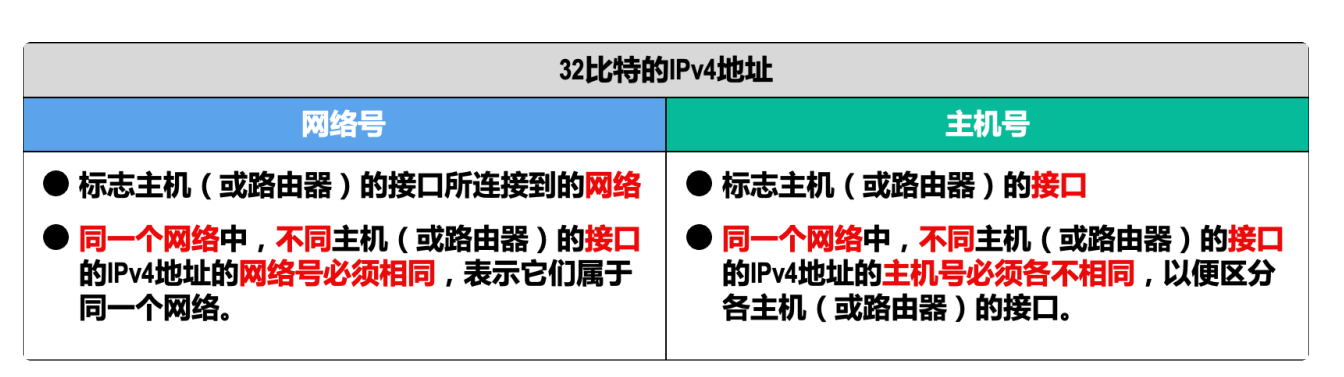
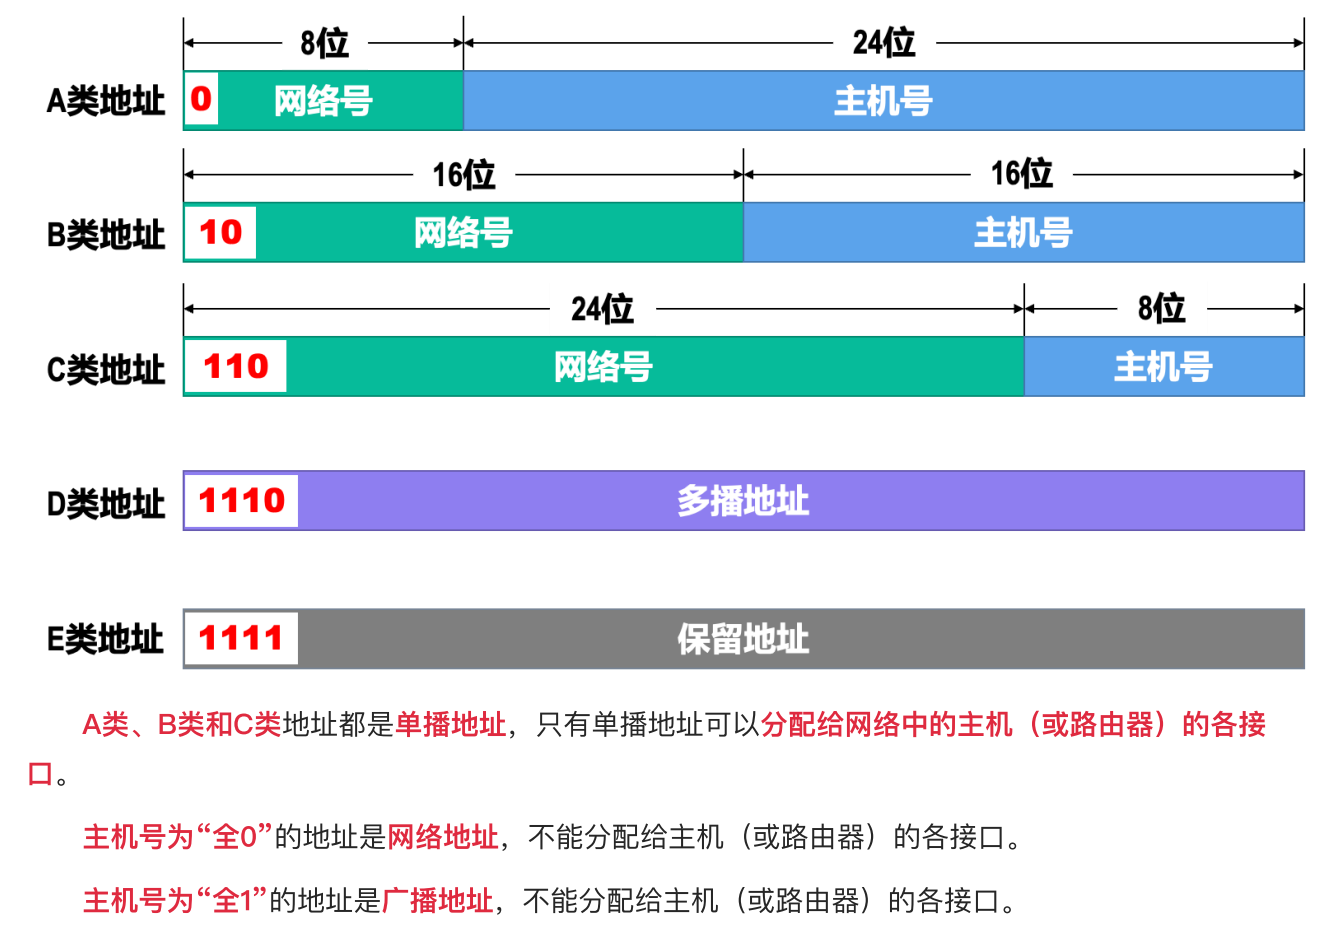
● 早期为了分类管理,采用了下表的固定方式进行分类管理
在这里我想强调下多播地址和保留地址,这两个地址是不能个人使用的公共地址
**单播:**也就是我们平常所说的点对点。
**广播:**在网络号内全部进行通知,最典型的就是ARP
**多播/组播:**假设现在我们有四台设备,c1 ~ c4我们现在把A包发给c1和c4,我们是先发给c1,再发给c4,还是直接c1和c4一起发了呢,都组播了,那肯定是后者啦,所以我们现在有一个通用的地址,即多播地址,只要我们电脑上含有该地址,接收到这个IP的包,我们网卡一看:“是我们组的IP,直接要了。”但倘若我们并不在该组里面,那么我们就会直接丢弃,就不会往上传。
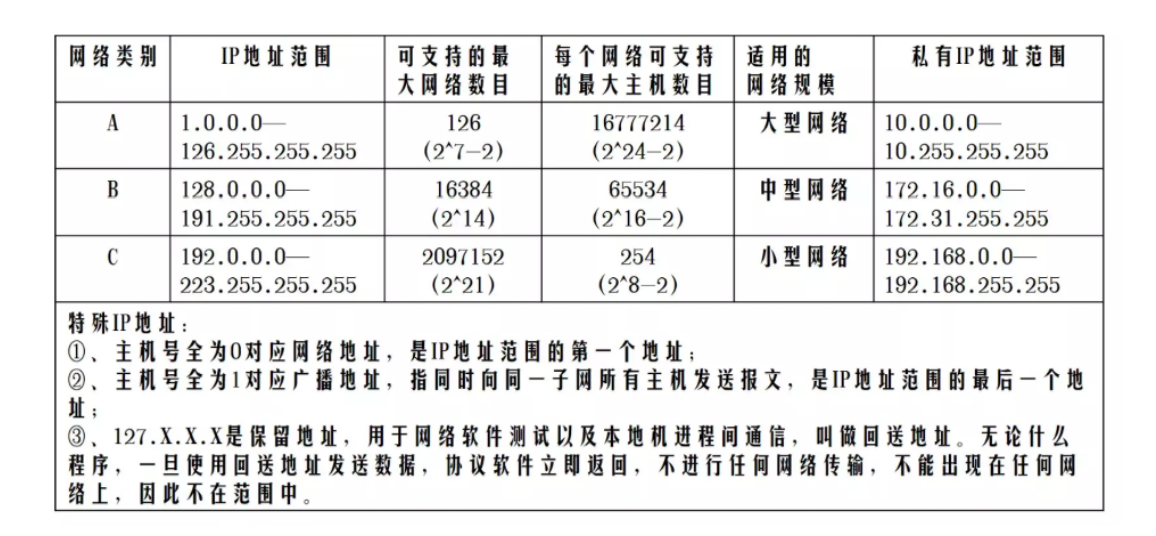
● 还有一些一般不使用的特殊IPv4地址
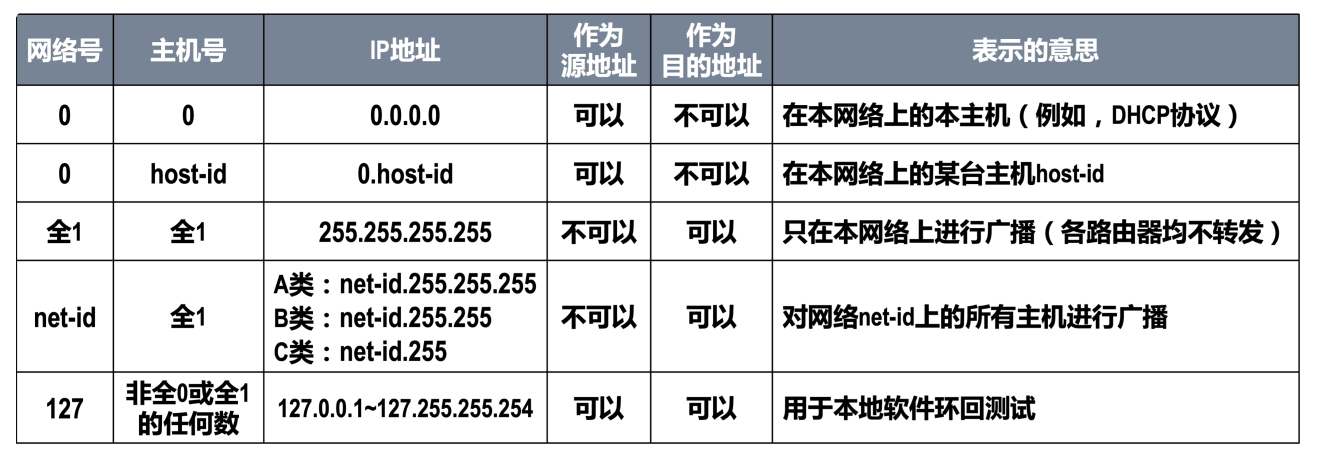
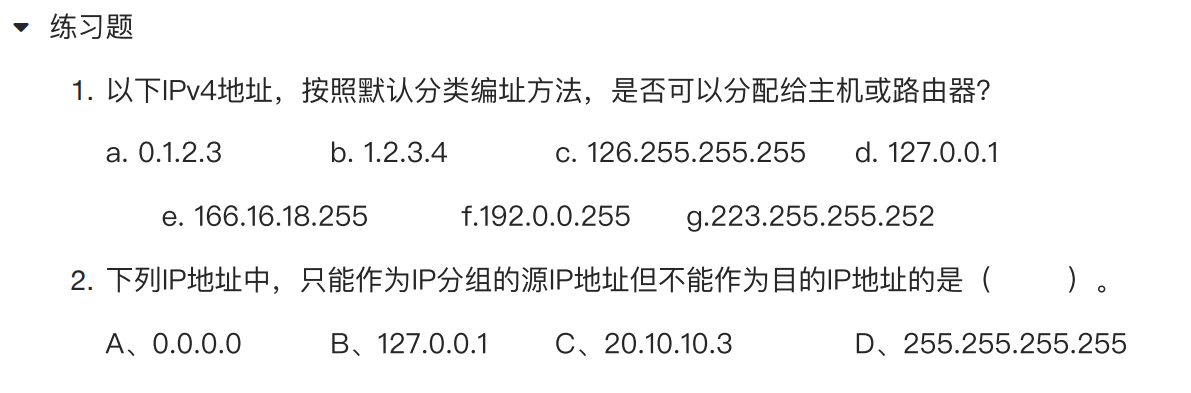
● 此处有两道考研题,兄弟们可以看一看,验证下上述图片有没有看懂,答案是be和A。
2.2、IPv4地址的划分子网编址方法
2.2.1、为什么要划分子网?
案例分析:
● 如果需要让200台主机在同一个网段内,可以分配一个C类网段,比如192.168.1.0/24
○ 共254个可用IP地址:192.168.1.1~192.168.1.254
○ 多出54个空闲的IP地址,这种情况并不算浪费资源
● 如果需要让500台主机在同一个网段内,那就分配⼀个B类网段,比如191.100.0.0/16
○ 共65534个可用IP地址:191.100.0.1~191.100.255.254
○ 多出65034个空闲的IP地址,这种情况属于极大的浪费资源
随着更多的中小网络加入因特网,IPv4分类编址方法不够灵活、容易造成大量IPv4地址资源浪费的缺点就暴露出来了。分类编址方法不够灵活且容易造成大量地址浪费,划分子网编址方法对其进行改进 (“打补丁”)。
● 子网掩码可以表明分类IPv4地址的主机号部分被借用了几个比特作为子网号。
● 与IPv4地址类似,子网掩码也是由32比特构成的。
○ 从左起多个连续的比特1对应IPv4地址中的网络号和子网号。
○ 之后的多个连续的比特0对应IPv4地址中的主机号。
● 只要给定了一个分类的IPv4地址及其相应的子网掩码,就可以得出子网划分的全部细节。
2.2.2、怎么划分子网?
将IP地址中的主机号部分再拿出某几位来作为网络号,剩下的部分作为主机号。
下面我们看一个例子:
现有一个C类网210.55.23.X。由于有四个不同的部门要使用这段IP,为了不让各个部门之间相互干扰,我们需要如何处理?
解答过程:
根据题意,我们需要将原来给出的一个网络划分为四个子网,以使得各个子网间互不影响。
那么这个网段能够为自己使用的就是最后八个X,他代表8个bit。为了划分4个网段,需要拿来2个bit来标记,所以我们将IP地址的主机部分中(8位)拿出前面2位来作为我们的子网网络号部 分,因此用作主机的位数就只有剩下的6位。
210.55.23.xxxx xxxx
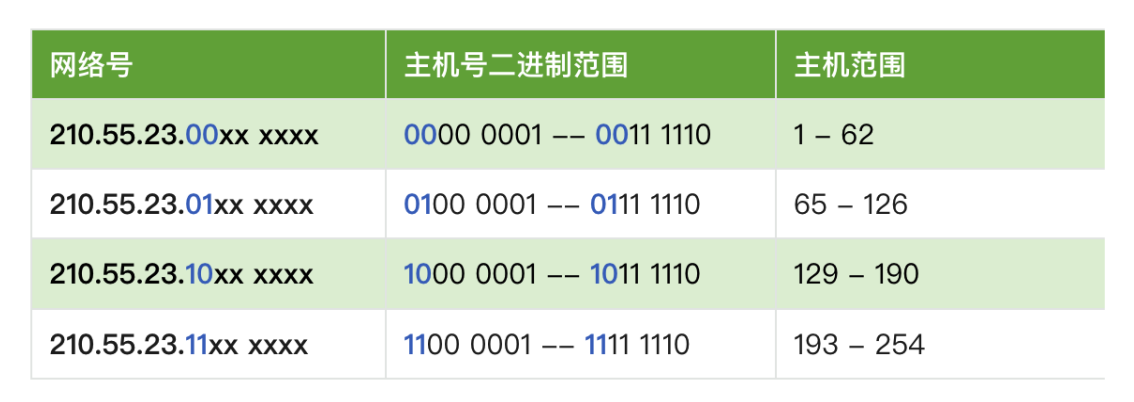
由于我们将原来IP地址中主机号的前两位用来作为了网络号部分,因此,为了让计算机能知 道这两位是网络号,所以我们需要将相应的子网掩码中对应的这两位设置为1。
所以子网掩码应设置为255.255.255.192。
2.2.3、总结
● 在线计算工具:https://tool.chinaz.com/tools/subnetmask
● 根据子网ID借用的主机位数,我们可以计算出划分的子网数、掩码、每个子网主机数,以C类网络为例:
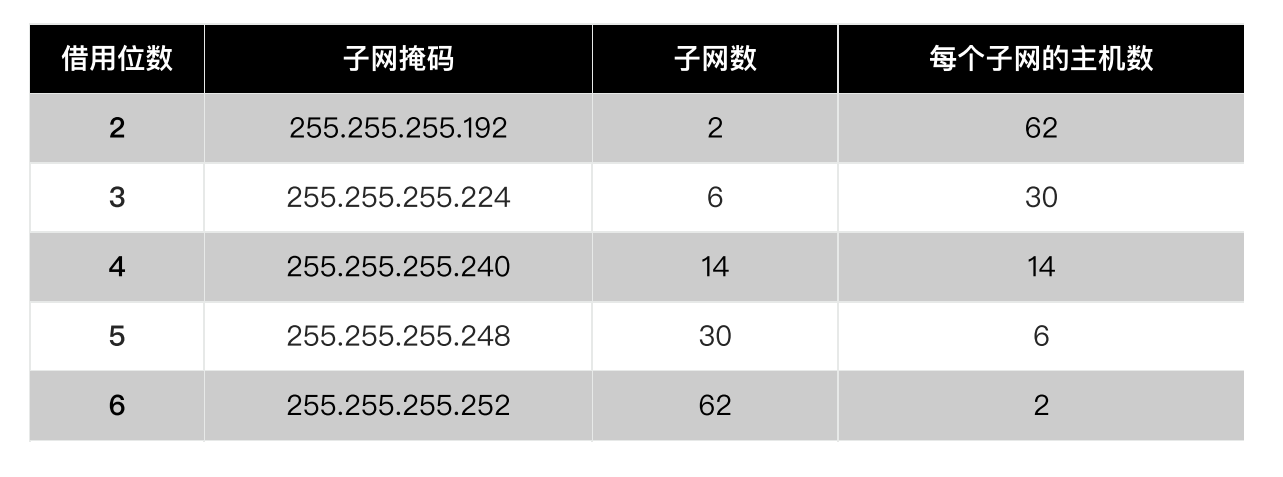
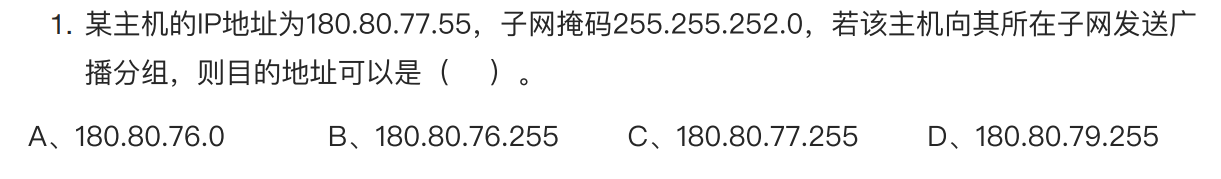
依旧是一道考研题拿来练手,试试吧。答案是D。
2.3、IPv4地址的无分类编址方法
● IPv4地址的划分子网编址方法在一定程度上缓解了因特⽹在发展中遇到的困难,但是数量巨大的C类网()由于其每个网络所包含的地址数量太小(
),因此并没有得到充分使用,而因特网的IPv4地址仍在加速消耗,整个IPv4地址空间⾯临全部耗尽的威胁。
● 因特网工程任务组IETF又提出了采用无分类编址的方法,来解决IPv4地址资源紧张的问题,同时还专门成立IPv6工作组负责研究新版本的IP,以彻底解决IPv4地址耗尽问题。
● 1993年,因特网工程任务组IETF发布了无分类域间路由选择(Classless Inter-Domain Routing, CIDR )的RFC文档[RFC1517~1519,RFC1520]。
○ CIDR消除了传统A类、B类和C类地址以及划分子网的概念。
○ CIDR可以更加有效地分配IPv4地址资源,并且可以在IPv6使用之前允许因特网的规模继续增长。
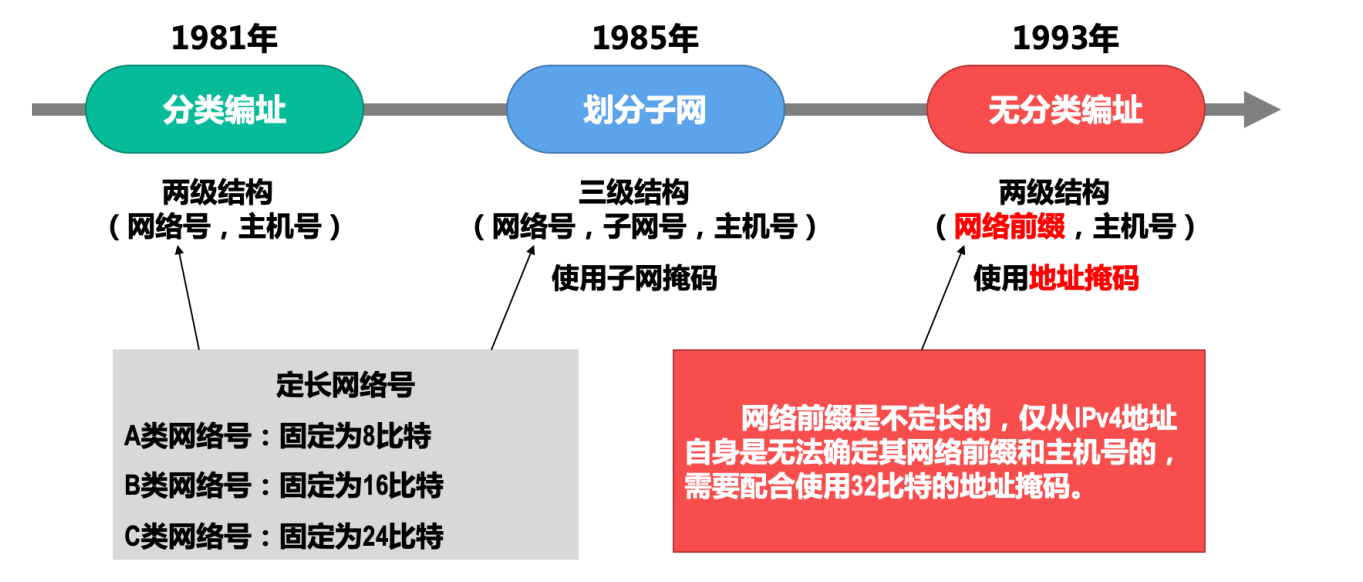
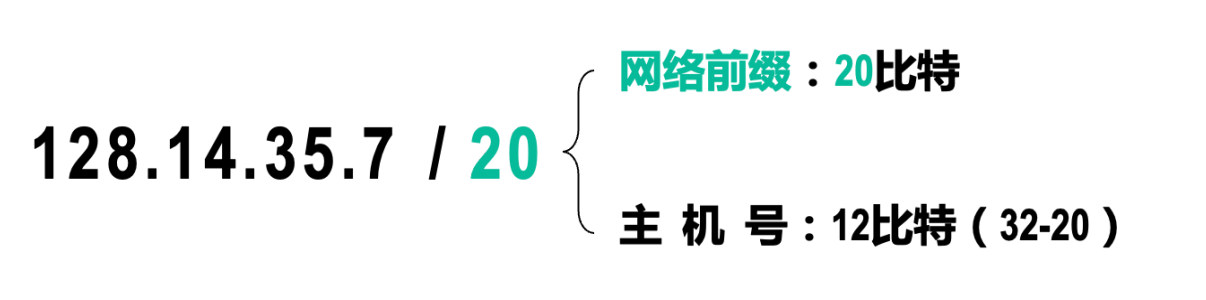
● 为了简便起见,可以不明确给出配套的地址掩码的点分十进制形式,而是在无分类编址的IPv4地址后面加上斜线“/”,在斜线之后写上网络前缀所占的比特数量(也就是地址掩码中左起连续比特1的数量),这种记法称为斜线记法。
上面这么多说白了其实就是把之前的那种多少位比特的子网掩码直接写为数字,即下图:
3、构造超网
3.1、需求分析
● 原本有200台计算机使用192.168.0.0/24网段,现在希望增加200台设备到同一个网段。
○ 200台在192.168.0.0/24网段,200台在192.168.1.0/24网段
○ 合并192.168.0.0/24、192.168.1.0/24为一个网段:192.168.0.0/23(子网掩码往左移动1位)
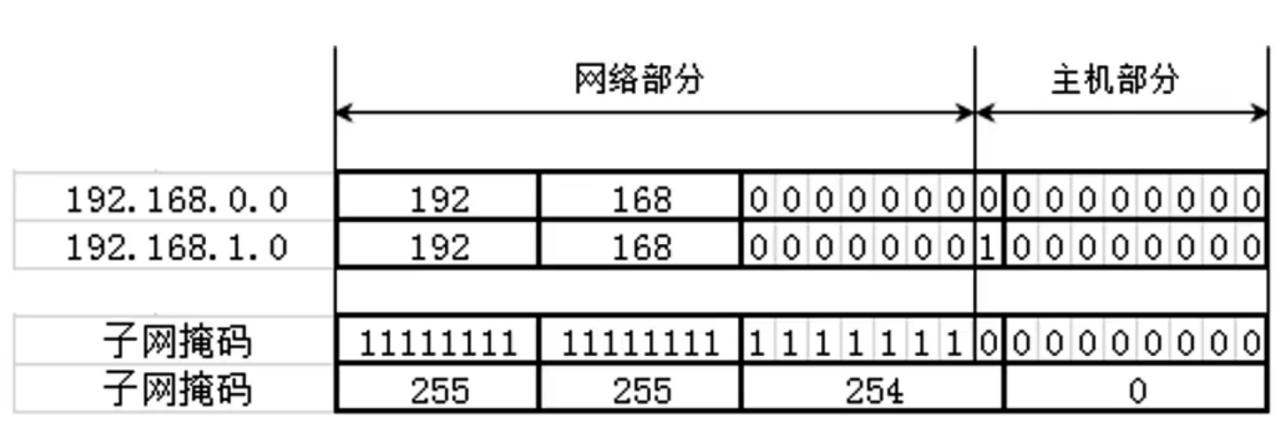
● 子网掩码向左移动2位,可以合并4个网段
可以说,子网是网络号在借位,那超网就是网络号在给位。
3.2、路由聚合
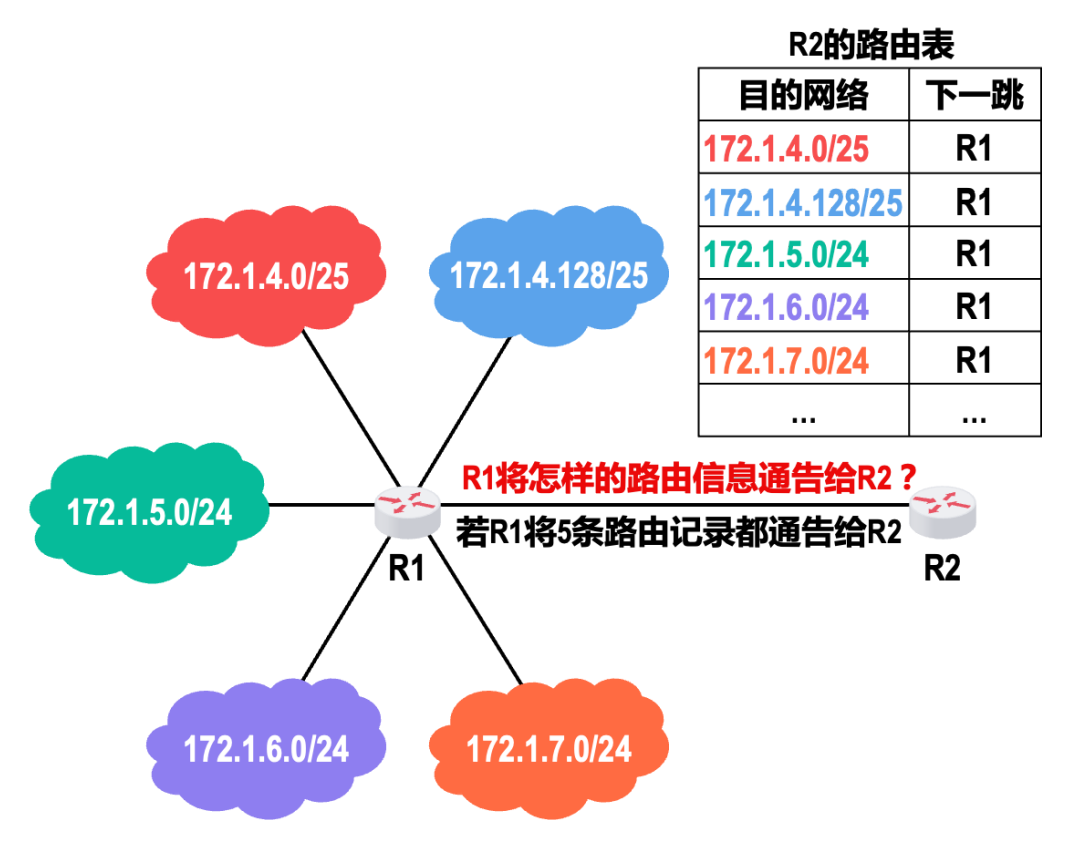
R1将怎样的路由信息通告给R2?
解答分析:
● 网络前缀越长,地址块越小,路由越具体。
● 若路由器查表转发分组时发现有多条路由条目匹配,则选择网络前缀最长的那条路由条目, 这称为最长前缀匹配,因为这样的路由更具体。
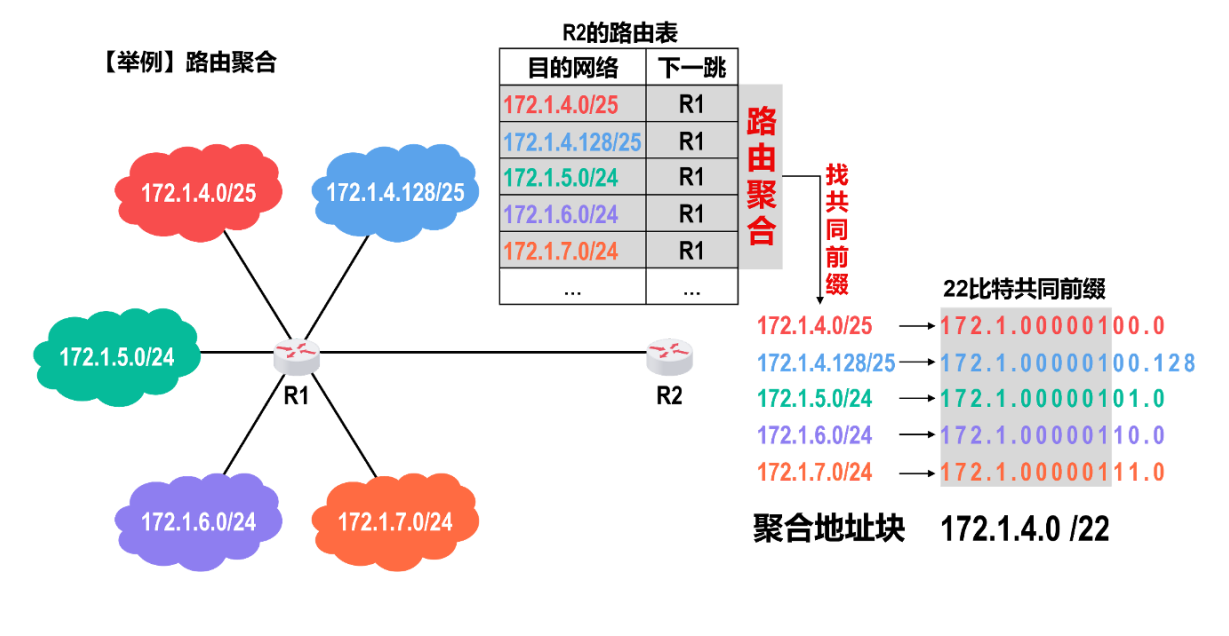
可以看到那么大一张路由表最后集成了172.1.4.0/22。
依旧是两道考研题,在此我只讲解第一道,第二道只要能看懂上表应该没问题,答案是。
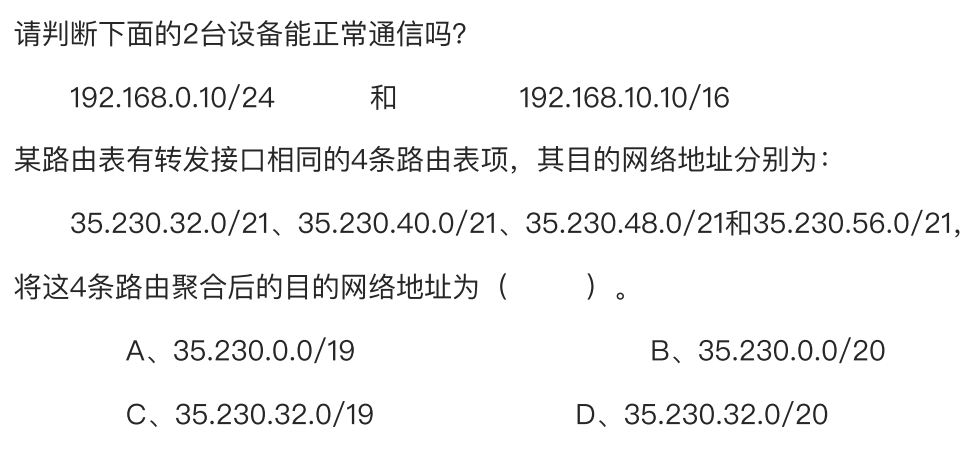
乍一看,这第一道题也不难啊,两边经过子网掩码对其做异或运算过后,网络号都为192.168.0.0,这还不能正常通信吗,那么恭喜你,你已经成功掉进了出题老头设给你陷阱里。
假设我们左边是设备A,而右边是设备B,那么在设备A向设备B ping 数据包的时候,请问设备A是怎么知道对方的掩码情况的呢,显然设备A是不可能知道的,且数据包里面也不会有子网掩码的信息,那么设备A是怎么对设备B的IP地址进行运算的呢,答案显而易见,就是用自己的子网掩码来进行运算。那么就有人问了, B 向A ping 数据包,那对于 B 来说,对 A 的IP做子网掩码运算,那双方的网络号不都为 192.168.0.0了吗,问得好!那你不妨想一下,通信是需要双方共同完成的事,那你B向A发了,那A咋回给你B啊?那就说明这两个设备是无法进行通信的!
3.3、如何判断子网还是超网
● 先判断该网段的类型,是A类、B类、C类网络
○ 默认A类子网掩码的位数是8,B类子网掩码的位数是16,C类子网掩码的位数是24
● 然后判断子网掩码的位数
○ 比默认子网掩码多,就是子网
○ 比默认子网掩码少,就是超网
结语
那么关于计网MAC地址和IP地址的讲解就到这里了。
我是YYYing, 后面还有更精彩的内容,希望各位能多多关注支持一下主包。
**无限进步,**我们下次再见。
系列上期内容:【计算机网络 | 第二篇】计算机组网模型
系列下期内容:【计算机网络 | 第四篇】路由与NAT技术
《【计算机网络 | 第三篇】MAC地址与IP地址》 是转载文章,点击查看原文。


