hadoop高可用
| IP | 主机名 | 角色 |
|---|---|---|
| 192.168.150.172 | server1 | NameNode DFSZKFailoverController ResourceManager |
| 192.168.150.173 | server2 | JournalNode QuorumPeerMain DataNode NodeManager |
| 192.168.150.174 | server3 | JournalNode QuorumPeerMain DataNode NodeManager |
| 192.168.150.175 | server4 | JournalNode QuorumPeerMain DataNode NodeManager |
| 192.168.150.176 | server5 | NameNode DFSZKFailoverController ResourceManager |
zookeeper集群部署
Zookeeper集群至少三台,总节点数为奇数个。
安装JDK
安装zookeeper
1tar zxf apache-zookeeper-3.8.6-bin.tar.gz
2# 编辑zoo.cfg文件:
3cd apache-zookeeper-3.8.6-bin/conf/
4cp zoo_sample.cfg zoo.cfg
5vim  zoo.cfg
6tickTime=2000
7initLimit=10
8syncLimit=5
9dataDir=/tmp/zookeeper
10clientPort=2181
11server.1=192.168.150.173:2888:3888
12server.2=192.168.150.174:2888:3888
13server.3=192.168.150.175:2888:3888
14
各节点配置文件相同,并且需要在/tmp/zookeeper目录中创建myid文件,写入
一个唯一的数字,取值范围在1-255。比如:192.168.36.167节点的myid文件写入数
字“1”,此数字与配置文件中的定义保持一致,(server.1=192.168.150.173:2888:3888
)其它节点依次类推。
1mkdir -p /tmp/zookeeper
2echo 1 > /tmp/zookeeper/myid
在各节点启动服务:(server2、server3、server4)
bin/zkServer.sh start
查看节点状态
bin/zkServer.sh status
hadoop配置
1[hadoop@server1 ~]$ cd hadoop/etc/hadoop/
2[hadoop@server1 hadoop]$ vim core-site.xml
3
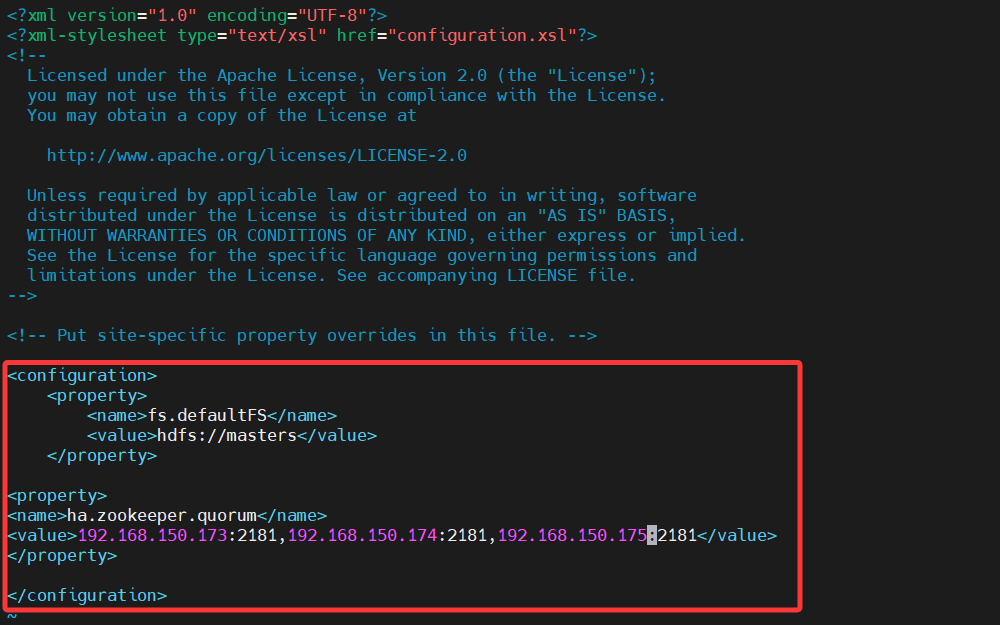
1<configuration>
2    <property>
3        <name>fs.defaultFS</name>
4        <value>hdfs://masters</value>
5    </property>
6
7<property>
8<name>ha.zookeeper.quorum</name>
9<value>192.168.150.173:2181,192.168.150.174:2181,192.168.150.175:2181</value>
10</property>
11
12</configuration>
13
1[hadoop@server1 hadoop]$ vim hdfs-site.xml
2
1<configuration>
2    <property>
3        <name>dfs.replication</name>
4        <value>3</value>
5    </property>
6<property>
7<name>dfs.nameservices</name>
8<value>masters</value>
9</property>
10
11<property>
12<name>dfs.ha.namenodes.masters</name>
13<value>h1,h2</value>
14</property>
15
16<property>
17<name>dfs.namenode.rpc-address.masters.h1</name>
18<value>192.168.150.172:9000</value>
19</property>
20
21<property>
22<name>dfs.namenode.http-address.masters.h1</name>
23<value>192.168.150.172:9870</value>
24</property>
25
26<property>
27<name>dfs.namenode.rpc-address.masters.h2</name>
28<value>192.168.150.176:9000</value>
29</property>
30
31<property>
32<name>dfs.namenode.http-address.masters.h2</name>
33<value>192.168.150.176:9870</value>
34</property>
35
36<property>
37<name>dfs.namenode.shared.edits.dir</name>
38<value>qjournal://192.168.150.173:8485;192.168.150.174:8485;192.168.150.175:8485/masters</value>
39</property>
40
41<property>
42<name>dfs.journalnode.edits.dir</name>
43<value>/tmp/journaldata</value>
44</property>
45
46<property>
47<name>dfs.ha.automatic-failover.enabled</name>
48<value>true</value>
49</property>
50
51<property>
52<name>dfs.client.failover.proxy.provider.masters</name>
53<value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
54</property>
55
56<property>
57<name>dfs.ha.fencing.methods</name>
58<value>
59sshfence
60shell(/bin/true)
61</value>
62</property>
63
64<property>
65<name>dfs.ha.fencing.ssh.private-key-files</name>
66<value>/home/hadoop/.ssh/id_rsa</value>
67</property>
68
69<property>
70<name>dfs.ha.fencing.ssh.connect-timeout</name>
71<value>30000</value>
72</property>
73
74</configuration>
75
启动hdfs集群(按顺序启动)
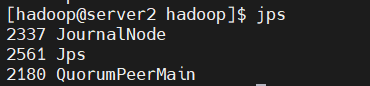
1)确认启动zookeeper集群(server2、server3、server4)
1[hadoop@server2~]$ jps
2
31222QuorumPeerMain
4
51594 Jps
2)在三个DN上依次启动journalnode(第一次启动hdfs必须先启动journalnode)
1[hadoop@server2 ~]$ cd hadoop
2[hadoop@server2 hadoop]$ bin/hdfs --daemon start journalnode
3[hadoop@server2 hadoop]$ jps
42337 JournalNode
52180 QuorumPeerMain
62379 Jps
7
3)格式化HDFS集群(server1上执行)
1$ bin/hdfs namenode -format
2Namenode数据默认存放在/tmp,需要把数据拷贝到h2
3$ scp -r /tmp/hadoop-hadoop server5:/tmp
4
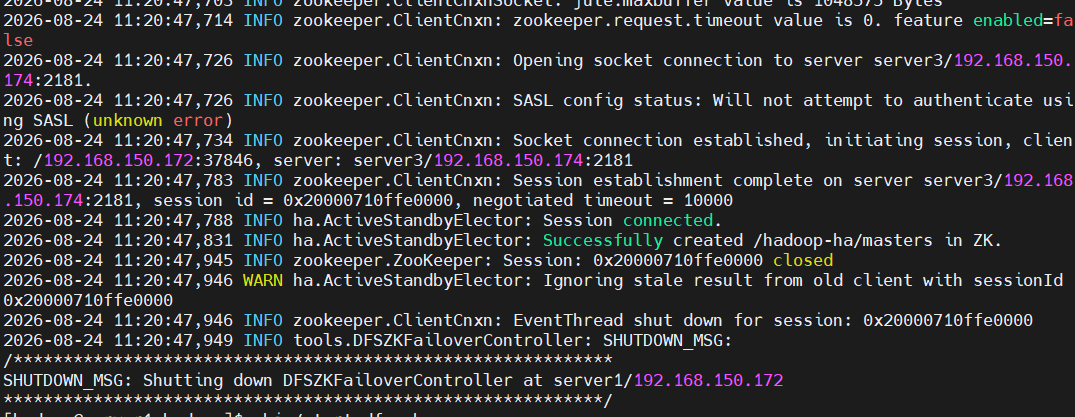
4)格式化zookeeper (只需在h1上执行即可)
$ bin/hdfs zkfc -formatZK (注意大小写)
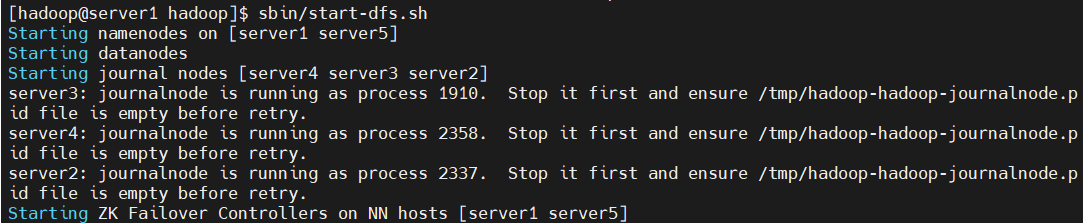
5)启动hdfs集群(只需在h1上执行即可)
$ sbin/start-dfs.sh
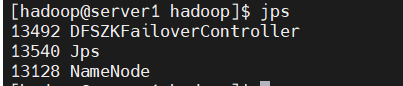
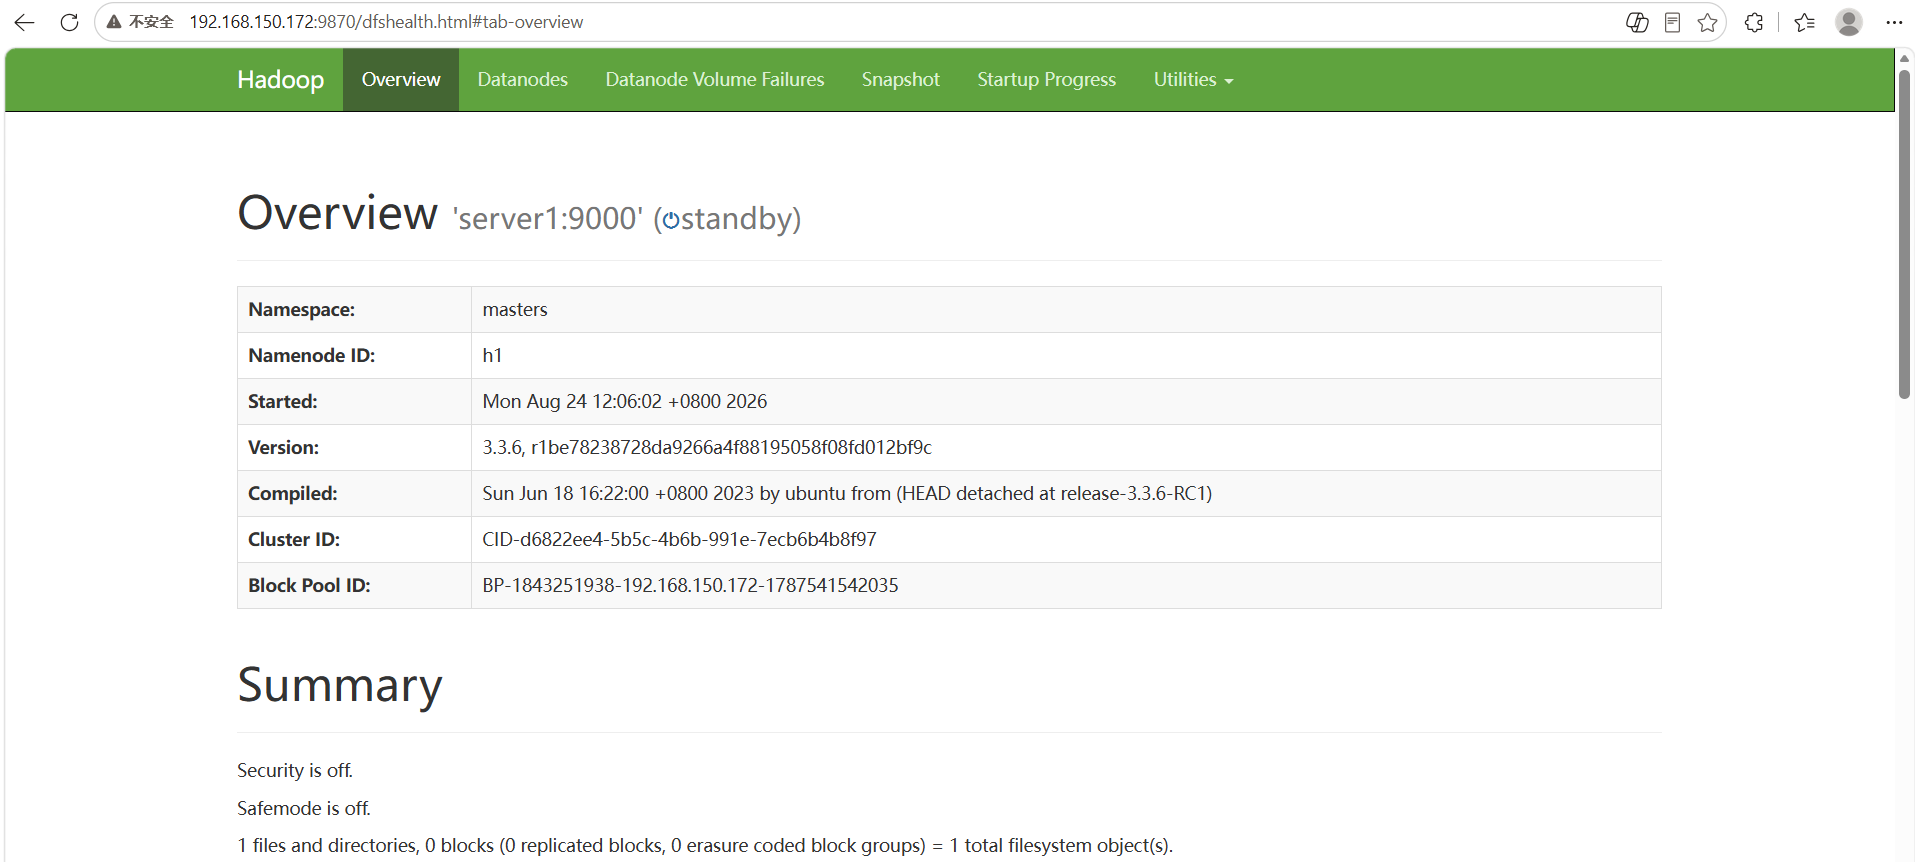
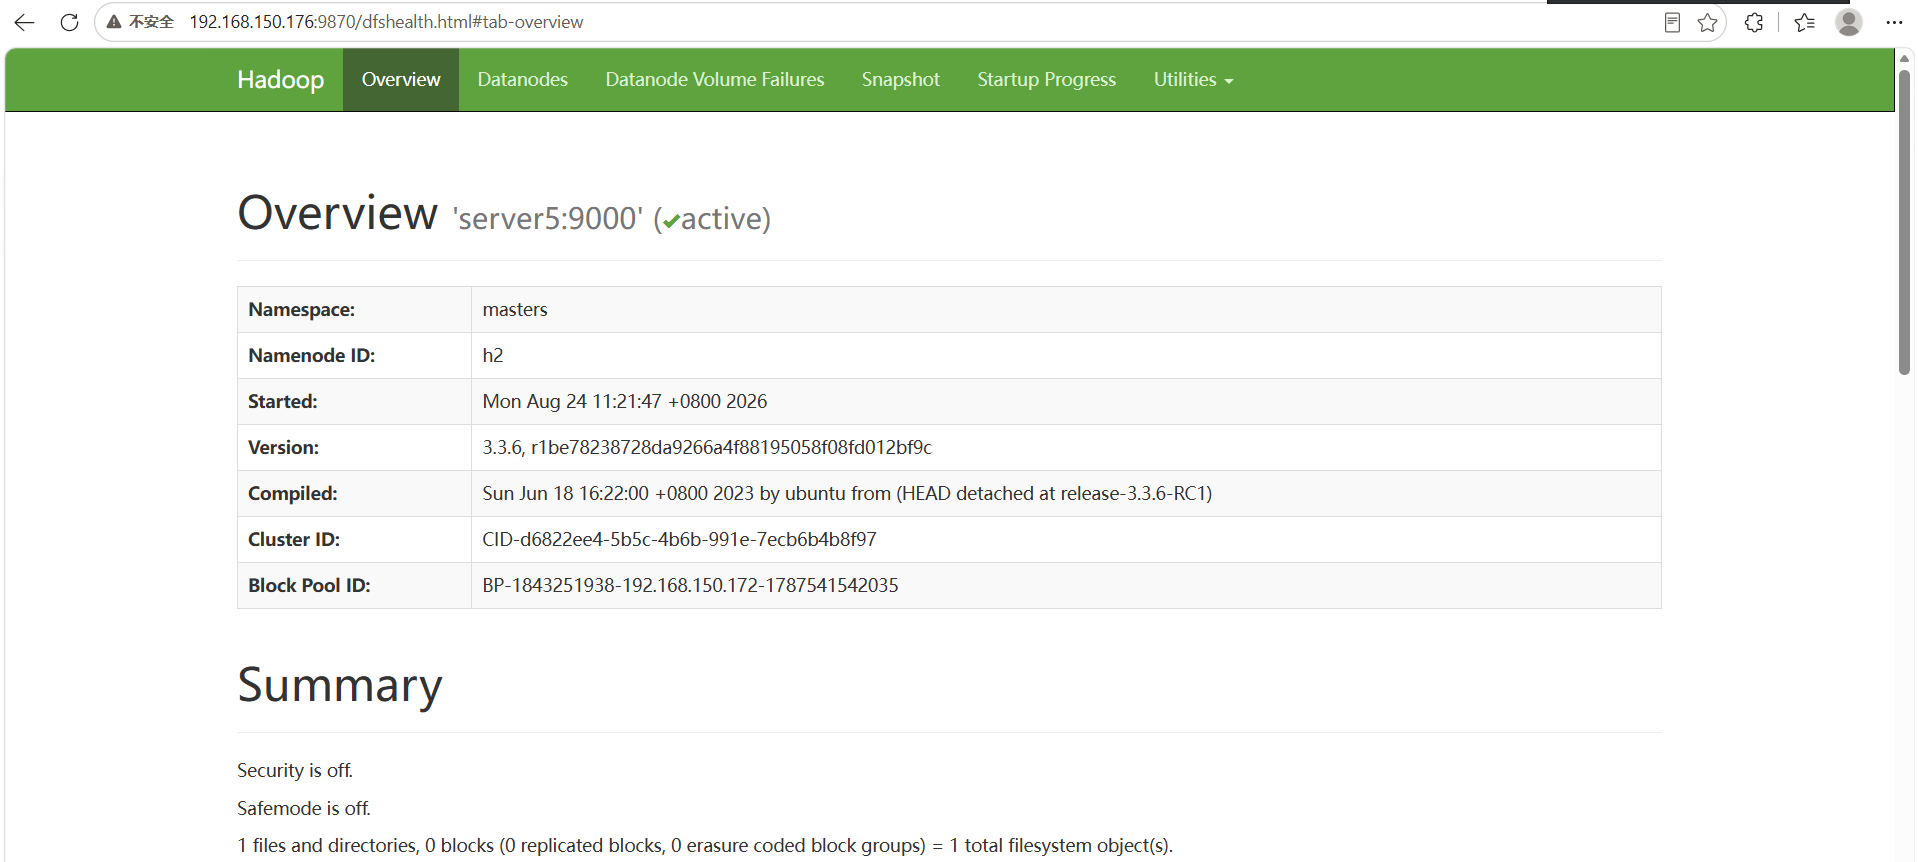
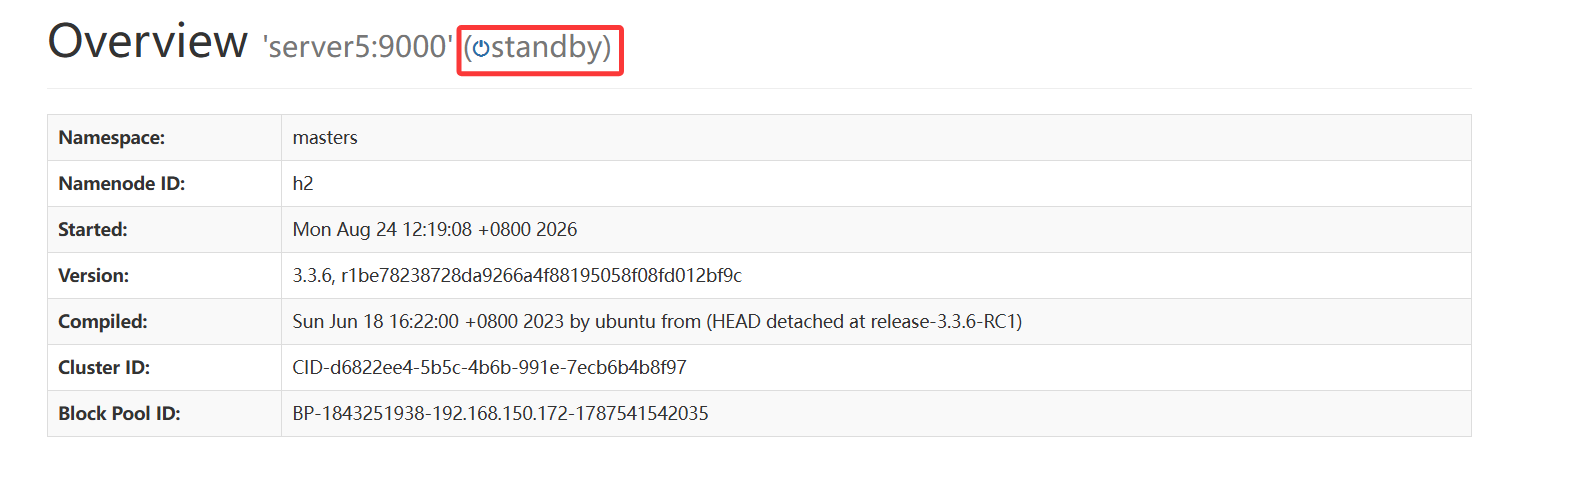
6)查看集群状态
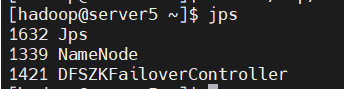
7)测试故障自动切换
杀掉h2主机的namenode进程后依然可以访问,此时h1转为active状态接
管namenode
1[hadoop@server5 ~]$ jps
22883 Jps
32373 DFSZKFailoverController
42670 NameNode
5[hadoop@server5 ~]$ kill -9 2670
6[hadoop@server5 ~]$ jps
72915 Jps
82373 DFSZKFailoverController
9[hadoop@server5 ~]$ cd hadoop
10[hadoop@server5 hadoop]$ bin/hdfs --daemon start namenode
11[hadoop@server5 hadoop]$ jps
122373 DFSZKFailoverController
132972 NameNode
143006 Jps
15
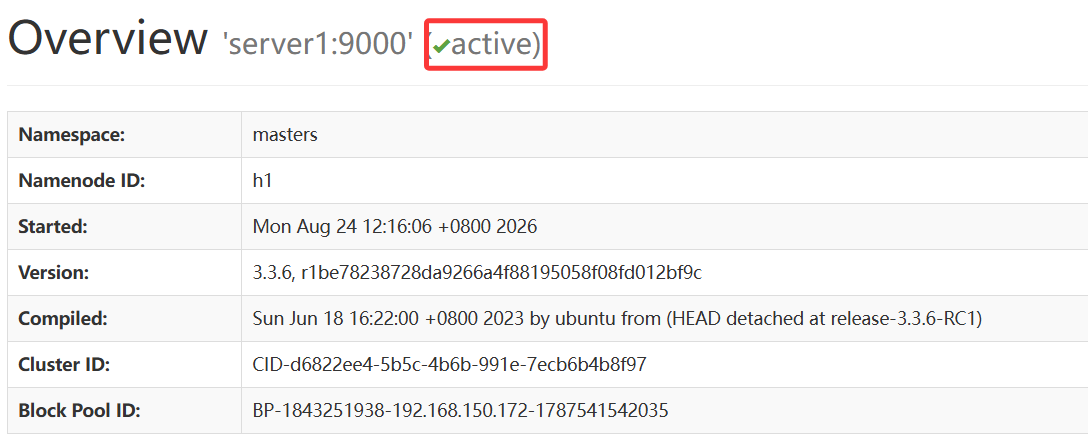
启动h1上的namenode,此时为standby状态。
yarn高可用
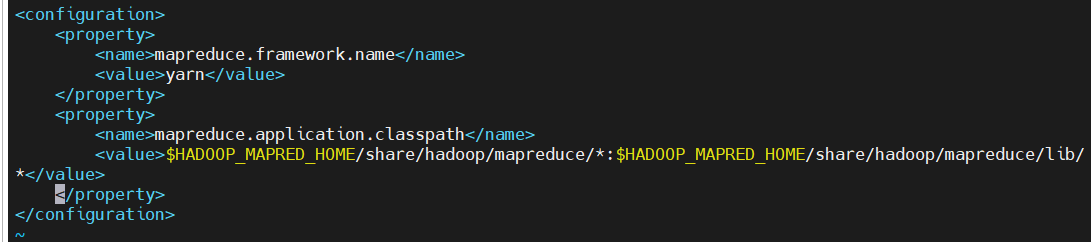
修改配置文件
1[hadoop@server1 hadoop]$ vim mapred-site.xml
2
1[hadoop@server1 hadoop]$ vim yarn-site.xml
2
1<configuration>
2    <!-- ======================== NodeManager 基础配置 ======================== -->
3    <property>
4        <name>yarn.nodemanager.aux-services</name>
5        <value>mapreduce_shuffle</value>
6        <!-- 辅助服务:MapReduce 任务运行时需要 Shuffle 服务来传输 Map 输出结果 -->
7        <!-- 这是 YARN 运行 MapReduce 作业的必备配置,不能更改名称 -->
8    </property>
9
10    <property>
11        <name>yarn.nodemanager.env-whitelist</name>
12        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_HOME,PATH,LANG,TZ,HADOOP_MAPRED_HOME</value>
13        <!-- 环境变量白名单:NodeManager 在启动容器时会传递这些环境变量给作业 -->
14        <!-- 确保 MapReduce 任务能正确找到 Hadoop 各组件路径和 Java 环境 -->
15    </property>
16
17    <!-- ======================== ResourceManager HA 核心配置 ======================== -->
18    <property>
19        <name>yarn.resourcemanager.ha.enabled</name>
20        <value>true</value>
21        <!-- 启用 ResourceManager 高可用(HA)模式 -->
22        <!-- true = 启动两个 RM(Active/Standby),false = 单 RM 模式 -->
23    </property>
24
25    <property>
26        <name>yarn.resourcemanager.cluster-id</name>
27        <value>RM_CLUSTER</value>
28        <!-- 集群标识符:用于区分不同 YARN 集群,多个 HA 集群必须不同 -->
29        <!-- 该 ID 会写入 ZooKeeper,供客户端识别当前连接的 RM 集群 -->
30    </property>
31
32    <property>
33        <name>yarn.resourcemanager.ha.rm-ids</name>
34        <value>rm1,rm2</value>
35        <!-- 定义两个 ResourceManager 的逻辑 ID(名称自定义) -->
36        <!-- rm1 和 rm2 分别对应下面配置的主机名 -->
37    </property>
38
39    <property>
40        <name>yarn.resourcemanager.hostname.rm1</name>
41        <value>server1</value>
42        <!-- 第一个 ResourceManager 运行的主机名(对应 rm1) -->
43        <!-- 确保 server1 已启动 ResourceManager 服务 -->
44    </property>
45
46    <property>
47        <name>yarn.resourcemanager.hostname.rm2</name>
48        <value>server5</value>
49        <!-- 第二个 ResourceManager 运行的主机名(对应 rm2) -->
50        <!-- server5 的 RM 作为 Standby 备用 -->
51    </property>
52
53    <!-- ======================== 状态存储与故障恢复 ======================== -->
54    <property>
55        <name>yarn.resourcemanager.recovery.enabled</name>
56        <value>true</value>
57        <!-- 启用 RM 状态恢复功能 -->
58        <!-- RM 重启/故障切换时能从 ZooKeeper 恢复之前的状态(队列、应用等) -->
59    </property>
60
61    <property>
62        <name>yarn.resourcemanager.store.class</name>
63        <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>
64        <!-- 状态存储类型:使用 ZooKeeper 存储 RM 状态 -->
65        <!-- 这是 HA 模式下推荐的存储方式,保证 RM 切换时状态不丢失 -->
66    </property>
67
68    <property>
69        <name>yarn.resourcemanager.zk-address</name>
70        <value>192.168.150.173:2181,192.168.150.174:2181,192.168.150.175:2181</value>
71        <!-- ZooKeeper 集群地址(端口默认 2181) -->
72        <!-- RM 通过 ZooKeeper 实现选举和状态同步,三个节点构成高可用 -->
73    </property>
74</configuration>
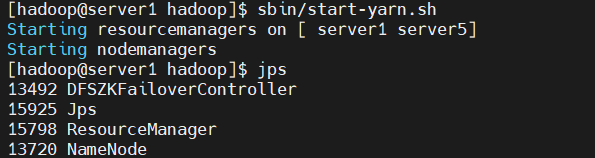
启动yarn服务
1[hadoop@server1 hadoop]$ sbin/start-yarn.sh
2Starting resourcemanagers on [ server1 server5]
3Starting nodemanagers
4[hadoop@server1 hadoop]$ jps
513492 DFSZKFailoverController
615925 Jps
715798 ResourceManager
813720 NameNode
9
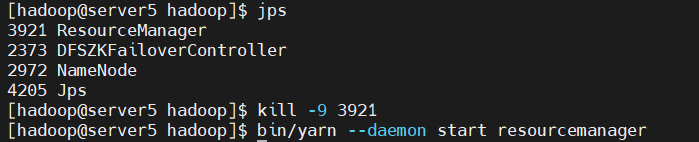
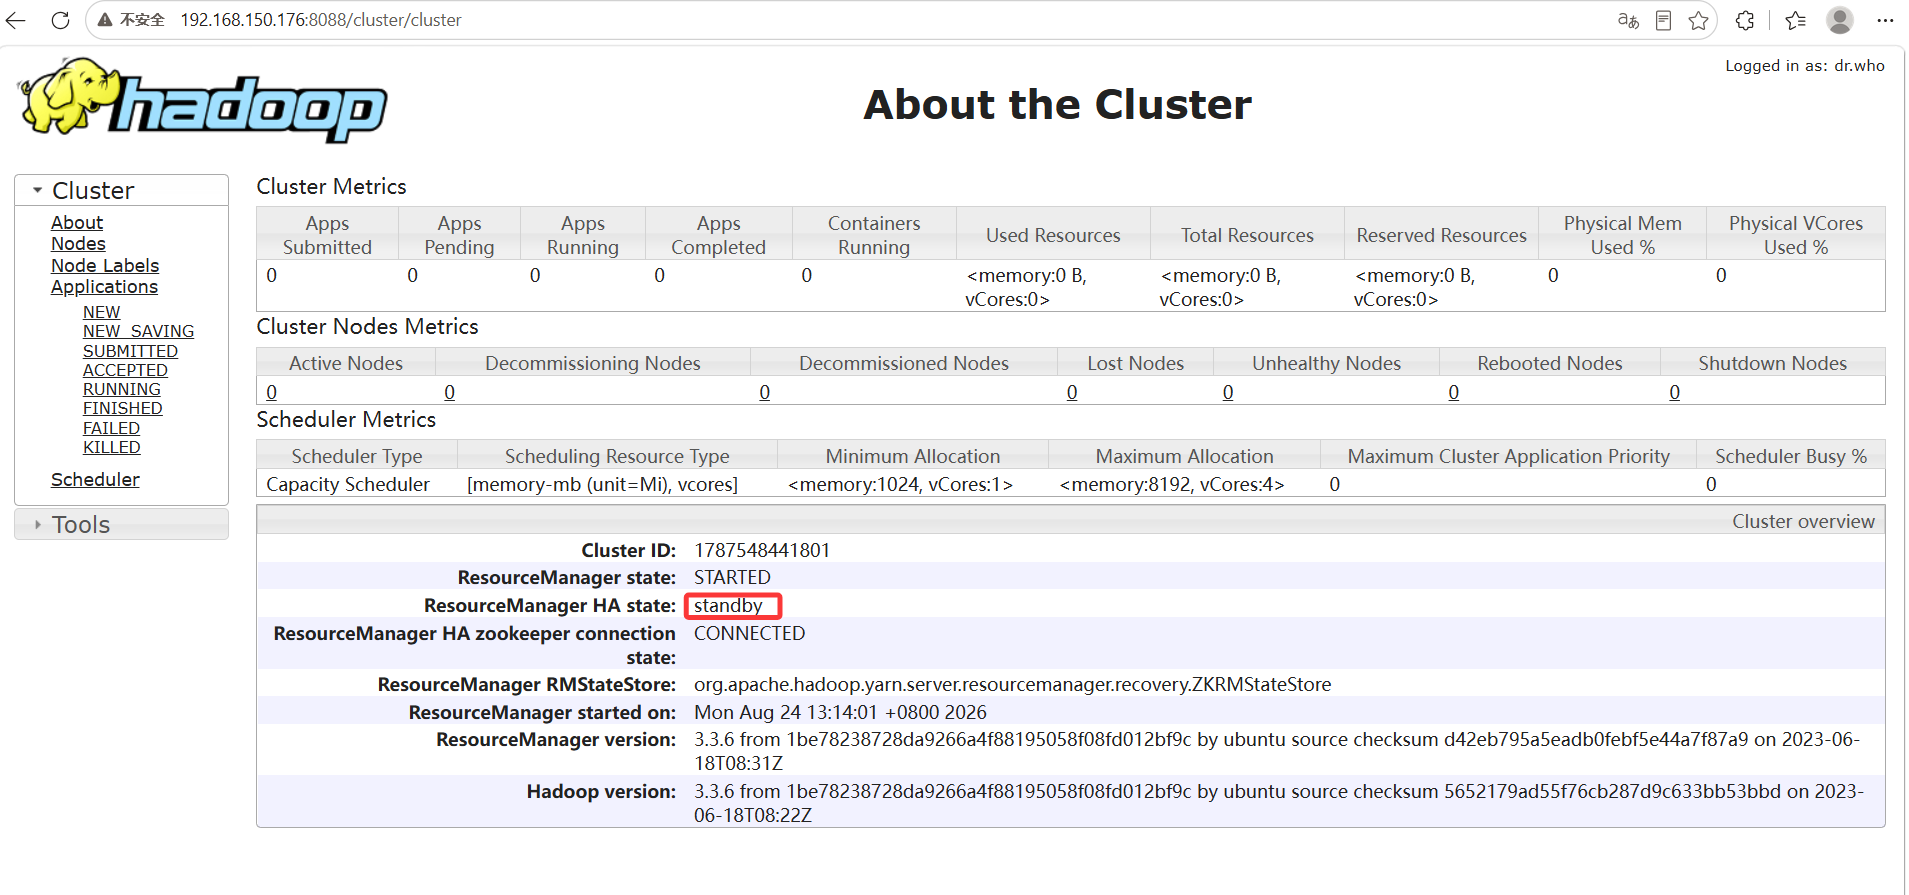
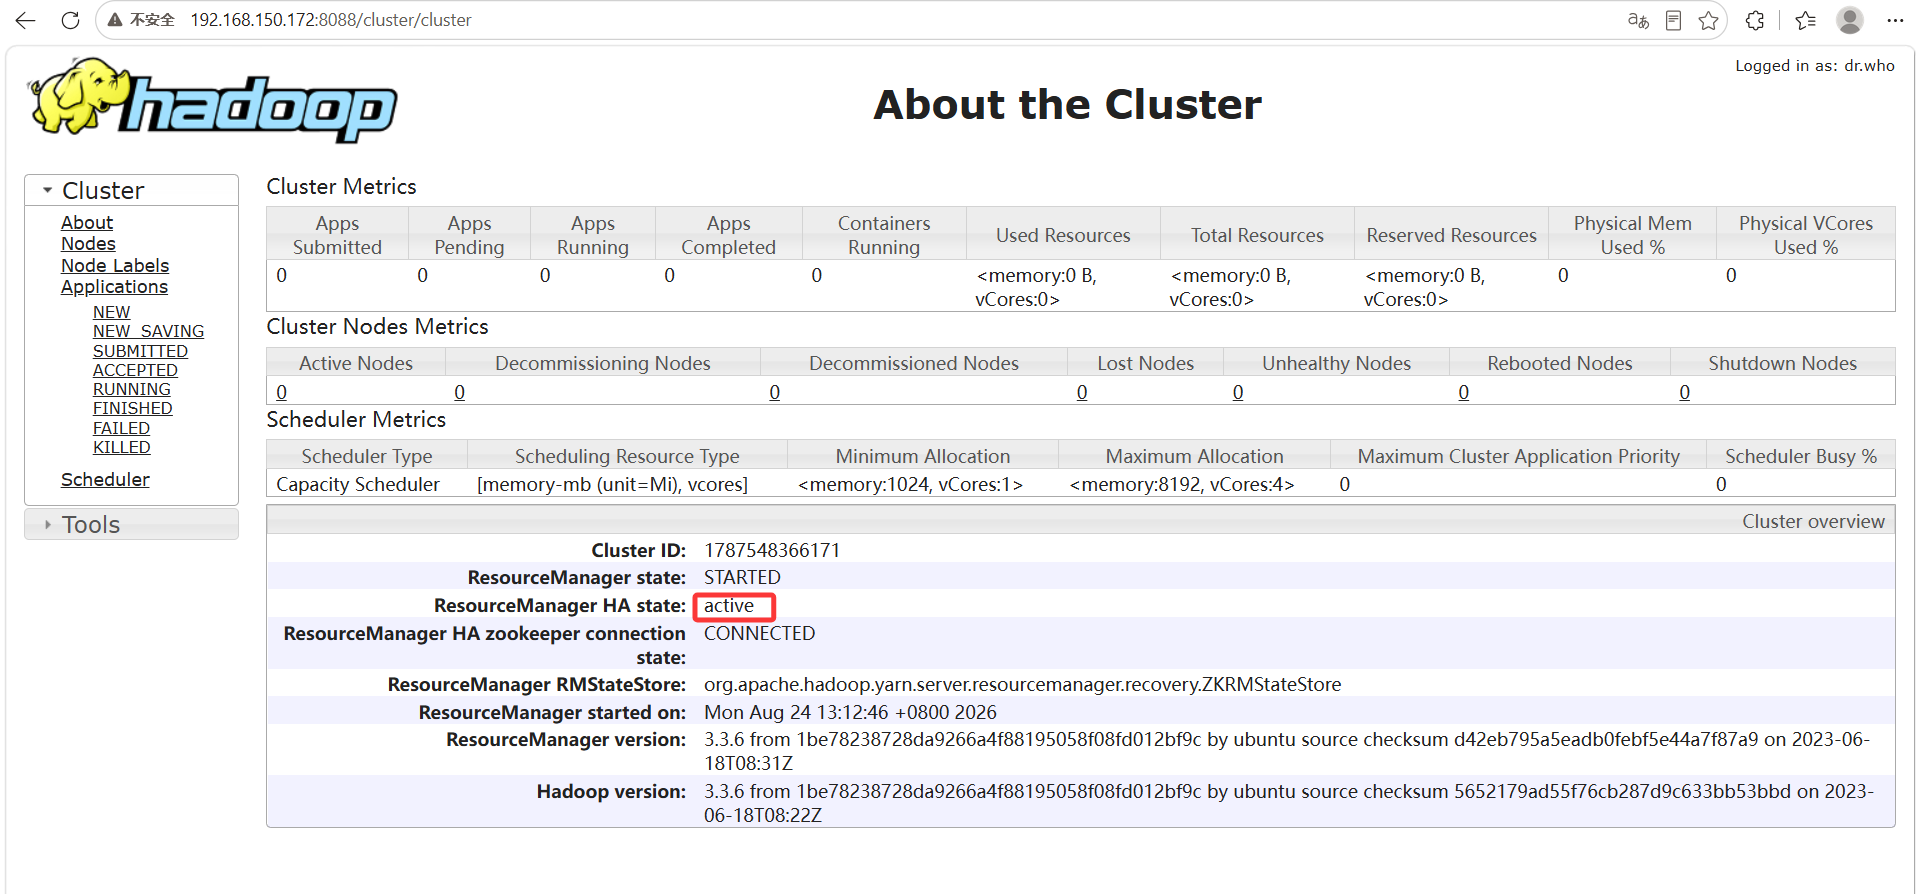
测试yarn故障切换
初始是server5是active
《hadoop高可用架构》 是转载文章,点击查看原文。