机器学习:决策树1--ID3决策树和C4.5决策树

作者:tellmewhoisi日期:2026/9/19


公式

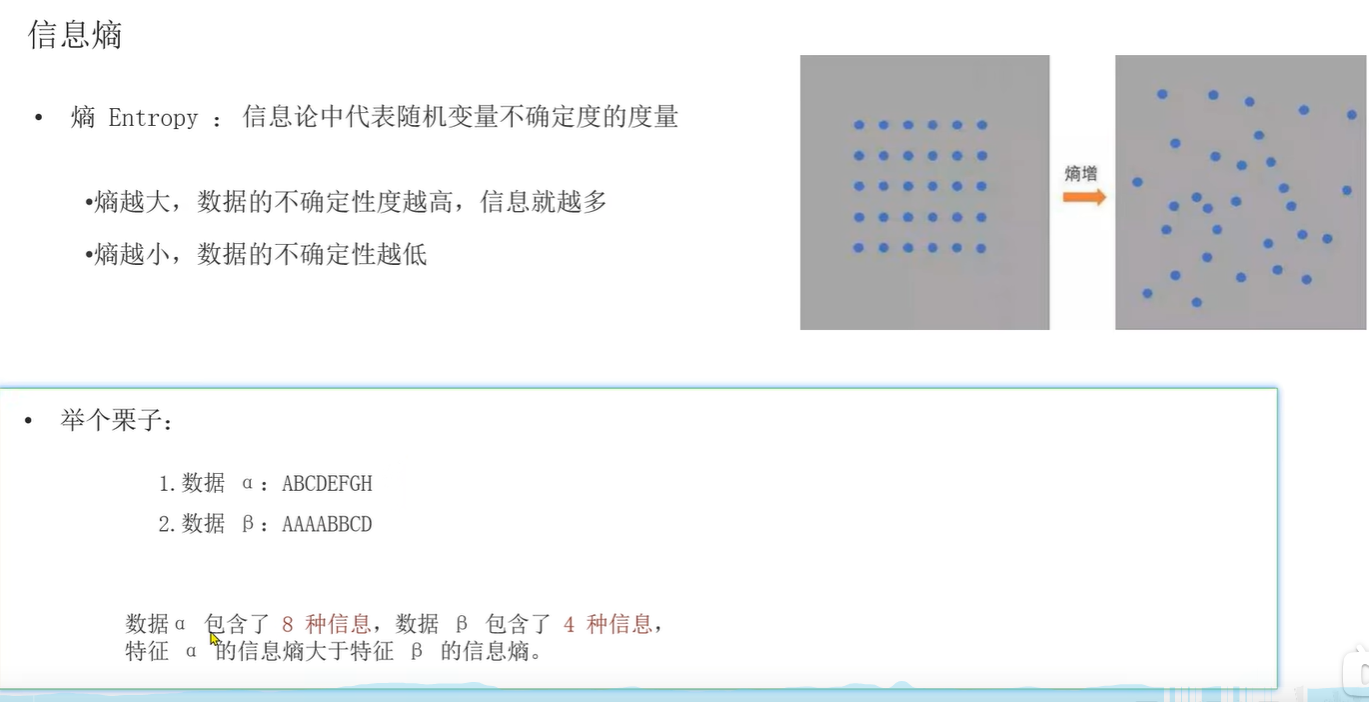
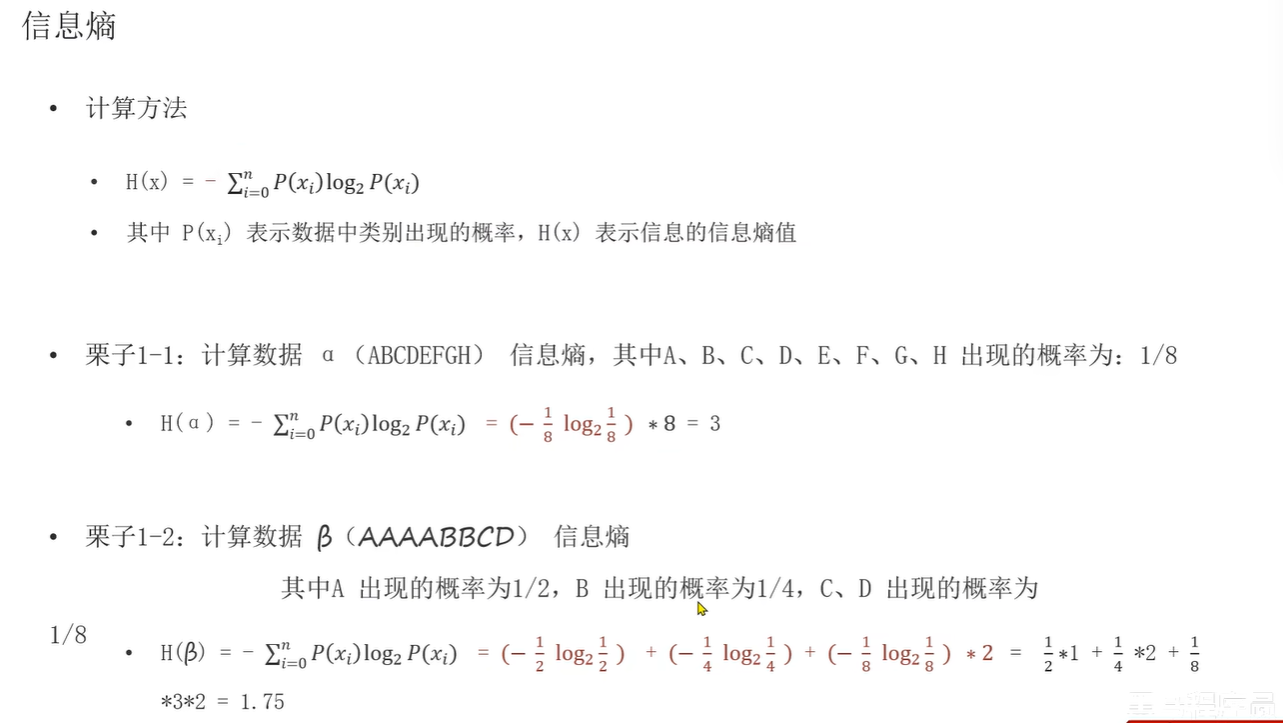
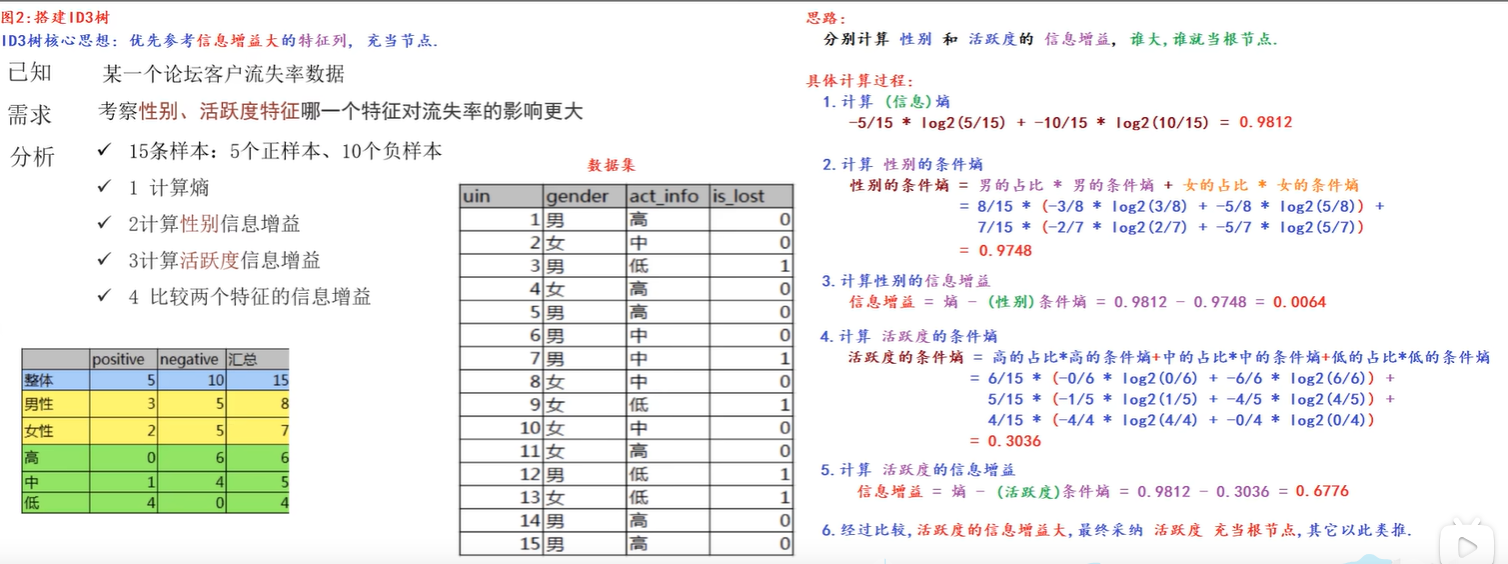
(信息)熵 = ∑ -分类占比 * log 2(分类占比)
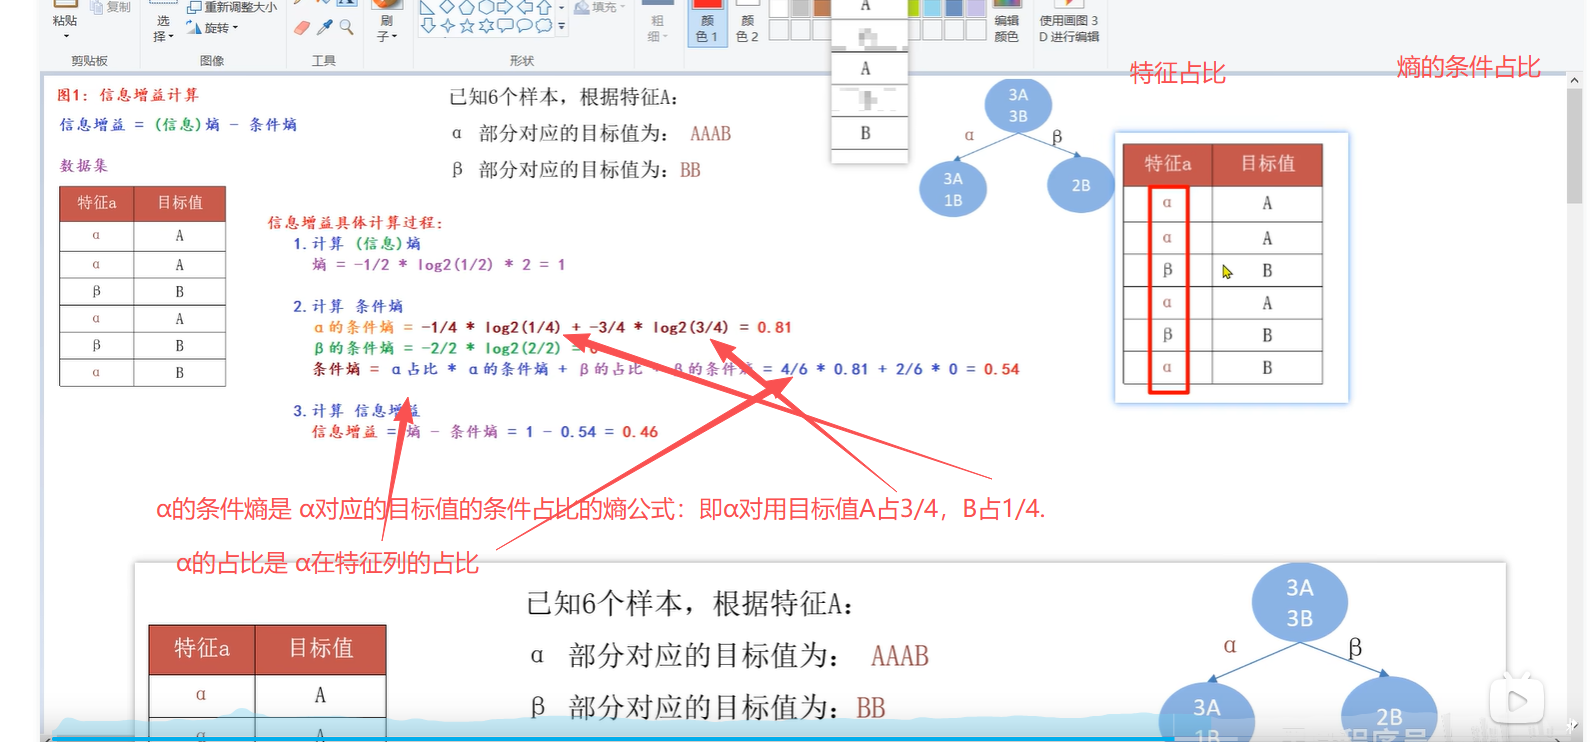
信息增益
实际案例:信息增益
实际案例:信息增益率
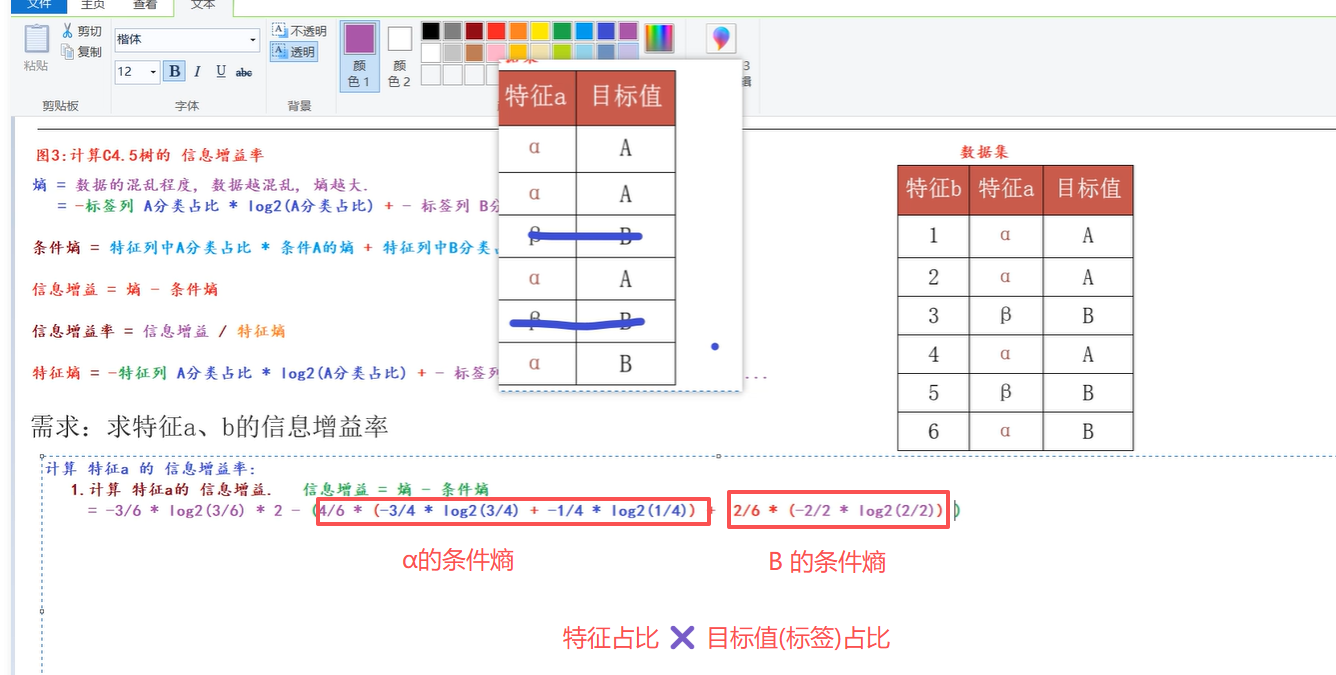


为啥选择信息增益率,不用信息增益?信息增益弊端是啥
因为信息增益等于 熵 - 条件熵
实际案例:信息增益率 中可以看出来,一个特征如果分类多(特征b),他的条件熵很小,一个特征如果分类少(特征a),他的条件熵很大。 但是无论特征多,还是特征少,他们的熵是一致的。
所以 信息增益等于熵 - 条件熵 的情况,会一直选择 特征分类多的。

特征分类越多,模型越容易在训练集上表现完美,但在测试集上表现很差。信息增益的弊端就是它无法区分“真正有用的分类”和“仅仅是把数据切碎的无效分类”。

举个例子:我们在做一个“是否购买电脑”的预测,数据里有 10 个人,其中 5 个买、5 个不买(熵 = 1)
现在有两个特征:

  • 特征 A(年龄):分为“青年、中年、老年” 3 类。
  • 特征 B(身份证号):分为 10 类,因为每个人身份证号都不同。

如果用信息增益来选特征,会发生什么?
看特征 B(身份证号):它把 10 个人分成了 10 个小组,每组只有 1 个人。对于每个小组,要么是“买”,要么是“不买”,纯度 100%。所以它的条件熵 = 0。那么它的信息增益 = 1 - 0 = 1(最大值)。
看特征 A(年龄):虽然把人群分成了 3 组,但每组里可能还是有买有没买的,纯度没那么高。假设它的条件熵 = 0.8。那么它的信息增益 = 1 - 0.8 = 0.2。

结论信息增益会毫不犹豫地选择“身份证号”这个特征。

但“身份证号”这个特征对于预测“是否买电脑”毫无意义,它只是把数据切碎了,产生了过拟合,不能泛化到新数据


机器学习:决策树1--ID3决策树和C4.5决策树》 是转载文章,点击查看原文


相关推荐


误推 master 该 revert 还是 reset?撤销与补 MR 流程
是2的10次方啊2026/9/11

前两天开发完一个功能,习惯性 git commit、git push——刷新远程,提交直接落在了 master。CI 已经跑了一分钟,群里有人问谁合的。 一句话结论:已 push 到共享 master → git revert;只在本地、还没 push → git reset。 一、revert 和 reset 怎么选 git revertgit reset做法新增反向 commit,原 commit 仍在移动分支指针,可抹掉 commit远程


【AI 应用 -- 白话大模型(篇八)】《从零系统学习 AI Skill之起源发展、文件结构、编写原则、机制原理与项目实战案例》
j7~2026/9/3

Skill 1.背景 关键时间时间线 从 2023 年到 2026 年,AI 大模型 “调用工具” 和 “执行任务” 的能力经历了四次关键跃迁。这条时间线记录了从工具调用雏形到多代理生态平台的完整技术路径。 2023.06|OpenAI Function Calling —— 工具调用的雏形 这是最早让 AI 模型能够主动请求调用外部函数的标准化接口,首次赋予大模型与外部系统交互的能力,为后续所有工具调用协议奠定基础。2024.11|Anthropic MCP —— 连接工具与数据


Apple Foundation Models PCC 申请与使用:从权限到真机验证
沐风AI2026/8/26

Apple 又送钱来了。 如果你正在开发 iOS 或 macOS App,想给用户加入总结、改写、翻译、文档问答等能力,Apple Foundation Models 的 PCC 方案值得认真看一遍。它的关键价值不是“又多了一个大模型 API”,而是:在符合条件并拿到权限之后,App 可以通过原生 Swift 框架访问 Apple 的 Foundation Model,不要求你在客户端塞入 OpenAI、Claude 或 Gemini 的 API Key。 但这件事也最容易被一句“无需 AP


Vue3 表单编辑器:左侧控件菜单 + 中间编辑区的拖拽全流程实现
今天吃了嘛o2026/8/13

Vue3 表单编辑器:左侧控件菜单 + 中间编辑区的拖拽全流程实现 基于 Vue3 + vuedraggable + Pinia 实现的表单编辑器,涵盖从左侧菜单拖拽添加控件、点击添加、中间区域排序调换、复制删除、切换题型等核心交互。本文只摘取代表性代码,梳理整体流程和设计思路。 目录 一、整体架构与数据流二、技术选型三、左侧控件菜单(form_menu_drag.vue)四、中间编辑区(form_render_drag.vue)五、Pinia Store 核心方法(edit


分链路差异化设计的DSP准实时数仓|钛动科技基于阿里云实时计算 Flink 版 + DLF Paimon + EMR Serverless StarRocks 的实践
阿里云大数据AI技术2026/8/4

作者:赵阳,钛动科技 DSP 大数据架构团队 在 DSP 广告业务中,数据链路需要同时支撑在线投放、计费、Ad-hoc 分析和 BI 报表等多类场景。不同场景对数据新鲜度、查询延迟、回刷能力和存储成本的要求差异很大。如果继续用一套统一链路承载所有数据,系统很容易在成本、性能和稳定性之间相互牵制。 钛动科技 DSP 广告链路的核心数据流可以概括为:Request、Response、Impression、Click 和 Postback。随着业务规模增长,原有架构逐渐暴露出三个问题:数据规模持续扩


Java Undertow 实战指南:从轻量 Web Server 到 Spring Boot 嵌入式容器
唐青枫2026/7/27

简介 Undertow 是一个轻量级 Java Web Server。 它可以直接嵌入到 Java 代码里运行,也可以作为 Servlet 容器使用,还曾经是 WildFly 的默认 Web Server。 简单理解: Undertow = 轻量 HTTP Server + Servlet 容器 + WebSocket 支持 它和 Tomcat、Jetty 一样,都可以承载 Java Web 应用。 但 Undertow 的风格更偏底层、更偏嵌入式:一个 HTTP 服务可以由几个 Handle


Kimi k3是真碉,但太不经用,也有拉跨点!
甲维斯2026/7/19

K3 已测,确实强,但要命的是配额太少了! 一天不到,一周的配额已经烧完了,大概就生成了 5 个测试页面! 从五个例子中,可以知道,有些确实很强,有些呢又差点意思,有些比较糟糕。 我不是那种收钱办事儿只会吹牛逼的博主,我也不会针对 Kimi 只说它的缺点。我会依次给大家展现测试结果,同时和其它国产模型,和国外的 GPT 5.6 和 Fable 5 做一个对比,尤其是 Fable 5! 下面我就一点一点来说,看完这篇文章大家应该对K3有一个相对全面的解了。 这篇文章,我要先从这张图片说起:


【中阶·安全】大模型逆向攻击与数据隐私保护深度解析:从模型反演到差分隐私防御的全链路实战
AI智能专家2026/7/10

【中阶·安全】大模型逆向攻击与数据隐私保护深度解析:从模型反演到差分隐私防御的全链路实战 专栏:《AI 工程与安全深度实战》· 第6轮·第2篇 前言 核心痛点:大模型不仅记住了训练数据中的知识——在某些条件下,攻击者可以通过模型输出反推出训练数据中的敏感信息(个人身份、医疗记录、专有代码),这对模型发布方的隐私合规和用户信任构成根本性挑战 适配人群:AI 安全工程师、隐私合规负责人、对模型隐私保护有深度学习需求的 ML 工程师和安全研究员 收获能力:读


暑假CSP-S NOIP集训学生要做哪些内容,集训完如何消化所学的知识
dllglvzhenfeng2026/7/2

暑假是 CSP-S 向 NOIP 进阶的‌黄金窗口期‌,集训核心在于‌体系化构建高阶算法能力‌与‌实战应试策略‌。以下是针对 CSP-S/NOIP 层级学生的集训内容及赛后消化方案: 一、暑假集训核心内容 集训需遵循“理论精讲 + 专项刷题 + 全真模考”闭环,重点突破以下模块: 1、‌高阶算法深度攻坚‌ (1)、‌动态规划(DP)‌:         从线性 DP 延伸至树形 DP、区间 DP、状压 DP 及斜率/四边形优化,重点训练状态设计与转移方程推导 。


Unity之使用火山引擎实现流式语音合成|优化版本
心前阳光2026/6/23

初始版本 Unity之使用火山引擎实现流式语音合成 优化版本 优化内容: 原始版本使用NativeWebSocket插件,无法获取X-Tt-Logid,使用WebSocketSharp插件解决这个问题提取两个插件的共性,可依据需要替换 示例 通信类 websocket通信基类 using UnityEngine; using System; /// <summary> /// 文字转语音 /// </summary> public abstract class BaseTextT

首页编辑器站点地图

本站内容在 CC BY-SA 4.0 协议下发布

Copyright © 2026 聚合阅读