OctaFuse Gateway 2.20.0 的重点是 MCP 授权:Gateway 现在自己就能充当 OAuth 授权服务器。把 Gateway 的 MCP 服务提供给外部用户时,用户在 ChatGPT、Claude、Codex 这类客户端里点「连接」,用你业务系统的账号登录并同意,就能直接使用,不用复制 API Key;你的业务系统只负责登录和同意,不需要再保存任何 OAuth 状态。
另外两项日常会用到的变化:请求日志合并了原来的「调用记录」,模型请求和工具调用放在一起看,并支持按类型、模型、供应商多选筛选;网页搜索、网页抓取和深度搜索新增 DeepSeek 引擎。
这一版有一条必须先执行的数据库迁移 0036,只新增表和可空列。升级后默认不启用内置授权服务器,现有 MCP 接入方式不变。
01|MCP 授权:用业务系统账号直接登录
2.18.0 引入 MCP OAuth 时,Gateway 只是资源服务器:你得自己运行一套授权服务器,负责客户端注册、令牌签发和刷新,再通过 Admin API 为 Gateway 签发访问令牌。这一版把这些都放进了 Gateway。
现在的流程是:
- 用户在 MCP 客户端里添加你的 Gateway 地址,点击连接。
- 客户端自动到 Gateway 注册,浏览器跳到你业务系统的登录与同意页。
- 用户用业务账号登录、点同意,客户端拿到一个只能访问 MCP 的令牌,开始调用工具。
- 令牌每小时到期,客户端自动刷新,用户不用反复登录;调用费用记在用户对应的网关账户上。
在你这一侧,业务系统只需要提供一个登录与同意页:拿到 Gateway 带过来的 request_id,确认用户已登录后,用带 oauth.consent 权限的集成密钥把用户的同意或拒绝告诉 Gateway。暂时不想接入自己的站点时,也可以先用内置确认页,让用户用自己的 API Key 确认。
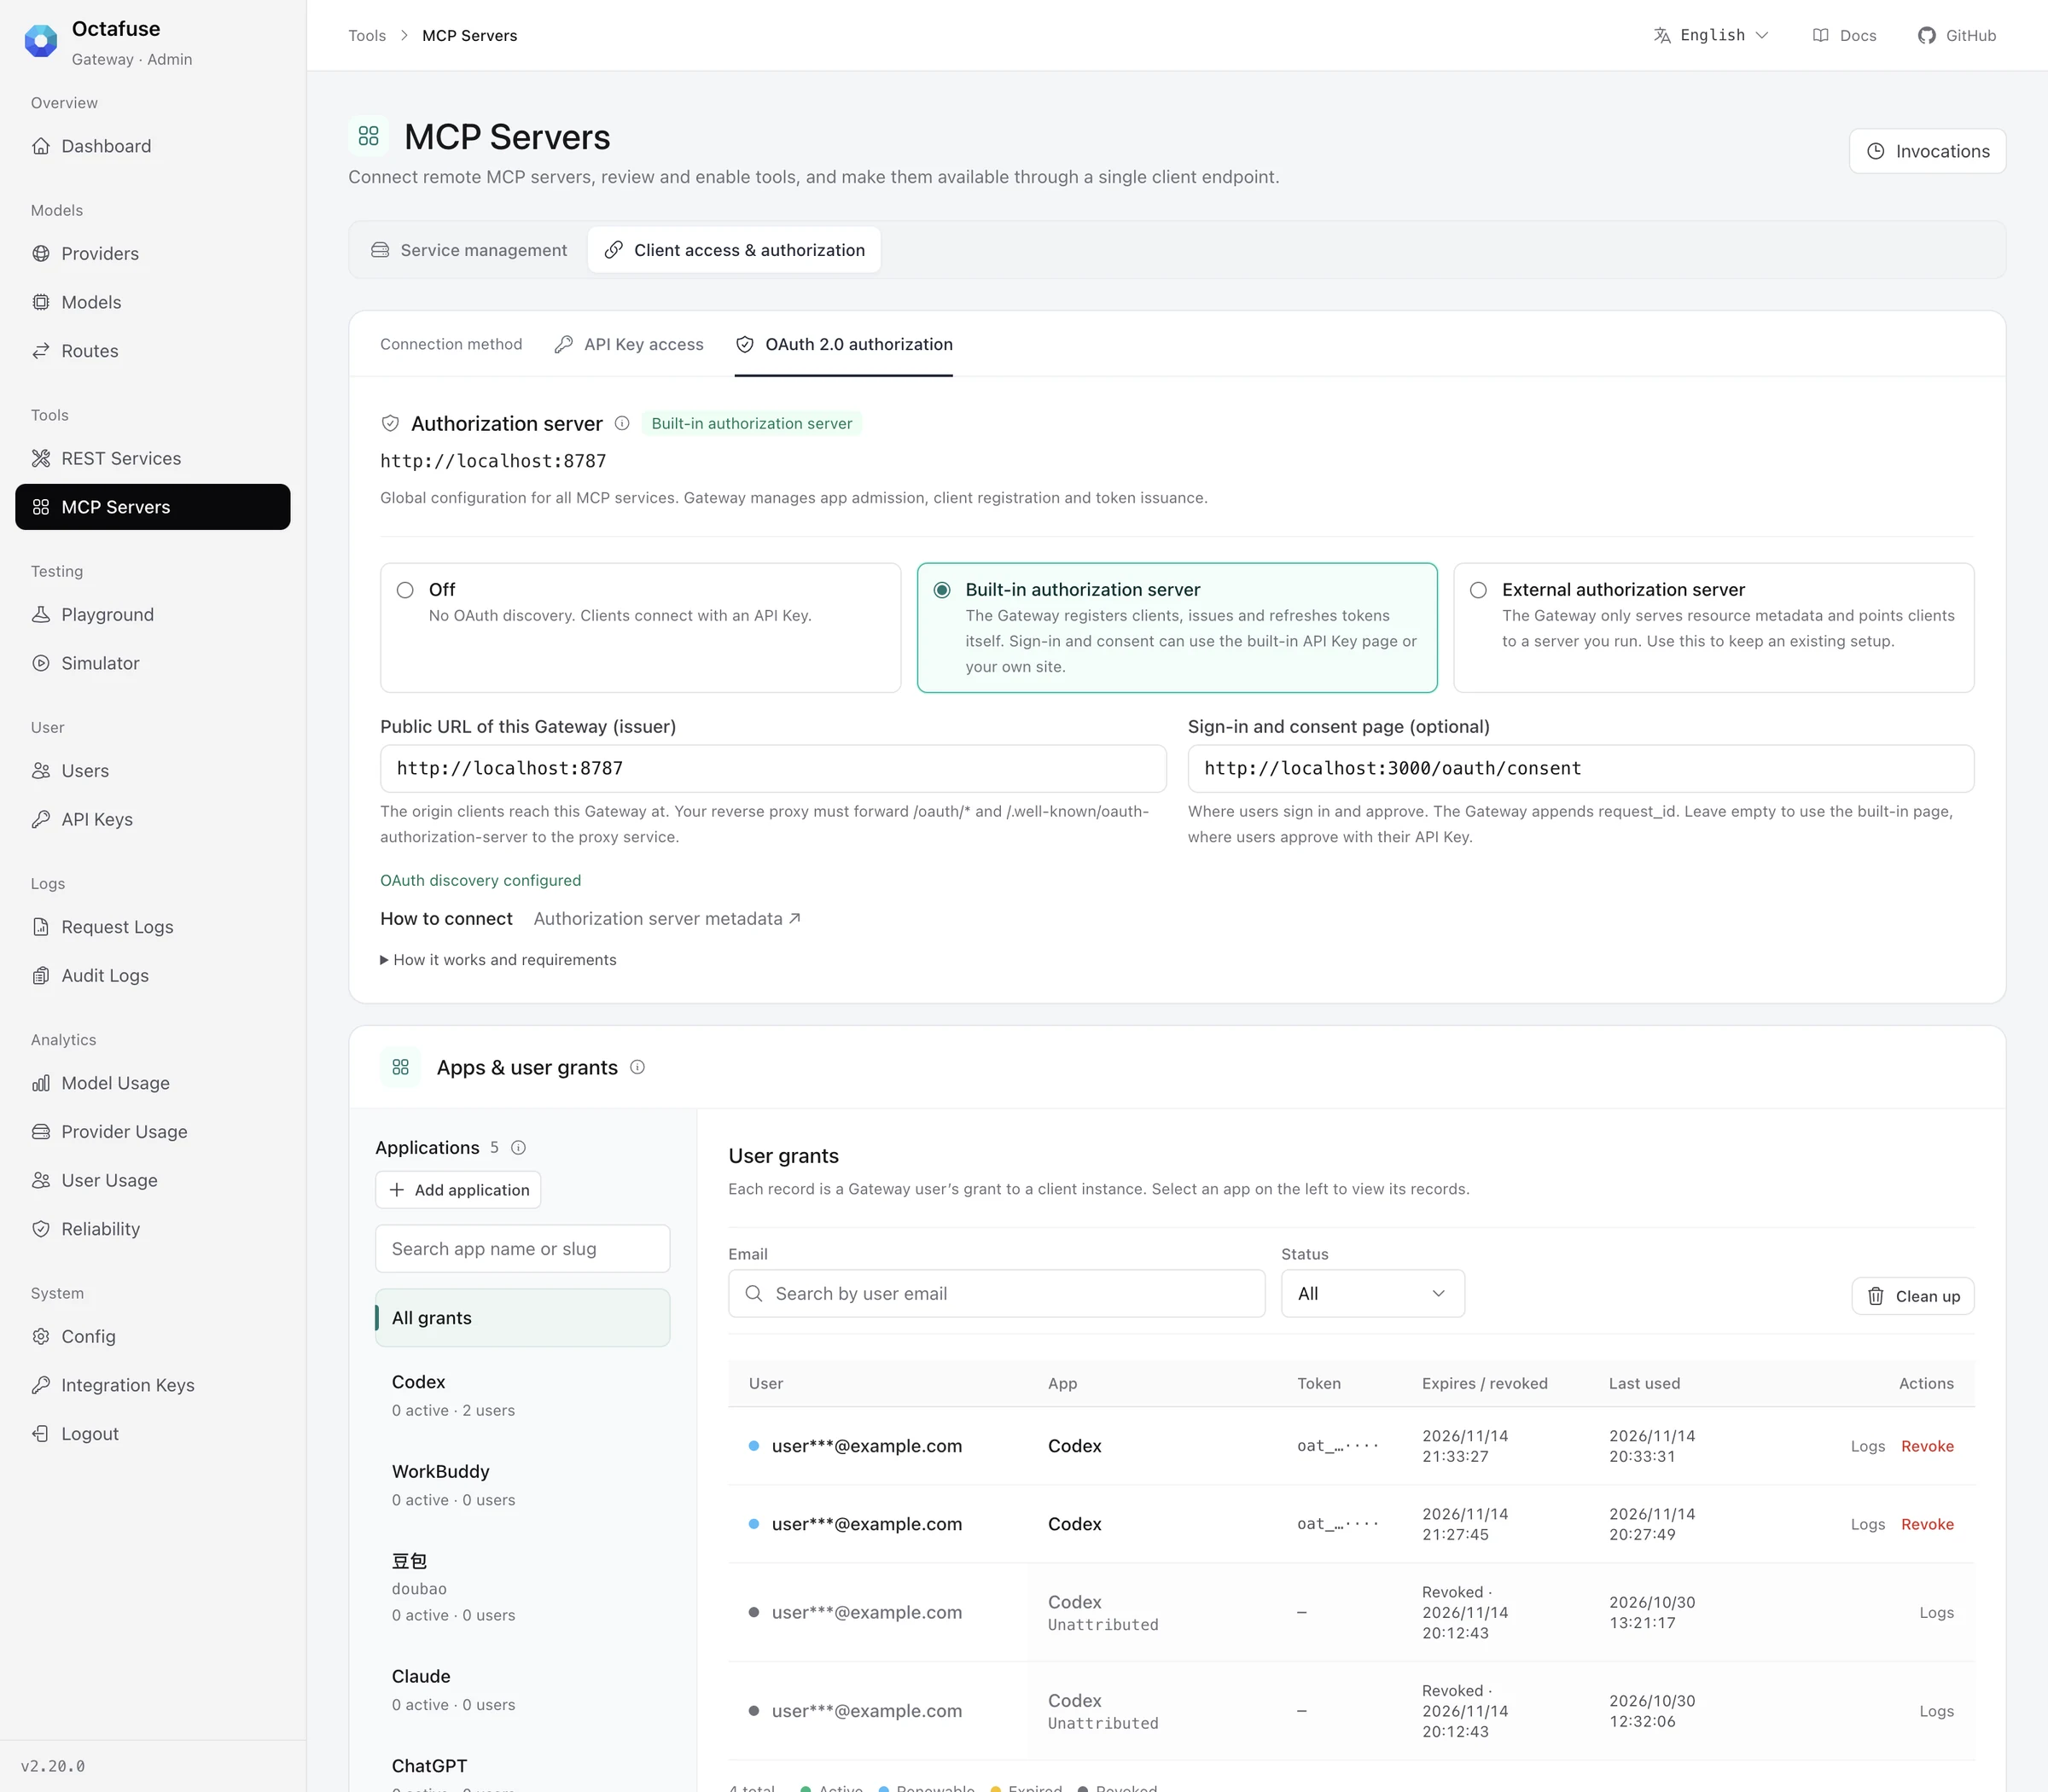
MCP 服务 → 客户端接入 → OAuth 2.0(英文界面)。卡片里选中的是「内置授权服务器」,下方左侧是应用目录,右侧是各应用下的用户授权记录。用户邮箱已遮盖,令牌只显示前缀。
MCP 服务页「客户端接入」里的 OAuth 卡片现在有三种模式:
| 模式 | 什么时候选 |
|---|---|
| 内置授权服务器 | 推荐。Gateway 负责客户端注册、令牌签发和刷新,业务系统只做登录与同意。 |
| 外部授权服务器 | 已经有一套自己的授权服务器,想保持现状。 |
| 关闭 | 不公开 OAuth,客户端用 API Key 接入。 |
哪些客户端可以接入,由「应用」目录决定:客户端按回调地址归属到某个应用,没有匹配应用的客户端无法注册。后台提供 ChatGPT、Claude、Codex、豆包、WorkBuddy 预设,一键导入即可。之后可以按应用查看有多少用户、多少客户端实例在用,随时停用某个应用或撤销它的全部授权。
从外部授权服务器切换过来的部署,旧授权会在访问令牌过期后失效,用户重新授权一次即可;想回到原来的方式,在卡片里切回「外部授权服务器」,立即生效。配置步骤见 MCP OAuth 授权。
02|请求日志:模型请求和工具调用放在一起看
原来 REST 工具和 MCP 工具的调用在单独的「调用记录」页,排查一次 Agent 任务要来回切换。这一版把它并入「请求日志」,侧栏新增「日志」分组收纳请求日志与审计日志;旧的调用记录地址会带着原有筛选跳转过来。
「类型」「模型」「供应商」三个筛选都改成两级多选,勾选的项取并集:
- 类型分模型(LLM、图像、ASR、TTS、向量)和工具(各个 REST 工具、各个 MCP 服务),比如可以同时看图像请求和某个搜索工具的调用。
- 模型按厂商分组,供应商按类型分组,可以勾选整组,也可以只选其中几个。
- 筛选之间会联动:范围里只有工具调用时,模型、供应商、路由组这些筛选会自动置灰。
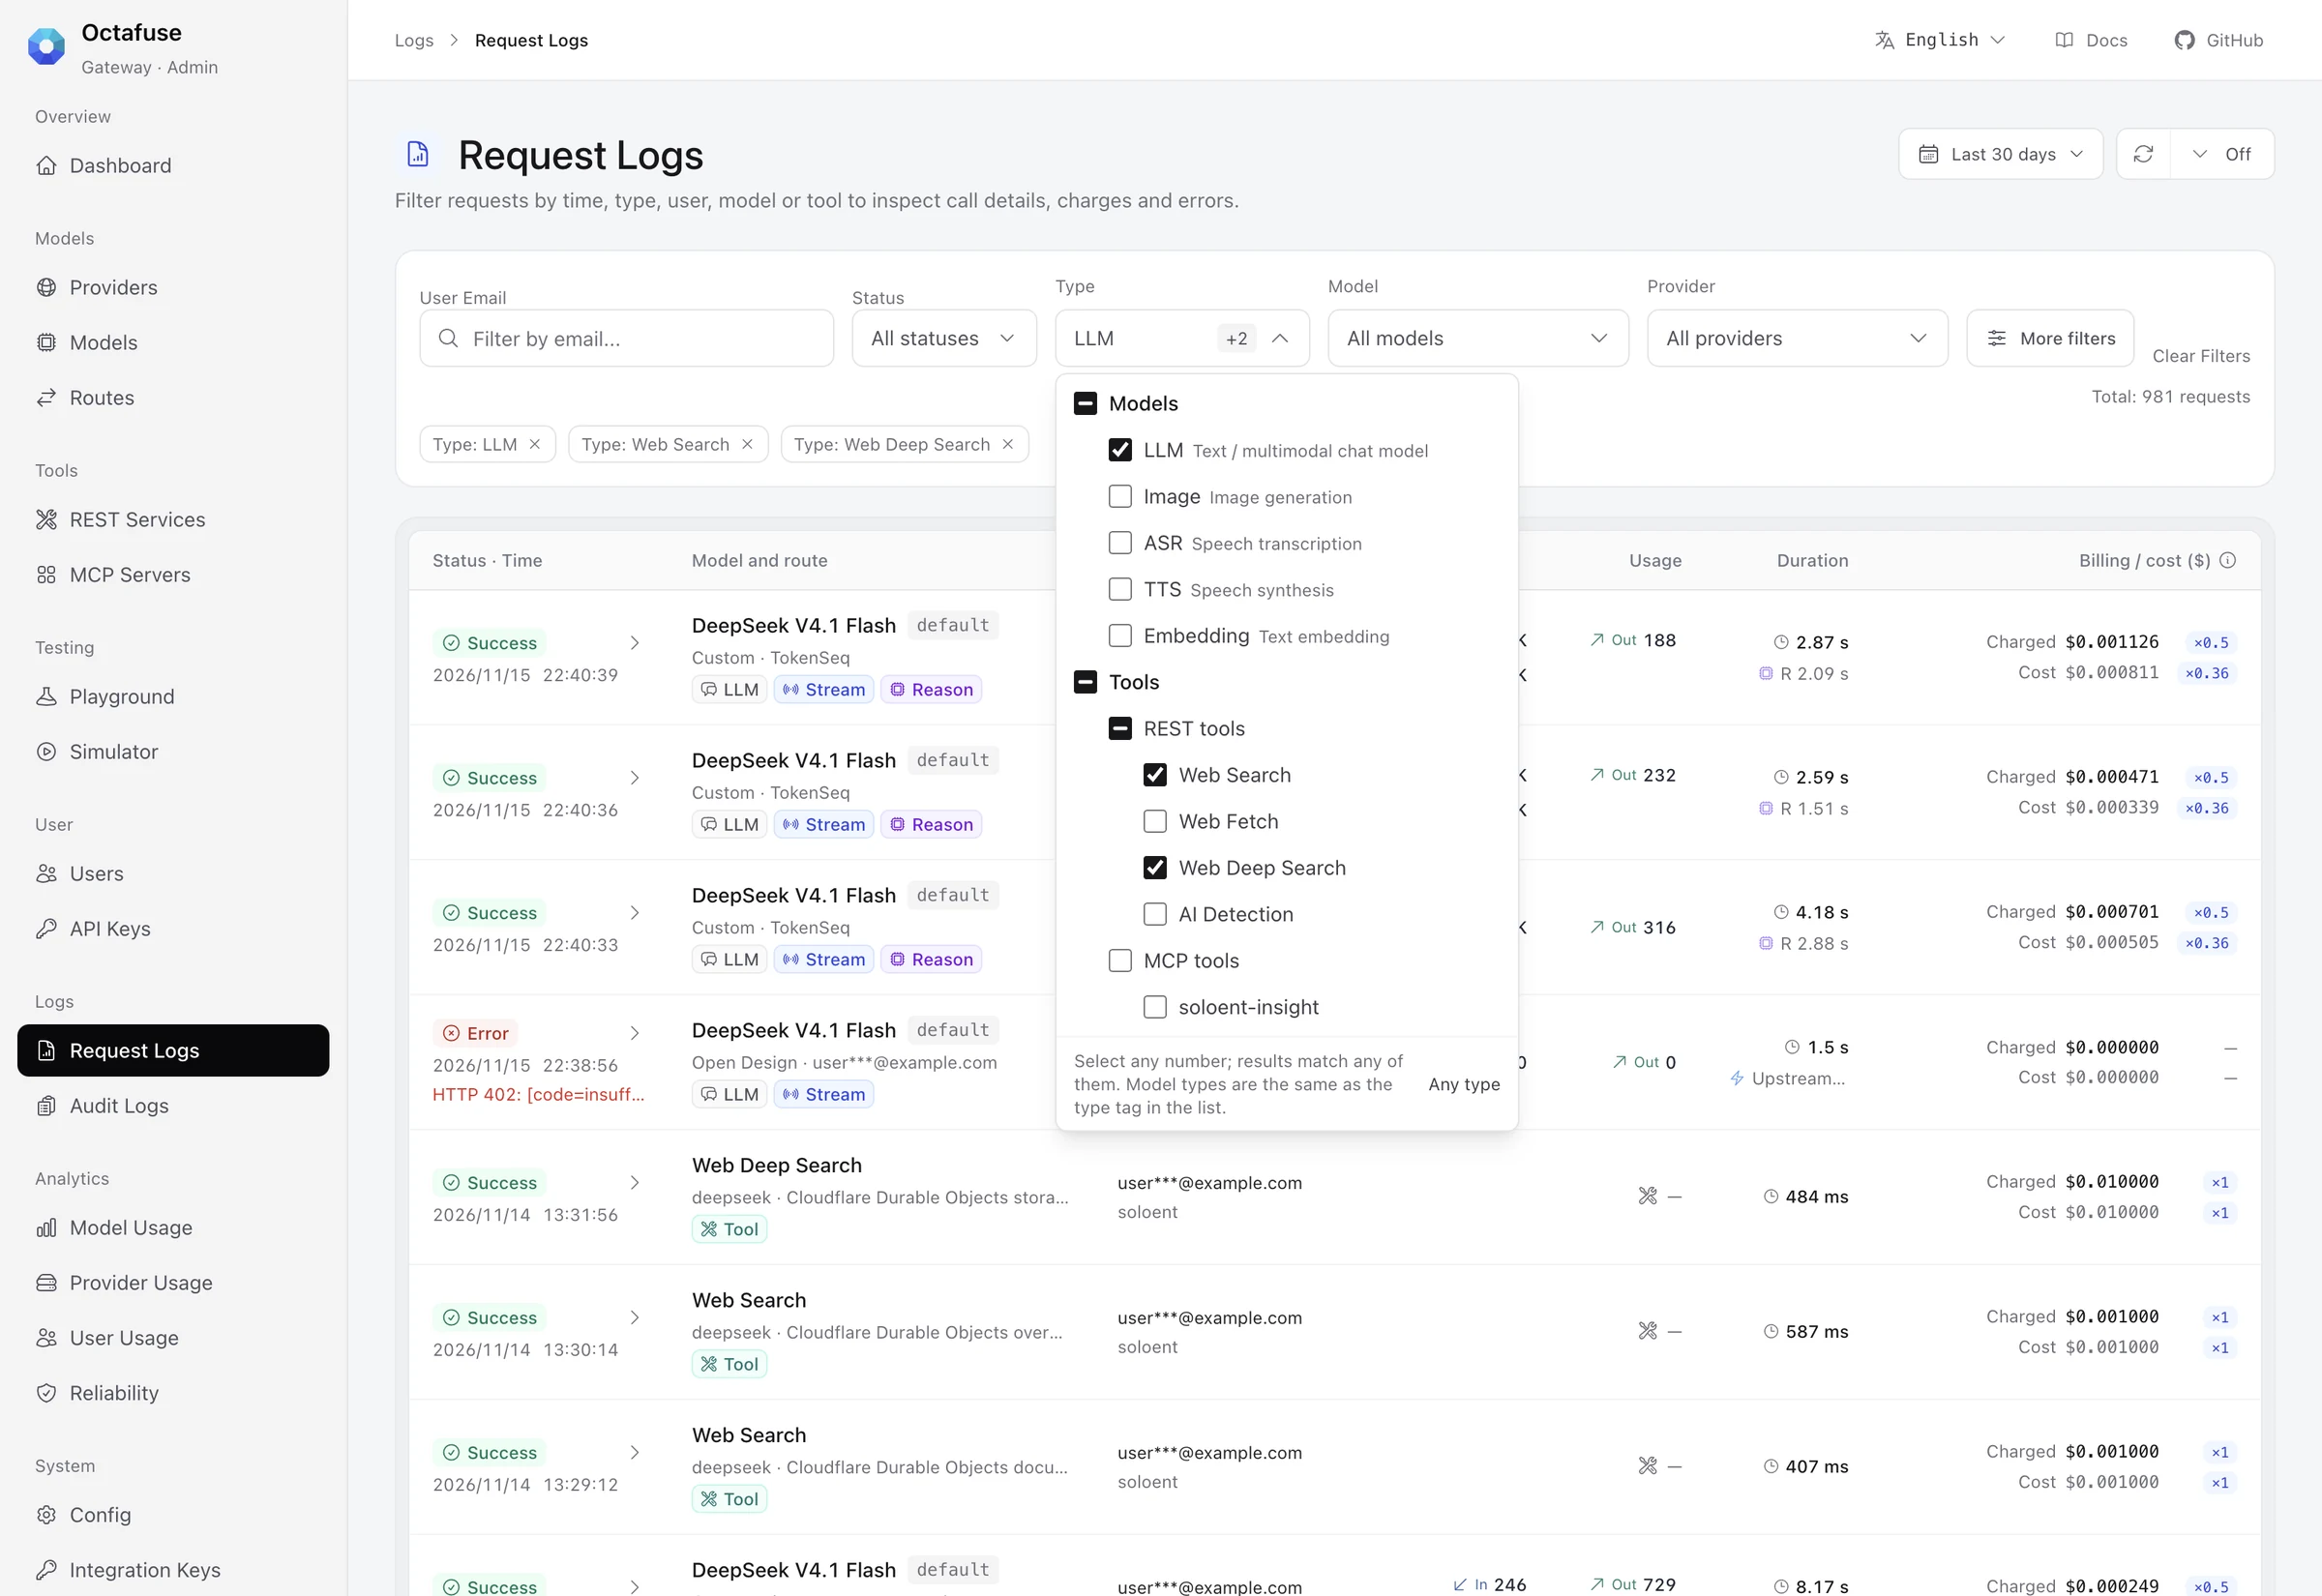
「类型」筛选展开后分为模型和工具两级(英文界面)。勾选 LLM、Web Search、Web Deep Search 后,已选条件以标签显示在筛选栏下方,列表里模型请求和工具调用一起出现。用户邮箱已遮盖。
工具调用的详情也不再套用模型的请求流程,改为按调用概览、请求、响应、记账展示:REST 工具能看到引擎、请求参数和搜索结果,MCP 工具能看到服务、上游工具、调用参数和返回内容。调用失败时,顶部直接给出错误原文和排查方向,并能一键打开对应的工具配置或 MCP 服务。
需要盯着线上请求时,可以开启自动刷新(10 秒到 5 分钟),新日志会滑入并短暂高亮;正在阅读列表时,会先提示有新日志,不会打断当前位置。
03|搜索与抓取新增 DeepSeek 引擎
网页搜索、网页抓取和深度搜索三个 REST 工具新增 DeepSeek 引擎,对接 DeepSeek 独立的 Search / Fetch API。对外接口不变,已经接入 /v1/tools/* 的应用不用改代码。
在「REST 服务」页为对应工具配置 DeepSeek 供应商、填入 API Key 并保存,再在「使用状态」列启用即可。使用前留意几点:
- 查询词最长 128 个字符,超出部分由 Gateway 截断。
- 域名白名单 / 黑名单能放进查询词时以
site:/-site:下发,放不下时多取结果后在本地过滤。 - 上游刊例价为每千次成功请求 $0.75,请自行设置标准价与倍率;Gateway 对空结果仍按次计费。
04|仪表盘与后台的其他改进
- 仪表盘:补充费用关系、首响应与请求耗时 P95、故障转移、异常供应商和错误构成,可与上一个等长时段对比;实时吞吐以 RPM、TPM 显示近 60 秒的情况。点击指标会带着时间范围跳到对应日志。自动刷新默认关闭,可选 10 秒到 5 分钟。
- 导航:统一使用「模型」「工具」两个名称,调试台和模拟器归入新的「测试」分组。模拟器顶部可以在模型和工具之间切换。
- REST 服务:按生效概要、供应商与计费、接入文档三个区域组织,接入文档给出可复制的 cURL,以及 OpenAI、Anthropic 等格式的 Agent 工具定义。
- MCP 服务:服务目录与详情分栏,客户端接入按 API Key 与 OAuth 2.0 分开。
- 统一 Proxy 地址:Admin 新增可选的运行时变量
GATEWAY_PROXY_URL,REST 文档、模拟器和 MCP 接入默认使用同一个 Proxy 地址,也可以在浏览器里临时覆盖。 - 金额与倍率:后台统一金额和倍率的显示方式,金额保留币种与精度,倍率用独立标识,计费结果不变。
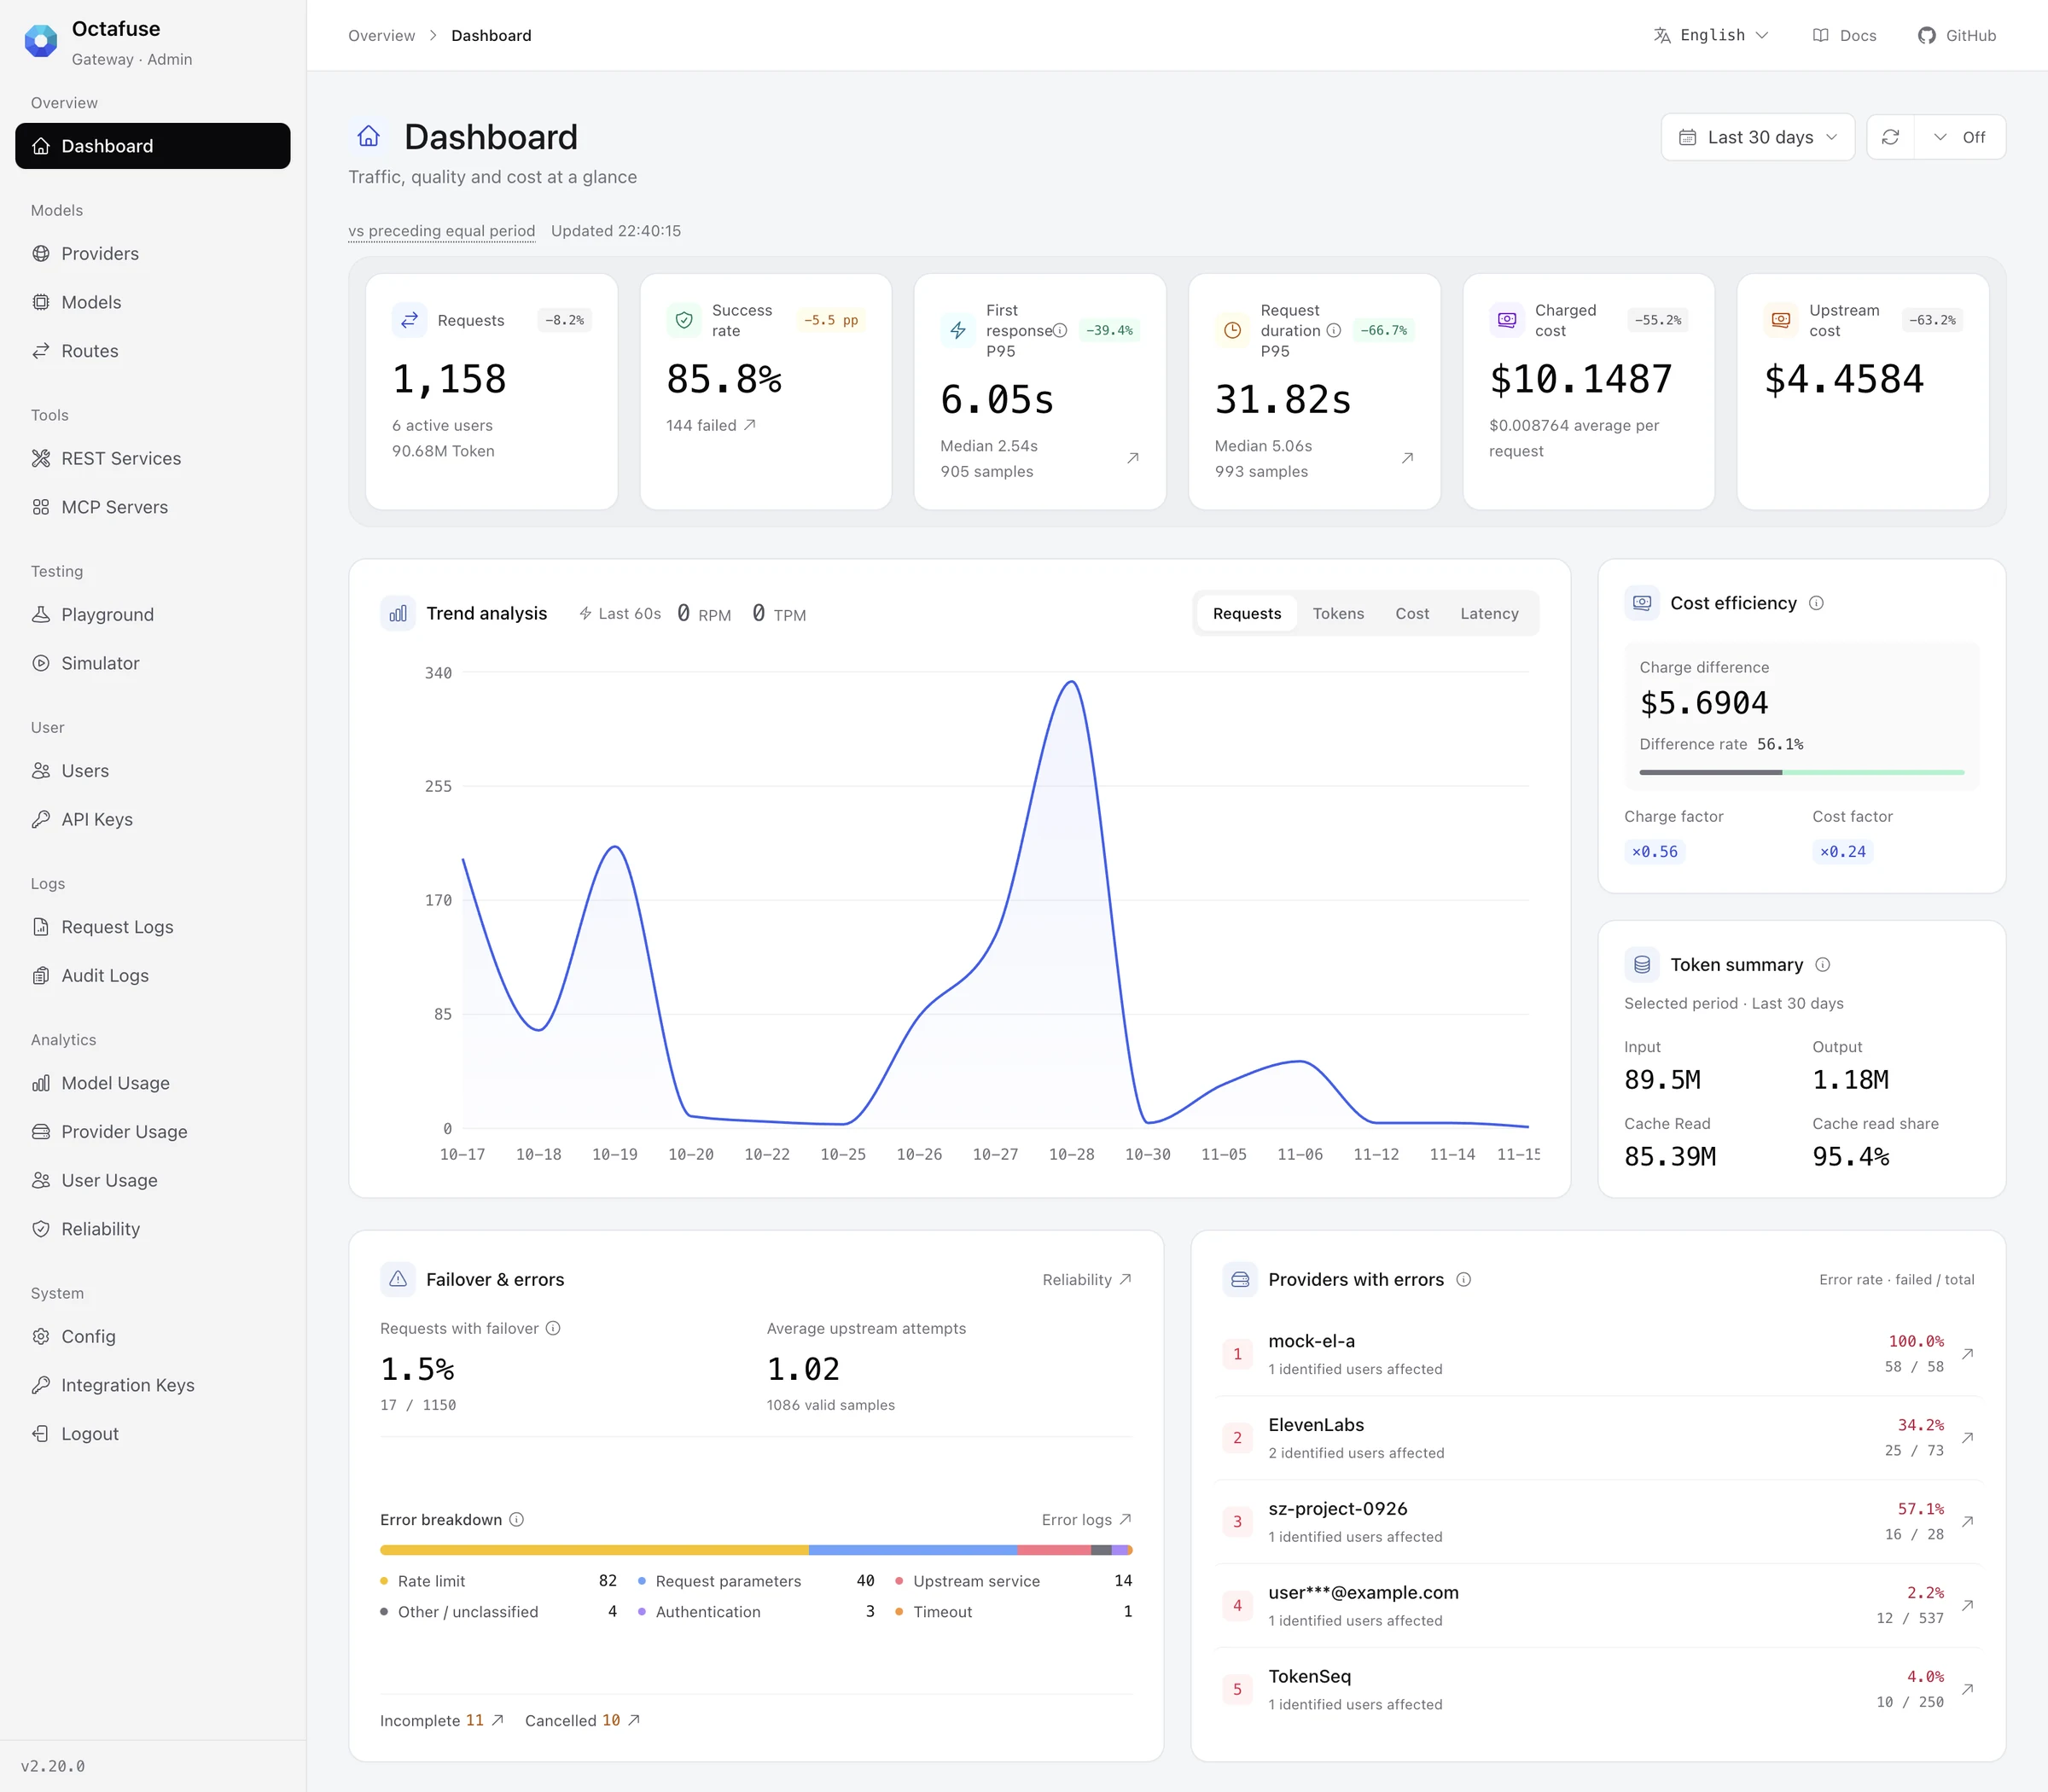
仪表盘(英文界面,时间范围为近 30 天)。顶部是请求数、成功率、首响应与请求耗时 P95、收费和上游成本;下方依次是趋势、费用关系、Token 汇总、故障转移与错误构成,以及异常供应商。用户邮箱已遮盖。
05|模型目录
已导入的模型不会被覆盖,导入也不会自动挂路由;新模型需要手工导入并配置路由。
| 模型 | 说明 |
|---|---|
| Gemini 4 Hydrogen | gemini-4-hydrogen(2026-11-12),上下文 1M、同步最大输出 64K,输入含文本、图像、音频、视频和文件。整个 1M 窗口统一价:输入 1.50、输出1.50、输出 1.50、输出7.50 / 百万 tokens,隐式缓存读取 $0.075。思考档位 low、medium、high、xhigh,默认 high。 |
| Gemini 4 Carbon | gemini-4-carbon(2026-11-10),上下文 1M、同步最大输出 64K。按 Standard 刊例价记录:输入 4、输出4、输出 4、输出20 / 百万 tokens,隐式缓存读取 $0.20。官方限时折扣请在路由的计价配置中设置供应商折扣。 |
| Qwen4 Max Preview | qwen4-max-preview(2026-11-11),上下文 1M、最大输出约 393K。仅在 Token Plan 订阅提供,官方未公布刊例价,暂按 qwen3.8-max 对齐;预览期至 2026-11-25,目录已写入退役日期。 |
| MiniMax H3 Image | minimax-h3-image 与 minimax-h3-image-highspeed(2026-11-10),按官方 token 刊例计费;中国区使用官方人民币价,不是美元 ×7。路由的上游模型名分别填 MiniMax-H3-Image 与 MiniMax-H3-Image-Highspeed。 |
另外,gpt-image-2 写入了 OpenAI 公布的停服日 2027-02-10。完整规格和价格见 模型目录。
06|安全修复
Node 运行时的 @hono/node-server 升级到 2.1.8,修复请求路径反斜杠解析,以及异步 WebSocket 升级期间连接重置的漏洞。使用 Docker 或 Node 部署的实例建议尽快升级。
升级须知
从 2.19.0 升级到 2.20.0 需要先执行迁移 0036。 D1、Postgres、MySQL 都有对应脚本,只新增表和可空列;旧版 Proxy / Admin 配合已迁移的库可以正常运行。
- 备份数据库,执行 0036。
- 将 Proxy、Admin 和 migrate 三个镜像更新到同一版本,再滚动重启。
- 升级后抽查请求日志的新筛选、工具调用详情和 MCP 服务页。
升级时还需留意:
- 内置授权服务器默认不启用:
MCP_OAUTH_ISSUER为空时行为与升级前一致。要启用,需要在每个部署区分别准备应用目录、同意页、集成密钥和反向代理转发,见 MCP OAuth 授权。 - 集成密钥权限:调用
/api/admin/oauth/*的集成密钥需要授予oauth.read、oauth.write或oauth.consent。 - 调用记录:旧地址
/gateway/tools/invocations会跳转到请求日志;GET /api/admin/request-logs新增的参数都是可选的。 - DeepSeek 计费:空结果仍按次计费,启用前先设置计费规则。
完整变更见 GitHub Release v2.20.0 和 更新记录,升级步骤见 升级与迁移。
如果 OctaFuse 对你的项目有帮助,欢迎在 GitHub 上点一个 Star 支持,也欢迎提交 PR。我们也在寻找对项目感兴趣的兼职或全职伙伴。

