目录
- 前言
- 一、从一个困惑说起
- 二、官方分三类产品,依赖上却是四层
- 三、四个层次逐层拆
-
- 第 1 层:积木(langchain-core)
- 第 2 层:运行时(LangGraph)
- 第 3 层:薄壳(create_agent + middleware)
- 第 4 层:套件(Deep Agents)
- 四、一张调用链图看清全貌
- 五、一次选型定位:该落到哪一层
- 六、工程化要点:双向认知
- 参考文献
前言
本系列贯穿一条英文概念主线:Agent Runtime → Harness。本文先建立整个系列的认知地基:为什么我们讲「四个层次」,而不是你更常听到的「三个框架」。
一、从一个困惑说起
如果你刚接触 LangChain 生态,大概率会被这三个词绕晕:LangChain、LangGraph、Deep Agents。
它们是三个递进的框架吗?是不是「先学 LangChain,再学 LangGraph,最后学 Deep Agents」?我该从哪个入手?为什么 LangChain 官网一会儿说自己是「框架」,一会儿又冒出一个「运行时」、一个「套件」?
这套困惑不是你的问题,是这个生态自己给自己挖的坑——它把产品和依赖层次两件事混在一起讲,读者自然分不清。
这篇先做一件事:把「三类产品」和「四个层次」同时摆在你面前,讲清楚它们各是什么、又怎么对应。 这是后面各篇的地基,值得现在花五分钟立稳。
二、官方分三类产品,依赖上却是四层
先看官方口径。官方把 Agent 开发生态分成三类(Runtime / Framework / Harness)[1]——LangChain 自家三个产品 LangGraph / LangChain / Deep Agents SDK 正好各占其一[2]:
| 官方类别 | 产品 | 一句话定位 |
|---|---|---|
| Runtime(运行时) | LangGraph | 控制 Agent(智能体)怎么执行:图、状态、检查点、流式 |
| Framework(框架) | LangChain | 提供组件和 create_agent 工厂 |
| Harness(套件) | Deep Agents SDK | 把一套内置中间件栈(各自注入常用工具)打包好的开箱即用套件 |
按产品数,就是 3 类。这没错。但注意两点:一是这个「三类」是对整个生态的分类——每一类里都还有第三方选项(Runtime 还有 Temporal / Inngest,Framework 还有 CrewAI / OpenAI Agents SDK,Harness 还有 Claude Agent SDK 等),只是本系列只讲 LangChain 自家的三个;二是官方产品名现在是 Deep Agents SDK(另有独立的 Deep Agents CLI),本文为行文简洁,下文一律简称 Deep Agents。
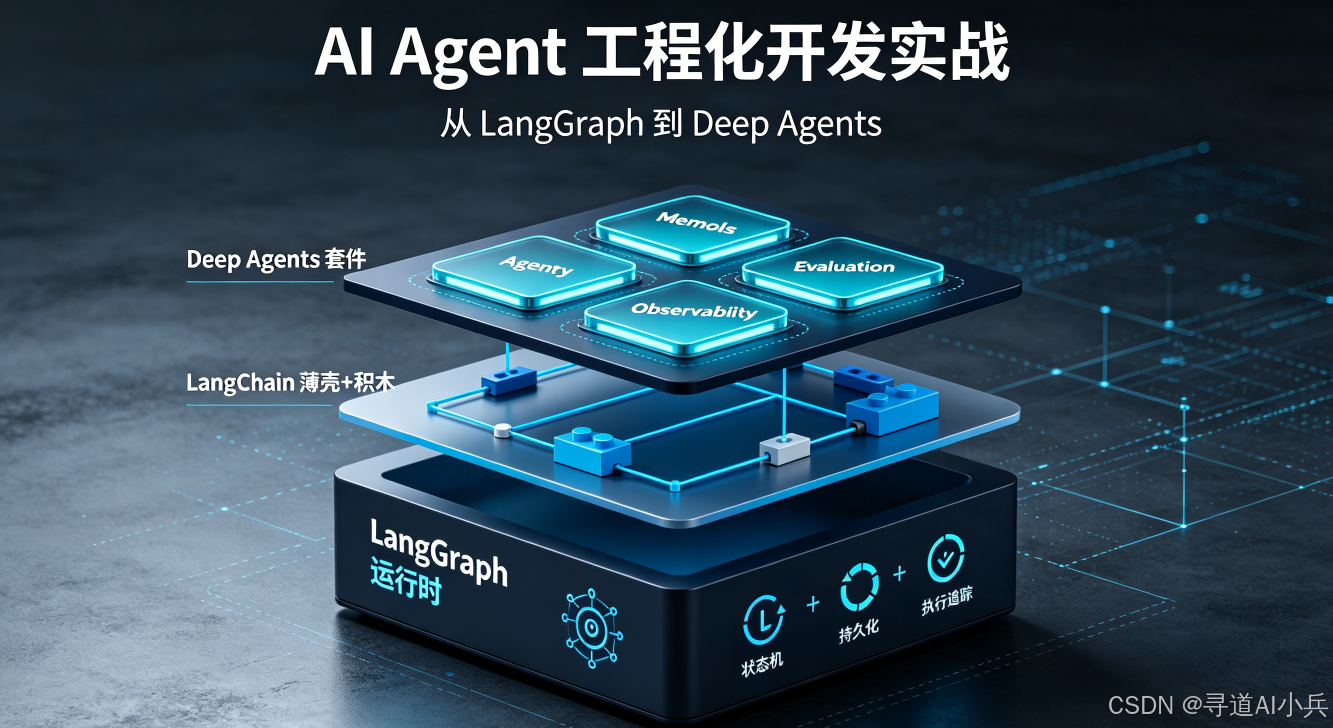
但落到依赖关系上,事情变了——因为 LangChain 不是一个整块。它被 LangGraph 从中间「劈」成了两半:
1langchain-core(积木:messages / tools / models / bind_tools)   ← LangChain 的一半,在 LangGraph 之下
2        ↑ 依赖
3LangGraph(运行时:图、状态、Checkpoint、流式、HITL)
4        ↑ 依赖
5create_agent + middleware(LangChain 薄壳)                      ← LangChain 的另一半,在 LangGraph 之上
6        ↑ 依赖
7deepagents / create_deep_agent(Deep Agents 套件)
8
所以是「3 类产品、4 层依赖」。 多出来的那一层,正是把 LangChain 劈开的结果:
langchain-core(我们叫它「积木」)在 LangGraph 之下——它是 LangGraph 的地基,LangGraph 依赖它;create_agent+ 中间件(我们叫它「薄壳」)在 LangGraph 之上——它包在 LangGraph 外面,是 LangGraph 的一层封装。
这条是我全系列反复强调的铁律:不要把 LangChain 画成一整块叠在 LangGraph 之上。很多人(包括早期教程,也包括我当年自己画的图)都在这栽过跟头,后果是讲 create_agent 的时候逻辑对不上——它明明「包着」LangGraph,怎么会和「垫着」LangGraph 的 langchain-core 是同一个东西?
三、四个层次逐层拆
从下往上看,一层一层说清楚它「是什么、管什么」。
第 1 层:积木(langchain-core)
最底层,也是最「无聊」、最该先吃透的一层。它提供的是最小原子:
messages:消息对象(Human / AI / Tool / System);tools:工具的声明与描述;models:大模型的统一调用接口;bind_tools:把工具「绑」到模型上,让模型知道它能调用什么;- 以及后面讲检索与 RAG 的篇章要展开的检索组件(Document / Embedding / Retriever 等)。
这一层不关心「Agent 怎么循环、怎么记忆、怎么中断」,它只关心「一个消息长什么样、一个工具怎么声明、一次模型调用怎么发」。你后面写的每一行 from langchain_core ... import,用的都是这层。
为什么它是最底层? 因为 LangGraph 自己就是建立在它之上的——Agent 场景下 StateGraph 里流动的状态,通常是 MessagesState(一组 messages);不过状态本身可以是任意 TypedDict 结构。节点里调用的,就是 models 和 tools。
第 2 层:运行时(LangGraph)
LangGraph 是执行引擎,回答的问题是「Agent 每一步该怎么走」。它提供了:
- 图 / 节点 / 边:把 Agent 拆成一个个节点(调用模型、调用工具),用边串成执行流;
- 状态(State):Agent 每一步的输入输出、累积的对话历史,都存在一个显式的状态对象里;
- Checkpoint(检查点):每一步的中间状态可持久化,支持断点恢复,官方称时间旅行(time travel)(讲 Checkpoint 与断点恢复的篇章会专门展开);
- 流式(stream):把执行过程以 token / 节点为单位推出来;
- Human-in-the-loop(HITL,人在环):在任意节点暂停,等人类确认再继续(讲 HITL 的篇章会给出底层
interrupt())。
一句话:积木是「零件」,运行时是「流水线」。LangGraph 决定零件按什么顺序、在什么状态驱动下流转。
第 3 层:薄壳(create_agent + middleware)
这是 LangChain 在 LangGraph 之上的那半。LangGraph 已经能跑 Agent,但手写 StateGraph 太啰嗦——一个「调模型 → 调工具 → 再调模型」的最简 Agent,你要自己写节点、写条件边、写循环终止。
于是 LangChain 提供了一个 create_agent 工厂:一行代码生成一个标准的「模型 + 工具」循环图,还附带一套中间件(middleware)栈,让你在「模型调用前 / 调用后」「工具调用时」等时机插入自定义逻辑(讲中间件的篇章会专门展开)。
所以「薄壳」的「薄」是刻意的:它不改变 LangGraph 的执行语义,只是在外面包了一层更省事的 API。你要控制得更细,随时可以「下沉」回 LangGraph。
第 4 层:套件(Deep Agents)
最顶层,最省力。create_deep_agent(来自 deepagents 包)在 create_agent 的基础上,再打包一层:把「写计划、读写文件、执行代码、管理长期记忆、人在环」这些生产级 Agent 几乎都要用的东西,作为一套内置中间件栈(各自注入内置工具)预先装好。
它和薄壳的关系,就像薄壳和运行时:套件是薄壳的薄壳,薄壳是运行时的薄壳。你从第 4 层起步,需要什么控制力,就逐层往下沉。
四、一张调用链图看清全貌
认知篇不贴代码(后面每篇都有能跑的代码),用一张调用链图把四层的关系钉死。假设你最终写下这样一行:
1from deepagents import create_deep_agent
2agent = create_deep_agent(...)
3
这行代码背后,是自上而下的一串依赖调用:
1你的代码
2   │  调用
3   ▼
4create_deep_agent(...)                    ← 第 4 层 套件
5   │  内部调用
6   ▼
7create_agent(...)  +  middleware 栈       ← 第 3 层 薄壳
8   │  内部调用
9   ▼
10StateGraph(nodes / edges / state)       ← 第 2 层 运行时
11   │  依赖
12   ▼
13langchain-core(messages / tools / models / bind_tools)  ← 第 1 层 积木
14
记这张图时抓两点:
- 方向是自上而下的依赖:上层调用下层,下层不反过来依赖上层。
create_deep_agent不认识你的业务,它只调用create_agent;create_agent不认识「写计划」,它只构建StateGraph;StateGraph不关心「Agent」,它只流转messages。 - LangChain 横跨两层:
create_agent(薄壳)在 LangGraph 之上,langchain-core(积木)在 LangGraph 之下。这就是「3 类产品 / 4 层」的由来——Framework这一个产品,拆出了两个依赖位置。
五、一次选型定位:该落到哪一层
认知篇的「实战」不是写代码,而是练一种选型直觉:拿到一个需求或一个报错,能立刻判断「它该由哪一层来负责」。这是我这些年排查问题和做架构评审时最高频的动作,给你几道我真实遇到过的情况,试着先自己想,再看定位。
场景 A:「我要一个能调工具、带记忆、能写文件的 Agent,最好明天就能演示。」
→ 落第 4 层(套件)。create_deep_agent 一行搞定,规划、文件、记忆都是内置的。别手写 StateGraph——那是把「明天要演示」的活干成「下周」。
场景 B:「我要在每次调用模型之前,注入一段动态的系统提示(比如按用户等级加载不同人设)。」
→ 落第 3 层(薄壳)。这是 create_agent 的中间件 before_model 干的活。用第 4 层做不了这么细的「卡点」,用第 2 层又太重。
场景 C:「我要一个多智能体编排:一个 supervisor 派单给几个子 Agent,各自有独立的检查点和中断点,还要能回放任一步。」
→ 落第 2 层(运行时)。多图、独立 checkpoint、断点恢复/回放,这是 StateGraph + 子图的地盘。第 3、4 层是「单 Agent 循环」的封装,硬套多智能体会拧巴。
场景 D:报错 AttributeError: 'BaseChatModel' object has no attribute 'bind_tools',发生在你往 LangGraph 节点里传模型的时候。
→ 这是第 1 层(积木)的问题——bind_tools 是挂在模型对象上的方法(第 1 层的模型接口),报这个错几乎总是因为你传进去的不是 ChatModel 对象(比如拿成了裸 provider 模型、旧的 BaseLLM,或对象被错误包装)。顺着「它属于第 1 层」去查你传进去的模型对象,而不是在 LangGraph 的图逻辑里瞎找。
我的选型口诀:能用高层就绝不手写底层;但一旦你要「精确控制」某一步,就一路下沉到管那一步的那层,别在高层的缝里硬抠。 这也正是官方推荐的方向——默认从 Deep Agents 开始,需要控制再下沉(讲选型决策的篇章会把它展开成一套决策树)。
六、工程化要点:双向认知
最后把这个「双向认知」立住,它能解释整个系列的编排逻辑:
- 自底向上 = 依赖顺序(学习 / 理解时的顺序):
langchain-core→ LangGraph →create_agent→ Deep Agents。你要搞懂「为什么create_agent能包住 LangGraph」,就得先知道 LangGraph 依赖什么、LangGraph 又能提供什么。所以本系列从 LangGraph 讲起,而不是从「最省力的 Deep Agents」讲起——那不是最省力,是「会用但不懂」。 - 自顶向下 = 使用顺序(真实开发时的顺序):Deep Agents →
create_agent→ LangGraph →langchain-core。上手永远是最高层,逐层下沉直到拿到你要的控制力。
两者不矛盾,就像「装配一台发动机,要从零件理解起;但开车出门,是从点火起步」。本系列 Part 1 快速起步、Part 2 系统讲运行时、Part 3 讲薄壳与积木、Part 4 讲套件、Part 5 组装成主案例,正是这条双向认知的落地。
记住本文最该带走的一句话:官方是 3 类产品(Runtime / Framework / Harness),依赖上是 4 层——因为 LangChain 被劈成了「积木(下)+ 薄壳(上)」两块。 这句话,会是后面各篇反复回来校准的坐标原点。
参考文献
[1] LangChain 官方文档 · Concepts:Products(Runtimes, frameworks, harnesses)— https://docs.langchain.com/oss/python/concepts/products
[2] LangChain 官方博客:《Deep Agents vs LangChain vs LangGraph》— https://www.langchain.com/blog/deep-agents-vs-langchain-vs-langgraph
[3] LangGraph 官方文档 · Overview — https://docs.langchain.com/oss/python/langgraph/overview
🎯 更多专栏系列文章可以查看博客主页📑 👍 若文章对你有所触动,恳请点赞 ⭐ 关注 ⭐ 收藏
参考文档
《AI Agent 工程化开发实战(一):Agent 开发的四个层次——积木、运行时、薄壳、套件》 是转载文章,点击查看原文。

