༺ 个人主页 · 纪念229 ༻
༒专栏目录:《算法》༒
༒专栏目录:《MySQL数据库》༒
༒专栏目录:《前端开发》༒
༺世上本没有路,走的人多了自然就有了༻
本节讲的是有关二叉树的OJ题,希望对你有所帮助
题目链接
二叉树前序遍历
二叉树中序遍历
二叉树的后序遍历
单值二叉树
对称二叉树
文章目录
- 1.二叉树前序遍历
- 2.单值二叉树
- 3.对称二叉树
文章开始前我与大家讨论一个问题
算法题是不是做多了,然后每个题当场弄懂了,后面忘了,然后又弄懂,慢慢的算法能力就上来了?
大部分人学算法都是这个循环:听懂 → 过段时间忘光 → 重新看懂 → 慢慢内化,能力一点点涨
1.二叉树前序遍历
我们看到这题也许会觉得简单,确实它的思想就是二叉树前序排列
接下来我们来讨论一下这道题
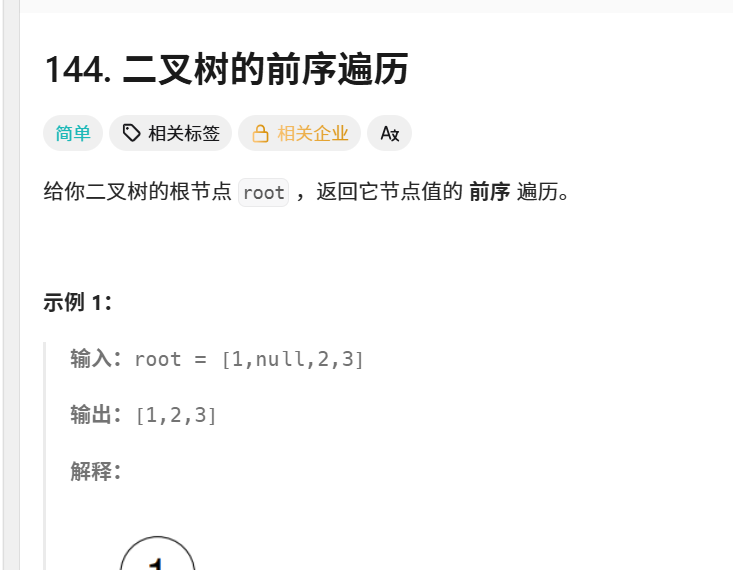

我们可以看到它就给了这个
题目的意思是返回一个指针通过指针访问数组的元素
显然我们会创建一个指针作为数组的首地址
看到形参returnSize我们会先到啥
会不会是直接给出二叉树节点的个数(并不是)
首先我们看到int* 类型的所以判题的工具会根据这个形参的值来判断这题对不对
实际上是输出参数(指针)
这道题它的功能是
作为一个数组下标来访问目标数组让排序的好的数字一一放入数组中(恰巧)
这里讲个事,LeetCode题目里的形参都有它具体的意思
题做多了就认得了
代码展示
1/**
2 * Definition for a binary tree node.
3 * struct TreeNode {
4 *     int val;
5 *     struct TreeNode *left;
6 *     struct TreeNode *right;
7 * };
8 */
9/**
10 * Note: The returned array must be malloced, assume caller calls free().
11 */
12void dfs(struct TreeNode* node, int* result, int* returnSize){
13    if(node == NULL){
14        return;
15    }
16    result[(*returnSize)++] = node->val;
17    dfs(node->left, result, returnSize);
18    dfs(node->right, result, returnSize);
19}
20
21int* preorderTraversal(struct TreeNode* root, int* returnSize) {
22    int* result =(int*)malloc(sizeof(int) * 100);
23    *returnSize = 0;
24    dfs(root, result, returnSize);
25    return result;
26}
27
具体讲解:
有些刚做数据结构算法题的人认不得求:[x、d、1、t]啥的
它其实就是让你返回一个指针(指针里就有这个数组)
因为是数组要用到指针所以我们要用到malloc(没malloc该指针只能储存一个数据int*类型)
又因为我们要利用returnSize作为下标将二叉树的节点一一插入所以就解引用赋值为0
我们来看看dfs的形参是一个二叉树一个数组和一个下标就是根据前序排列将数据插图数组中
二叉树的题型一般都会考虑到当首节点为NULL时直接return不带任何东西
1    result[(*returnSize)++] = node->val;
2    dfs(node->left, result, returnSize);
3    dfs(node->right, result, returnSize);
4
这就是前序排序的方法ELR
我们看到如果头节点不为NULL的话
先二叉树的第一个节点数据放入数组中
dfs(node->left, result, returnSize);
然后利用递归用node->left将节点前移然后面临的又是dfs的重复操作
我们知道代码是从下往下读的所以
代码会先执行它dfs(node->left, result, returnSize);
再执行它dfs(node->right, result, returnSize);
就实现了将前序排序一个个放入数组中
这里讲一个优先级的事
(*returnSize)++若是没()就是给指针加加
*returnSize++先加加在解引用(若目的是将指针内的数据加加就要用括号将变量与解引用括起来)
++*returnSize
然后就是中序排序、后序排序代码差不多就是改一下顺序
中序排序LRE
1    dfs(node->left, result, returnSize);
2    result[(*returnSize)++] = node->val;
3    dfs(node->right, result, returnSize);
4
后序排序LRE
1    dfs(node->left, result, returnSize);
2    dfs(node->right, result, returnSize);
3    result[(*returnSize)++] = node->val;
4
解释一下为啥sizeof(int) * 100题目要求二叉树节点不超过100个怕给100个节点的二叉树所以乘了100
2.单值二叉树

代码展示
1/**
2 * Definition for a binary tree node.
3 * struct TreeNode {
4 *     int val;
5 *     struct TreeNode *left;
6 *     struct TreeNode *right;
7 * };
8 */
9bool isUnivalTree(struct TreeNode* root) {
10    if(root == NULL){
11        return true;
12    }
13    //判断二叉树头节点是否为NULL,为NULL说明为单值节点后续遍历完又可以说明符合单值规则
14    if(root->left && root->left->val != root->val){
15        return false;
16    }
17    if(root->right && root->right->val != root->val){
18        return false;
19    }
20    return isUnivalTree(root->left) && isUnivalTree(root->right);
21//一个一个遍历判断到最后节点为NULL返回ture因为有&&只要有一false就是false(非单值二叉树)
22
23}
24
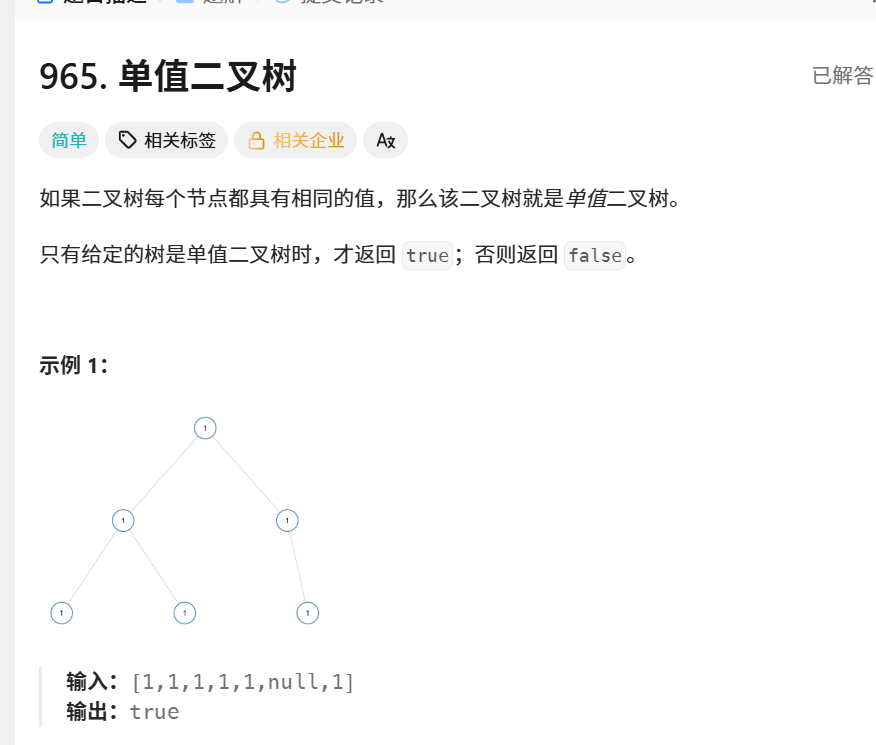
就给了一个形参
要判断是单值二叉树就是看目标节点的左右节点是否等于头节点的数据
首先我们要知道头节点为NULL即为单值二叉树
然后判断目标节点的左右节点是否等于头节点的数据
最后用递归遍历左右两树杈是否符合单值二叉树的规则
此后的节点为NULL说明该树杈符合单值二叉树的规则
最后讲一下&&的作用(只有左右两边为真才为真其塔都返回假(若是第一个判为假第二个就不用判了直接为假))
我们利用递归函数和&&最终返回了bool值所以只要将有一个不符合规则就会报错
最后讲一下递归(要看递归其实就是从最后一步开始看虽然函数是一步一步问下走的没有返回值递归函数就不会消失(所以看递归思想看的就是最后一步return的然后就是上一个函数的返回值))
补充一下||
两个为真才为真
两个为假才为假
一假一真为真
3.对称二叉树
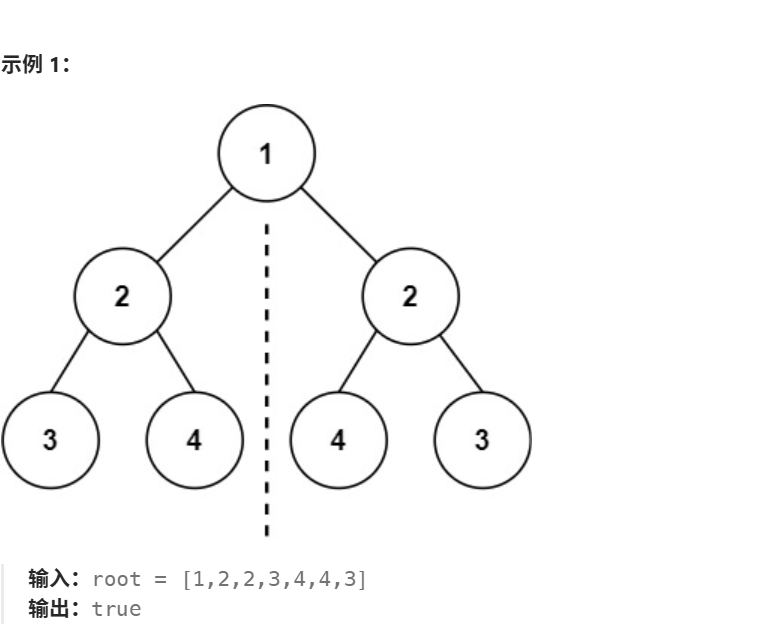
开始只有这个
代码展示
1/**
2 * Definition for a binary tree node.
3 * struct TreeNode {
4 *     int val;
5 *     struct TreeNode *left;
6 *     struct TreeNode *right;
7 * };
8 */
9 //判断两棵树是否为镜像
10 bool check(struct TreeNode* left, struct TreeNode* right){
11     if(left == NULL && right == NULL){
12        return true;
13    }
14    if(left == NULL || right == NULL){
15     return false;
16    }
17    if(left->val != right->val){
18        return false;
19    }
20  //左子树的左与右子树的右比较
21  //左子树的右与右子树的左比较
22  return check(left->left, right->right) && check(left->right, right->left);
23 }
24bool isSymmetric(struct TreeNode* root) {
25  if(root == NULL){
26    true;
27  }
28return  check(root->left,root->right) ;
29}
30
具体讲解:
头节点为NULL即为对称二叉树返回true
之后用一个check函数形参为左右节点指针
(left == NULL && right == NULL)
我就讲这一个其他的研究一也会懂的
有两种意思当只有一个节点时为对称二叉树返回true
当全对比完后说明符合规则返回ture
return check(left->left, right->right) && check(left->right, right->left);
还有一个这个就是
//左子树的左与右子树的右比较
//左子树的右与右子树的左比较
这样递归就可以符合对称二叉树的规则
文章到这就告一段落,希望对你有所帮助,感谢观看!



