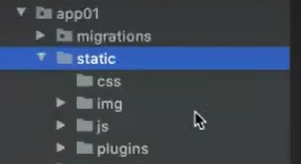
- 静态文件要放在app/static目录中。Django会自动在这个文件中寻找对应模板
- 模板语法
本质上是django专属在HTML中的一些占位符。
list 取值
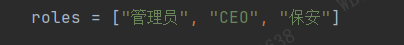
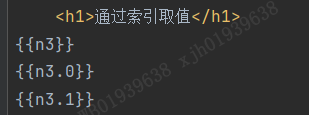
索引取值:
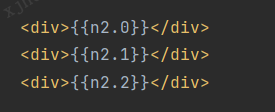
通过 “.”+索引
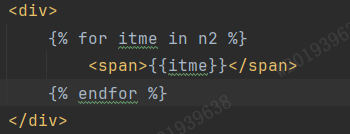
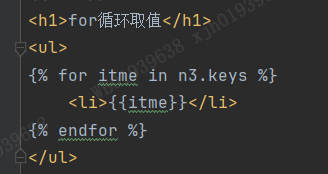
For循环取值
Dict字典取值
通过索引取值
获取所有key值。N3.keys
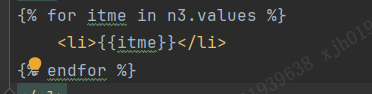
获取所有value值. N3.values
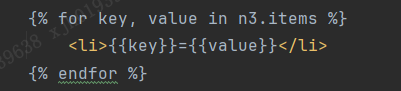
获取key和value值. N3.items
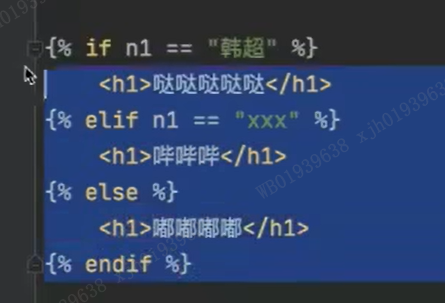
判断语句
《2.django - 项目结构和模板语法》 是转载文章,点击查看原文。
本质上是django专属在HTML中的一些占位符。
list 取值
索引取值:
通过 “.”+索引
For循环取值
Dict字典取值
通过索引取值
获取所有key值。N3.keys
获取所有value值. N3.values
获取key和value值. N3.items
判断语句
《2.django - 项目结构和模板语法》 是转载文章,点击查看原文。
相关推荐
目录 前言 一、确认应答机制 二、超时重传机制 2.1 理解丢包的本质 2.2 超时时间如何确定 三、滑动窗口机制 3.1 深度理解 send/write 和发送缓冲区 3.2 理解滑动窗口 3.3 理解结合滑动窗口发送报文的流程 3.4 滑动窗口机制的进一步理解——发送缓冲区的空间复用 3.5 滑动窗口机制的进一步优化——快速重传机制 3.6 滑动窗口的大小如何确定 四、流量控制机制 4.1 零窗口探测 4.2 16 位窗口大小的限制与窗口扩大因子 五、拥塞
准备工作 技术栈: vue + gsap 最近在做的一个动画,特意去网上查了一下叫 pinned 滚动叙事,感觉蛮有趣,分享给你们。 实现的动画如下: 对应的模仿网址是:www.vaporesso.com/series-prod… 思考过程🤔 多滚动几次上面的动画,感官上大致可以得出一个粗浅的感受。 页面滚到某一段时,画面突然停住了。你继续滚动,页面没有向下走,而是像一条时间线一样开始播放:卡片移动到中心、放大、图片和文字拉开距离,然后卡片退场,背后的内容一层一层覆盖进来。等这一段讲完,卡片
这是《Agent全栈实战》的第 6 篇。整个系列以 catbuddy(一个本地优先的 AI 编程助手,约 3.6 万行 TypeScript)为案例,由浅入深拆解 harness 设计。前面我们讲了心脏(Agent Loop)和手脚(工具系统)。这一篇聊「眼睛」——模型每次开口之前,它到底看到了什么。你给 LLM 的那一长串 messages,不是随手拼的,而是一条五层流水线装出来的;而对话一长,这串东西就会撑爆上下文窗口,撞上窗口红线直接 context_length_exceeded。所以这
简介 Jetty 是 Eclipse 基金会维护的 Java Web 服务器,也是一个 Servlet 容器。 它主要能做这些事: 监听 HTTP 端口 处理 HTTP 请求和响应 运行 Servlet / Filter / Listener 部署 WAR 包 支持 WebSocket、HTTP/2、HTTP/3 作为库嵌入到 Java 程序里启动 作为 Spring Boot 的内嵌容器 一句话概括: Jetty 既能像 Tomcat 一样单独部署 Web 应用,也能像普通 Java 库一样

在前面的几篇文章里,我们已经体验了 OpenMontage 的零成本玩法:用 Piper 配音、用免费素材剪纪录片、用 Remotion 把图片做成动画,全程不花一分钱 API 费用。我们也试过贴一个参考视频,让 agent 帮我们拆解出差异化的制作方案。 不过零成本路径终究有上限。想要 FLUX 的图、Veo 或 Kling 的真实运动镜头、ElevenLabs 的高质量配音,就得接入对应的 provider。OpenMontage 支持的 provider 有几十个,同一个能力往往有好几个、
leetcode.cn/problems/fi… programmercarl.com/0028.%E5%AE… 给你两个字符串 haystack 和 needle ,请你在 haystack 字符串中找出 needle 字符串的第一个匹配项的下标(下标从 0 开始)。如果 needle 不是 haystack 的一部分,则返回 -1 ****。 示例 1: 输入: haystack = "sadbutsad", needle = "sad" 输出: 0 解释: "sad" 在下标 0 和

前面几篇多次提到 w: "majority",这篇把它彻底讲清楚。读写关注(read/write concern)是 MongoDB 控制持久性和一致性的核心参数——它们决定了「一个写入要被几个节点确认才算成功」「一个读取从哪个节点读、读到什么程度的一致」。理解了它们,才能在不同业务场景下精准调出「够用且不浪费」的持久性/一致性档位。 先把机制边界说清楚 读写关注是三个相关但独立的参数: writeConcern(写关注):写操作要被几个节点确认才算成功。控制持久性。 readPreferen
刚从 MySQL 迁到 MongoDB 的人,最容易把关系建模那一套照搬过来:每个实体建一个集合,用 userId、orderId 这种字段做关联,查询时再 $lookup 拼。这种写法能跑,但它把 MongoDB 用成了「没有外键约束的关系库」,丢掉了文档模型最大的优势——访问局部性。 文档模型真正的价值,不是「字段随便加」,而是把一个业务实体的相关信息内嵌成一个文档,应用读一次就能拿到全部信息。但内嵌也不是免费午餐:它换来访问效率的同时,要承担冗余、一致性维护和文档膨胀的成本。这一篇讲清楚内
2026 年 6 月 8 日,WWDC26 上苹果发布了空间重构(Spatial Reframing):照片拍完之后,拖动画面重新选择机位,AI 实时补全新视角缺失的内容: 头部玩家在两年内相继入场,这背后是三项能力趋于成熟: 单目深度估计沉淀为基础模型:无需双摄或激光雷达,仅凭一张普通照片推断每个像素的远近;过去这类模型更像“专用工具”,换个场景就容易失准;2024 年前后,香港大学与字节跳动的 Depth Anything V2 的 25M 参数的 Small
本文面向已有前端开发基础、正在学习 Python 的开发者。 迭代器和生成器解决的是同一个问题:数据不一定要一次性全部准备好,可以在需要的时候一个一个取出来。前端里最接近的经验是 for...of、Symbol.iterator、生成器函数 function* 和 yield。 这几个概念可以先合在一起记: 可迭代对象表示“可以被遍历的数据源” 迭代器表示“真正负责一步一步取值的对象” 生成器表示“用 yield 快速创建出来的迭代器” 后面的 for 循环,本质上就是先从可迭代对象拿到迭代器
