ReAct 模式 —— 推理与行动交织的循环智能体
- 1、引言
- 2、ReAct 到底怎么工作?
- 3、ReAct 核心原理
-
- 3.1 关键数据结构
- 3.2 与 Chain-of-Thought 的区别
- 4、生产级实现(LangGraph + MCP)
- 5、2026 年的关键改进点
-
- 5.1 从 "字符串解析" 到 "结构化输出"
- 5.2 步数预算与防循环
- 5.3 KV-Cache 复用优化
- 6、适用场景与性能基准
- 7、总结
1、引言
小屌丝:鱼哥,我最近写了个 Agent,让它查天气,结果你猜怎么着?它直接给我编了个假天气!北京今天明明 35 度大晴天,它告诉我"北京今天小雨 18 度,记得带伞"。我当场就裂开了……
小鱼:(扶额)兄弟,你这是让模型"闭卷考试"啊。LLM 的知识是 cutoff 的,它又不会真的去查天气预报,可不就瞎编嘛。
小屌丝:那我该咋办?总不能我手动帮它查吧?
小鱼:你得让它学会 “边想边干”。就像你打游戏,不是一上来就冲boss,而是先观察一下——“这怪会喷火,我得绕后"→ 绕后 → 发现它屁股也会喷火 → 再调整策略。Agent 也得这样:先推理,再行动,看结果,再推理。
小屌丝:哦?这就是传说中的 ReAct?
小鱼:对,ReAct(Reasoning + Acting)。2026 年了,这依然是 Agent 的默认基本功。今天我就给你掰扯掰扯,怎么让你的 Agent 从"瞎编大师"变成"靠谱打工人”。
2、ReAct 到底怎么工作?
ReAct(Reason + Act)是所有单智能体的基础核心范式,源自经典LLM智能体交互框架,是OpenAI、Google、字节2026年轻量化Agent的默认首选模式。核心思想:推理思考、工具行动、结果观察、迭代决策,循环往复,无预设固定流程。
和P&E的“一次性规划、批量执行”不同,ReAct不依赖前置全局计划,完全根据实时工具返回结果动态调整下一步行为,完美适配未知场景。
ReAct 完整闭环工作流程
- 阶段一:推理(Reason):大模型基于当前上下文、历史结果,实时分析下一步需要执行的动作,生成工具调用指令,不依赖预设步骤。
- 阶段二:行动(Act):调用外部工具(搜索、接口、数据库、脚本),执行具体操作,获取实时环境数据。
- 阶段三:观察(Observation):接收工具返回结果,更新全局上下文状态。
循环判定:判断任务是否完成,未完成则回到推理阶段,继续迭代;完成则输出最终结果。
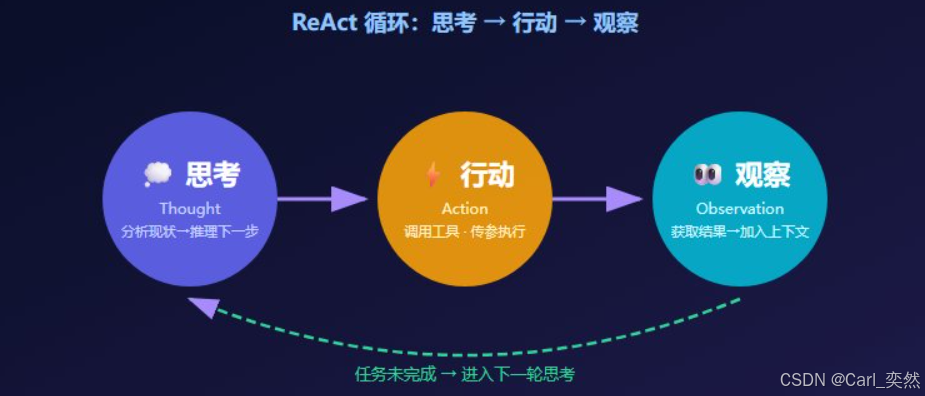
一句话总结:ReAct = 实时推理 + 动态行动 + 迭代闭环,主打一个随机应变、适配未知。
3、ReAct 核心原理
ReAct 的精髓在于 “停下来想一想”。与直接生成答案的 Zero-Shot Prompting 不同,ReAct 强制 LLM 输出结构化的推理轨迹:
1┌─────────────────────────────────────────┐
2│  User Query: "北京今天天气怎么样?"        │
3└─────────────────────────────────────────┘
4                    ↓
5┌─────────────────────────────────────────┐
6│  Thought: 用户询问北京天气,我需要查询     │
7│          实时天气数据。我没有内置天气知识, │
8│          应该调用 weather_api 工具。       │
9└─────────────────────────────────────────┘
10                    ↓
11┌─────────────────────────────────────────┐
12│  Action: 调用 weather_api(city="北京")   │
13└─────────────────────────────────────────┘
14                    ↓
15┌─────────────────────────────────────────┐
16│  Observation: {"temp": 28, "condition":  │
17│               "多云", "aqi": 45}         │
18└─────────────────────────────────────────┘
19                    ↓
20┌─────────────────────────────────────────┐
21│  Thought: 已获得数据,可以组织语言回复。   │
22│          温度28度,多云,空气质量优。      │
23└─────────────────────────────────────────┘
24                    ↓
25┌─────────────────────────────────────────┐
26│  Final Answer: 北京今天天气多云,气温28℃, │
27│               空气质量指数45,属于优等级。 │
28└─────────────────────────────────────────┘
29
3.1 关键数据结构
在 2026 年的生产实现中,ReAct 的每一步通常被结构化为以下 JSON Schema(兼容 OpenAI 的 Function Calling 和 Anthropic 的 Tool Use):
1{
2  "thought": "string, 内部推理过程,对用户不可见",
3  "action": {
4    "tool_name": "string, 要调用的工具名",
5    "parameters": "object, 工具参数"
6  },
7  "observation": "string, 工具返回的原始结果",
8  "is_final": "boolean, 是否已得到最终答案"
9}
10
3.2 与 Chain-of-Thought 的区别
| 维度 | Chain-of-Thought | ReAct |
|---|---|---|
| 与外部世界交互 | ❌ 纯文本推理 | ✅ 主动调用工具 |
| 反馈闭环 | ❌ 单向生成 | ✅ Observation 反馈到下一步 |
| 错误恢复 | ❌ 无法修正 | ✅ 根据工具结果调整策略 |
| 适用场景 | 数学推理、逻辑题 | 需要实时数据、API 调用的任务 |
4、生产级实现(LangGraph + MCP)
基于 LangGraph 1.x 和 MCP 协议 的现代化 ReAct 实现。相比 2024 年的早期版本,2026 年的最佳实践强调:
- 结构化追踪(Structured Tracing):每一步必须记录到可观测性系统
- 步数预算(Step Budget):硬限制最大循环次数,防止无限循环
- KV-Cache 复用:在多轮循环中复用缓存,降低 30% 的 Token 成本
1# 2026 年生产级 ReAct Agent(LangGraph + MCP)
2from typing import TypedDict, Annotated, Sequence
3import operator
4from langgraph.graph import StateGraph, END
5from langgraph.prebuilt import ToolNode
6from mcp import ClientSession, StdioServerParameters  # MCP 2026 标准客户端
7from langchain_openai import ChatOpenAI
8import json
9
10# ========== 1. 状态定义 ==========
11class ReActState(TypedDict):
12    messages: Annotated[Sequence[dict], operator.add]  # 对话历史
13    steps: Annotated[int, operator.add]                # 已执行步数
14    max_steps: int                                     # 最大步数限制(Step Budget)
15    trace_id: str                                      # 分布式追踪 ID
16
17# ========== 2. 工具层(通过 MCP 协议接入) ==========
18async def setup_mcp_tools():
19    """通过 MCP 协议接入外部工具,2026 年标准做法"""
20    server_params = StdioServerParameters(
21        command="python",
22        args=["-m", "mcp_server_weather"],  # MCP 天气服务
23        env=None
24    )
25    async with ClientSession(server_params) as session:
26        tools = await session.list_tools()
27        return {tool.name: tool for tool in tools}
28
29# ========== 3. 推理节点 ==========
30async def react_reason(state: ReActState, llm: ChatOpenAI, tools: dict):
31    """ReAct 核心:Thought + Action 生成"""
32    if state["steps"] >= state["max_steps"]:
33        return {
34            "messages": [{"role": "assistant", "content": "抱歉,思考步数已达上限,无法完成查询。"}],
35            "steps": 0
36        }
37
38    # 构造 ReAct 格式的系统提示
39    system_prompt = f"""你是一个 ReAct 智能体。你必须按以下格式思考:
40
41Thought: 你的推理过程(内部思考,不展示给用户)
42Action: {{"tool_name": "工具名", "parameters": {{参数}}}}
43Observation: 工具返回的结果(由系统自动填充)
44
45当前可用工具:{list(tools.keys())}
46已执行步数:{state["steps"]}/{state["max_steps"]}
47
48规则:
491. 如果需要调用工具,只输出 Thought 和 Action
502. 如果已得到答案,输出 Thought 和 Final Answer
513. 严禁编造 Observation
52"""
53
54    messages = [{"role": "system", "content": system_prompt}] + list(state["messages"])
55    response = await llm.ainvoke(messages)
56    content = response.content
57
58    # 解析 Thought / Action / Final Answer
59    if "Final Answer:" in content:
60        # 结束循环
61        final_answer = content.split("Final Answer:")[1].strip()
62        return {
63            "messages": [{"role": "assistant", "content": final_answer}],
64            "steps": 0  # 重置步数
65        }
66
67    # 提取 Action 并执行
68    import re
69    action_match = re.search(r'Action:\s*(\{.*?\})', content, re.DOTALL)
70    if action_match:
71        action_json = json.loads(action_match.group(1))
72        tool_name = action_json["tool_name"]
73        parameters = action_json["parameters"]
74
75        # 执行工具调用(MCP 标准接口)
76        tool_result = await tools[tool_name].invoke(parameters)
77
78        # 构造 Observation 并追加到消息历史
79        observation = f"Observation: {json.dumps(tool_result, ensure_ascii=False)}"
80        return {
81            "messages": [
82                {"role": "assistant", "content": content},  # Thought + Action
83                {"role": "user", "content": observation}     # Observation 作为用户消息
84            ],
85            "steps": 1
86        }
87
88    # 兜底:直接返回
89    return {"messages": [{"role": "assistant", "content": content}], "steps": 1}
90
91# ========== 4. 构建 LangGraph ==========
92def build_react_agent(tools, llm):
93    workflow = StateGraph(ReActState)
94
95    # 添加节点
96    workflow.add_node("reason", lambda state: react_reason(state, llm, tools))
97    workflow.add_node("tool_executor", ToolNode(tools))  # LangGraph 预置工具节点
98
99    # 设置边
100    workflow.set_entry_point("reason")
101    workflow.add_conditional_edges(
102        "reason",
103        lambda state: "tool_executor" if state["steps"] > 0 else END,
104        {"tool_executor": "tool_executor", END: END}
105    )
106    workflow.add_edge("tool_executor", "reason")  # 工具执行后回到推理
107
108    return workflow.compile()
109
110# ========== 5. 运行 ==========
111async def main():
112    tools = await setup_mcp_tools()
113    llm = ChatOpenAI(model="gpt-5", temperature=0)  # 2026 年主流模型
114    app = build_react_agent(tools, llm)
115
116    result = await app.ainvoke({
117        "messages": [{"role": "user", "content": "查询北京今天天气,并告诉我适合穿什么衣服"}],
118        "steps": 0,
119        "max_steps": 10,  # Step Budget:硬限制 10 步
120        "trace_id": "trace-2026-001"
121    })
122    print(result["messages"][-1]["content"])
123
124if __name__ == "__main__":
125    import asyncio
126    asyncio.run(main())
127
5、2026 年的关键改进点
5.1 从 “字符串解析” 到 “结构化输出”
2024 年的 ReAct 实现依赖正则表达式解析 Thought: … Action: … 的字符串格式,极易出错。2026 年的最佳实践是:
- OpenAI:使用 response_format={“type”: “json_schema”} 强制输出 JSON
- Anthropic:使用 Tool Use 的原生 XML 格式
- 通用方案:通过 Instructor 或 LangChain 的 Structured Output 进行 Pydantic 校验
5.2 步数预算与防循环
生产环境中最常见的故障是 “思考循环” —— Agent 在相同工具间反复调用。
2026 年的标准防御:
1# 循环检测:滑动窗口去重
2def detect_loop(actions: list, window: int = 3) -> bool:
3    """检测最近 N 步是否重复相同动作"""
4    if len(actions) < window * 2:
5        return False
6    recent = actions[-window:]
7    previous = actions[-window*2:-window]
8    return recent == previous
9
10# 指数退避重试
11def retry_with_backoff(attempt: int, max_delay: float = 30.0) -> float:
12    return min(2 ** attempt, max_delay)
13
5.3 KV-Cache 复用优化
在多步 ReAct 循环中,系统提示和工具描述是固定的。2026 年的推理框架(如 vLLM、TensorRT-LLM)支持 Prefix Cache,将系统提示的 KV-Cache 在循环间复用,可将延迟降低 40-60%。
6、适用场景与性能基准
| 场景 | 推荐度 | 原因 |
|---|---|---|
| 实时问答(天气、股价、新闻) | ⭐⭐⭐⭐⭐ | 需要动态获取外部数据 |
| 多跳推理(复杂查询) | ⭐⭐⭐⭐ | HotpotQA 上 ReAct 达到 47.8% vs CoT 的 29.4% |
| 代码生成 | ⭐⭐⭐ | 更适合结合 Reflection 模式 |
| 长周期任务(>20 步) | ⭐⭐ | 容易迷失,应使用 Plan-and-Execute |
2026 年性能基准:
- 平均延迟:5-10 秒(3 步循环)
- Token 开销:+200-300%(相比直接回答)
- 单次查询成本:$0.06-0.09
- 任务完成率:85%(简单任务)/ 62%(复杂多步任务)
7、总结
ReAct 是 Agent 世界的 “瑞士军刀” —— 简单、通用、可解释。在 2026 年,它通过与 MCP 协议和 LangGraph 的深度整合,从研究概念进化为了生产标准。
核心记忆点:
- Thought → Action → Observation 的循环是灵魂
- Step Budget 和 循环检测 是生产必备
- KV-Cache 复用 是成本控制的关键
- 超过 10 步的复杂任务 应考虑升级到 Plan-and-Execute
我是小鱼:
- CSDN 博客专家;
- AIGC 技术MVP专家;
- 阿里云 专家博主;
- 51CTO博客专家;
- 企业认证金牌面试官;
- 多个名企认证&特邀讲师等;
- 名企签约职场面试培训、职场规划师;
- 多个国内主流技术社区的认证专家博主;
- 多款主流产品(阿里云等)评测一等奖获得者;
关注小鱼,学习【人工智能与大模型】最新最全的领域知识。
《【智能体】Agent的四种设计模式之:React(2026最新版)》 是转载文章,点击查看原文。