前面讲了 SlotManager 分配 Slot 和 SlotPool 申请资源的源码实现,这篇聚焦 Flink 任务调度 Graph 的源码实现。Flink 任务从用户代码到实际执行,经历了三层 Graph 的演进:StreamGraph(流图)→ JobGraph(作业图)→ ExecutionGraph(执行图)。你有没有想过,用户写的 DataStream API 是如何变成可执行的任务的?算子链优化是如何合并算子的?并行度是如何展开的?调度器是如何调度 Execution 的?这篇从源码级别跟踪 Flink 任务调度 Graph 的完整演进链路。
一、任务调度 Graph 整体架构
下面这张图是任务调度 Graph 整体架构,包括三层 Graph 层级关系、调度关系和核心类。
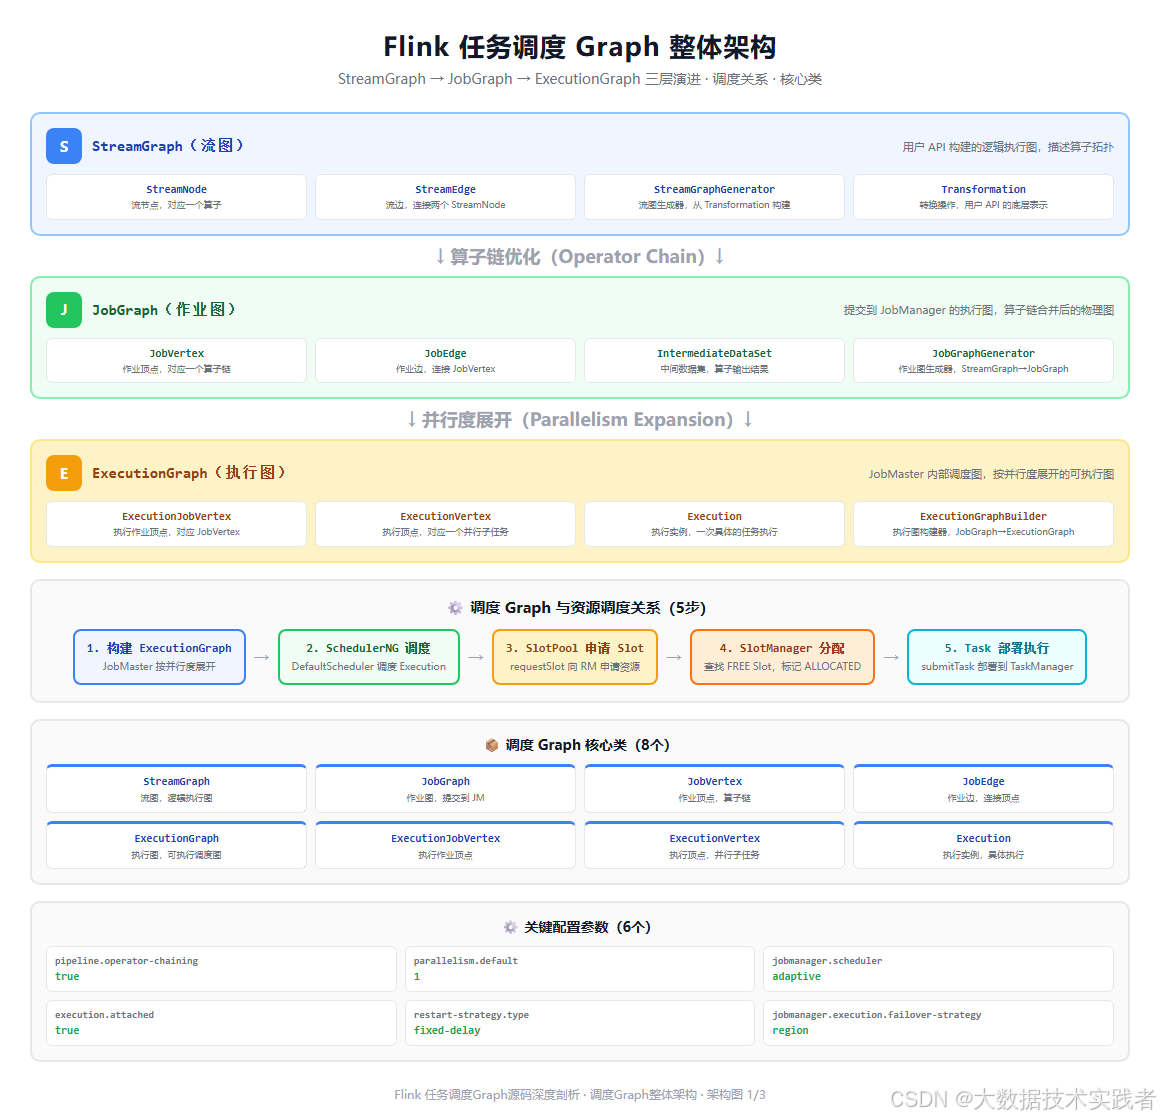
Flink 任务调度 Graph 分为三层,从逻辑到物理逐步演进:
- StreamGraph(流图):用户 API 构建的逻辑执行图,描述算子拓扑。包含 StreamNode(算子节点)和 StreamEdge(数据流边),从 Transformation 列表构建。
- JobGraph(作业图):提交到 JobManager 的执行图,算子链合并后的物理图。包含 JobVertex(作业顶点,对应算子链)、JobEdge(作业边)、IntermediateDataSet(中间数据集)。
- ExecutionGraph(执行图):JobMaster 内部调度图,按并行度展开的可执行图。包含 ExecutionJobVertex(执行作业顶点)、ExecutionVertex(执行顶点,对应并行子任务)、Execution(执行实例,具体执行)。
三层 Graph 的演进关系:StreamGraph 经过算子链优化(Operator Chain)生成 JobGraph,JobGraph 经过并行度展开(Parallelism Expansion)生成 ExecutionGraph。ExecutionGraph 构建完成后,SchedulerNG 调度 Execution,通过 SlotPool 申请 Slot,SlotManager 分配 Slot,最终部署 Task 到 TaskManager 执行。
二、JobGraph 构建流程
下面这张图是 JobGraph 构建流程,包括5步构建流程、算子链优化对比、组件关系和核心类。
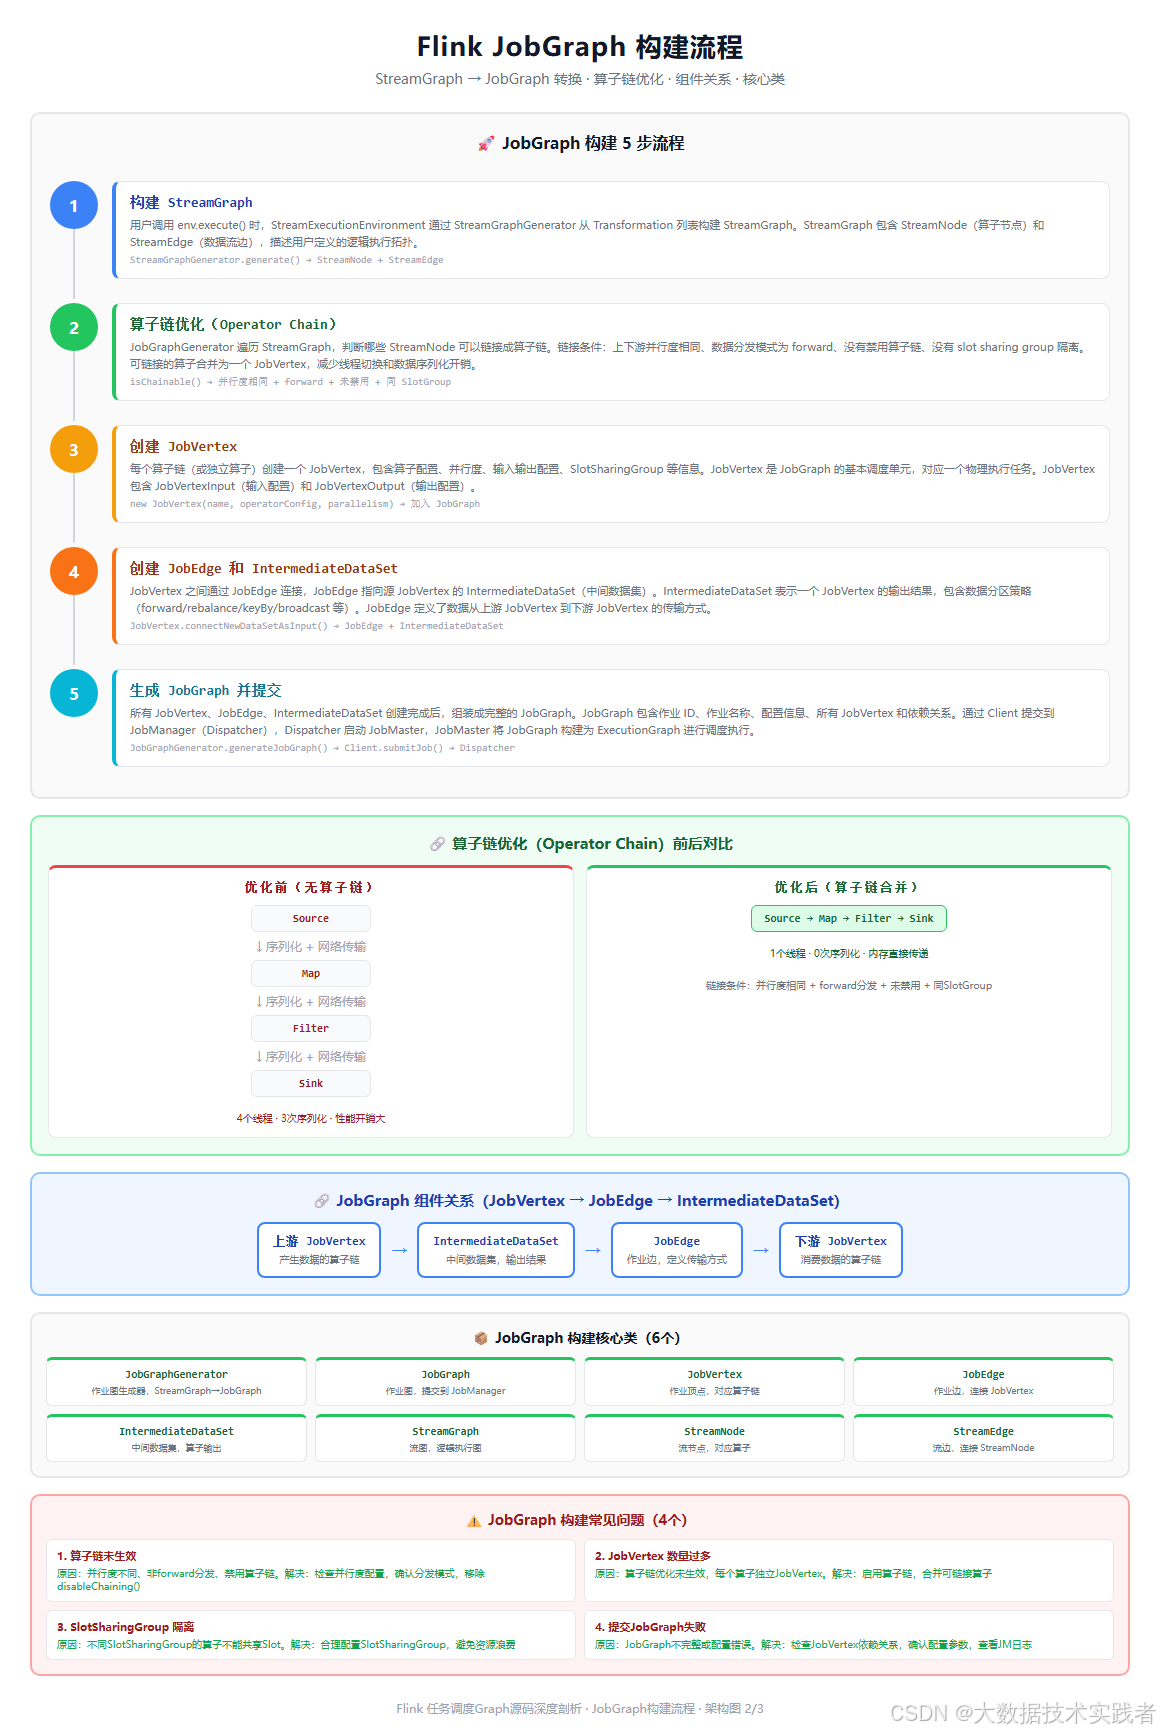
JobGraph 构建分为5步:
第1步:构建 StreamGraph。用户调用 env.execute() 时,StreamExecutionEnvironment 通过 StreamGraphGenerator 从 Transformation 列表构建 StreamGraph。StreamGraph 包含 StreamNode(算子节点)和 StreamEdge(数据流边),描述用户定义的逻辑执行拓扑。每个 Transformation 对应一个或多个 StreamNode,Transformation 之间的依赖关系对应 StreamEdge。
第2步:算子链优化(Operator Chain)。JobGraphGenerator 遍历 StreamGraph,判断哪些 StreamNode 可以链接成算子链。链接条件:上下游并行度相同、数据分发模式为 forward、没有禁用算子链(disableChaining)、没有 slot sharing group 隔离。可链接的算子合并为一个 JobVertex,减少线程切换和数据序列化开销。
第3步:创建 JobVertex。每个算子链(或独立算子)创建一个 JobVertex,包含算子配置、并行度、输入输出配置、SlotSharingGroup 等信息。JobVertex 是 JobGraph 的基本调度单元,对应一个物理执行任务。JobVertex 包含 JobVertexInput(输入配置)和 JobVertexOutput(输出配置)。
第4步:创建 JobEdge 和 IntermediateDataSet。JobVertex 之间通过 JobEdge 连接,JobEdge 指向源 JobVertex 的 IntermediateDataSet(中间数据集)。IntermediateDataSet 表示一个 JobVertex 的输出结果,包含数据分区策略(forward/rebalance/keyBy/broadcast 等)。JobEdge 定义了数据从上游 JobVertex 到下游 JobVertex 的传输方式。
第5步:生成 JobGraph 并提交。所有 JobVertex、JobEdge、IntermediateDataSet 创建完成后,组装成完整的 JobGraph。JobGraph 包含作业 ID、作业名称、配置信息、所有 JobVertex 和依赖关系。通过 Client 提交到 JobManager(Dispatcher),Dispatcher 启动 JobMaster,JobMaster 将 JobGraph 构建为 ExecutionGraph 进行调度执行。
算子链优化的价值
算子链优化是 Flink 重要的性能优化手段。优化前,Source、Map、Filter、Sink 四个算子各自独立,需要4个线程,3次序列化和网络传输,性能开销大。优化后,四个算子合并为一个算子链,只需要1个线程,0次序列化,数据在内存中直接传递,性能显著提升。
算子链的链接条件需要同时满足:
- 上下游并行度相同
- 数据分发模式为 forward(一对一)
- 没有调用 disableChaining() 禁用算子链
- 上下游属于同一个 SlotSharingGroup
三、ExecutionGraph 构建与调度
下面这张图是 ExecutionGraph 构建与调度,包括6步构建流程、并行度展开、Execution 状态机和配置最佳实践。
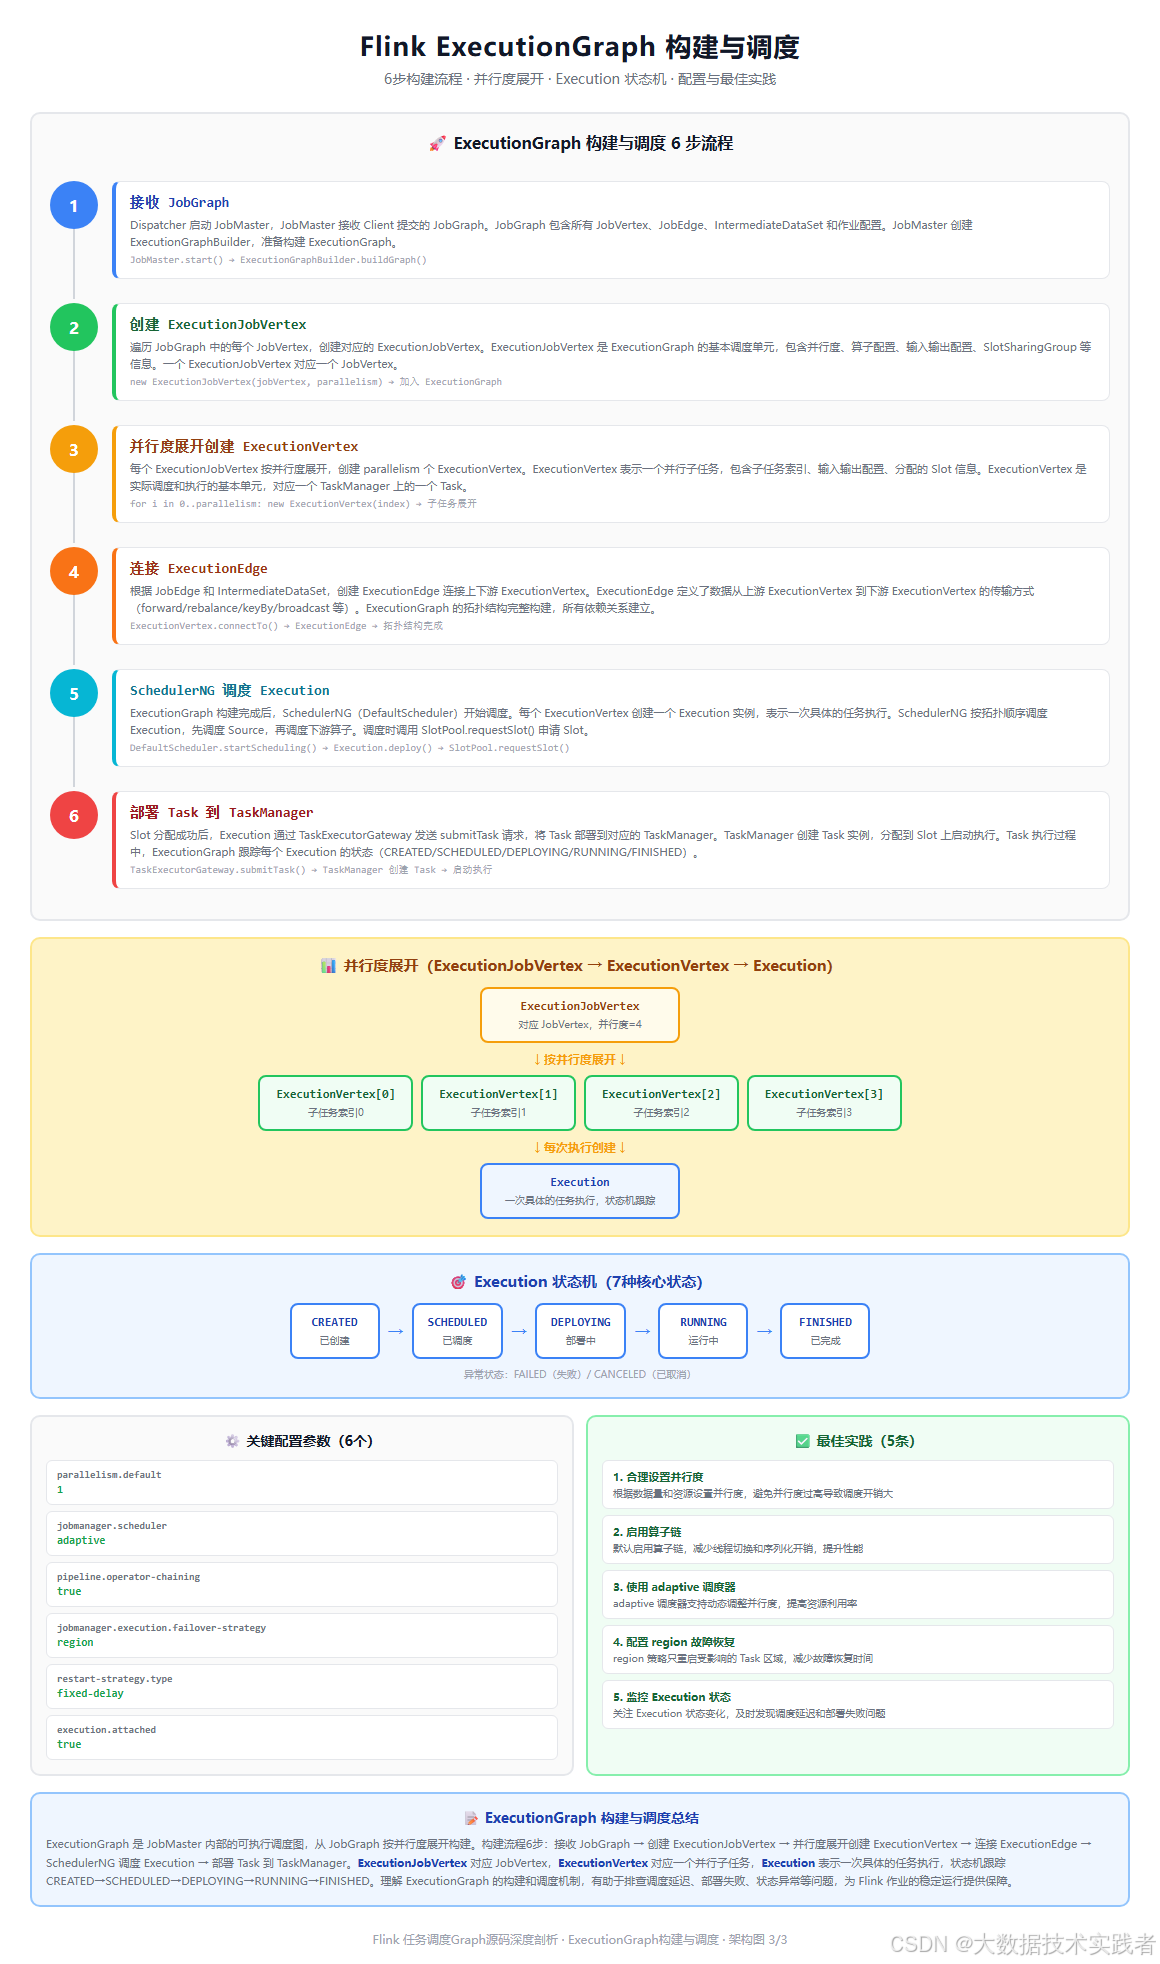
ExecutionGraph 构建与调度分为6步:
第1步:接收 JobGraph。Dispatcher 启动 JobMaster,JobMaster 接收 Client 提交的 JobGraph。JobGraph 包含所有 JobVertex、JobEdge、IntermediateDataSet 和作业配置。JobMaster 创建 ExecutionGraphBuilder,准备构建 ExecutionGraph。
第2步:创建 ExecutionJobVertex。遍历 JobGraph 中的每个 JobVertex,创建对应的 ExecutionJobVertex。ExecutionJobVertex 是 ExecutionGraph 的基本调度单元,包含并行度、算子配置、输入输出配置、SlotSharingGroup 等信息。一个 ExecutionJobVertex 对应一个 JobVertex。
第3步:并行度展开创建 ExecutionVertex。每个 ExecutionJobVertex 按并行度展开,创建 parallelism 个 ExecutionVertex。ExecutionVertex 表示一个并行子任务,包含子任务索引、输入输出配置、分配的 Slot 信息。ExecutionVertex 是实际调度和执行的基本单元,对应一个 TaskManager 上的一个 Task。
第4步:连接 ExecutionEdge。根据 JobEdge 和 IntermediateDataSet,创建 ExecutionEdge 连接上下游 ExecutionVertex。ExecutionEdge 定义了数据从上游 ExecutionVertex 到下游 ExecutionVertex 的传输方式(forward/rebalance/keyBy/broadcast 等)。ExecutionGraph 的拓扑结构完整构建,所有依赖关系建立。
第5步:SchedulerNG 调度 Execution。ExecutionGraph 构建完成后,SchedulerNG(DefaultScheduler)开始调度。每个 ExecutionVertex 创建一个 Execution 实例,表示一次具体的任务执行。SchedulerNG 按拓扑顺序调度 Execution,先调度 Source,再调度下游算子。调度时调用 SlotPool.requestSlot() 申请 Slot。
第6步:部署 Task 到 TaskManager。Slot 分配成功后,Execution 通过 TaskExecutorGateway 发送 submitTask 请求,将 Task 部署到对应的 TaskManager。TaskManager 创建 Task 实例,分配到 Slot 上启动执行。Task 执行过程中,ExecutionGraph 跟踪每个 Execution 的状态。
并行度展开机制
并行度展开是 ExecutionGraph 的核心机制。一个 ExecutionJobVertex(对应 JobVertex,并行度=4)按并行度展开为4个 ExecutionVertex(子任务索引0-3),每个 ExecutionVertex 每次执行创建一个 Execution 实例。ExecutionVertex 是静态的(对应一个并行子任务),Execution 是动态的(对应一次具体的执行,可能因故障重试而多次创建)。
Execution 状态机
Execution 有7种核心状态,状态转换严格按顺序执行:
- CREATED:已创建,Execution 实例创建完成
- SCHEDULED:已调度,SchedulerNG 已调度,等待 Slot 分配
- DEPLOYING:部署中,Slot 已分配,正在向 TaskManager 部署 Task
- RUNNING:运行中,Task 已启动,正在执行
- FINISHED:已完成,Task 执行成功完成
- FAILED:失败,Task 执行失败
- CANCELED:已取消,Task 被取消
四、核心类源码剖析
4.1 StreamGraph 流图
1public class StreamGraph {
2    private final String jobName;
3    private final Map<Integer, StreamNode> streamNodes;
4    private final Set<StreamEdge> streamEdges;
5    private final Map<Integer, List<StreamEdge>> inEdges;
6    private final Map<Integer, List<StreamEdge>> outEdges;
7
8    public void addOperator(
9            Integer vertexID,
10            String slotSharingGroup,
11            String coLocationGroup,
12            StreamOperatorFactory operatorFactory,
13            TypeInformation inTypeInfo,
14            TypeInformation outTypeInfo,
15            String operatorName) {
16        // 创建 StreamNode 并加入映射
17        StreamNode vertex = new StreamNode(
18            vertexID, slotSharingGroup, coLocationGroup,
19            operatorFactory, operatorName, inTypeInfo, outTypeInfo);
20        streamNodes.put(vertexID, vertex);
21    }
22
23    public void addEdge(Integer sourceId, Integer targetId, int typeNumber, String outputName) {
24        // 创建 StreamEdge 连接两个 StreamNode
25        StreamNode source = streamNodes.get(sourceId);
26        StreamNode target = streamNodes.get(targetId);
27        StreamEdge edge = new StreamEdge(source, target, typeNumber, outputName);
28        streamEdges.add(edge);
29        outEdges.get(sourceId).add(edge);
30        inEdges.get(targetId).add(edge);
31    }
32
33    public StreamNode getStreamNode(Integer vertexID) {
34        return streamNodes.get(vertexID);
35    }
36}
37
38public class StreamNode {
39    private final int id;
40    private final StreamOperatorFactory operatorFactory;
41    private final String operatorName;
42    private int parallelism;
43    private String slotSharingGroup;
44    private List<StreamEdge> inEdges;
45    private List<StreamEdge> outEdges;
46}
47
StreamGraph 是逻辑执行图,包含 StreamNode(算子节点)和 StreamEdge(数据流边)。addOperator 方法创建 StreamNode 并加入映射,addEdge 方法创建 StreamEdge 连接两个 StreamNode。StreamNode 包含算子工厂、并行度、SlotSharingGroup、输入输出边等信息。
4.2 JobGraph 作业图
1public class JobGraph {
2    private final JobID jobID;
3    private String name;
4    private final Map<JobVertexID, JobVertex> taskVertices;
5    private final List<JobEdge> jobEdges;
6
7    public void addVertex(JobVertex vertex) {
8        // 添加 JobVertex 到作业图
9        taskVertices.put(vertex.getID(), vertex);
10    }
11
12    public void addEdge(JobEdge edge) {
13        // 添加 JobEdge 到作业图
14        jobEdges.add(edge);
15    }
16
17    public JobVertex findVertexByID(JobVertexID id) {
18        return taskVertices.get(id);
19    }
20}
21
22public class JobVertex {
23    private final JobVertexID id;
24    private String name;
25    private int parallelism;
26    private StreamConfig configuration;
27    private String slotSharingGroup;
28    private List<JobEdge> inputs;
29    private List<IntermediateDataSet> results;
30
31    public void connectNewDataSetAsInput(
32            JobVertex input,
33            DistributionPattern distributionPattern,
34            boolean isBroadcast) {
35        // 创建 IntermediateDataSet 和 JobEdge
36        IntermediateDataSet dataSet = input.createAndAddResultDataSet(
37            this, distributionPattern);
38        JobEdge edge = new JobEdge(dataSet, this, distributionPattern);
39        inputs.add(edge);
40    }
41
42    public IntermediateDataSet createAndAddResultDataSet(
43            JobVertex consumer,
44            DistributionPattern pattern) {
45        // 创建中间数据集
46        IntermediateDataSet dataSet = new IntermediateDataSet(
47            new IntermediateDataSetID(), pattern, this);
48        results.add(dataSet);
49        return dataSet;
50    }
51}
52
53public class IntermediateDataSet {
54    private final IntermediateDataSetID id;
55    private final DistributionPattern distributionPattern;
56    private final JobVertex producer;
57    private final List<JobEdge> consumers;
58}
59
60public class JobEdge {
61    private final IntermediateDataSet source;
62    private final JobVertex target;
63    private final DistributionPattern distributionPattern;
64}
65
JobGraph 是提交到 JobManager 的物理执行图,包含 JobVertex(作业顶点)、JobEdge(作业边)、IntermediateDataSet(中间数据集)。JobVertex.connectNewDataSetAsInput 方法创建 IntermediateDataSet 和 JobEdge,连接上下游 JobVertex。IntermediateDataSet 表示一个 JobVertex 的输出结果,包含数据分区策略。JobEdge 定义了数据传输方式。
4.3 ExecutionGraph 执行图
1public class ExecutionGraph {
2    private final JobID jobID;
3    private String jobName;
4    private final Map<JobVertexID, ExecutionJobVertex> tasks;
5    private final List<ExecutionVertex> allVertices;
6    private SchedulerNG scheduler;
7
8    public void attachJobGraph(List<JobVertex> topologiallySorted) throws Exception {
9        // 遍历 JobVertex,创建 ExecutionJobVertex
10        for (JobVertex jobVertex : topologiallySorted) {
11            ExecutionJobVertex ejv = new ExecutionJobVertex(
12                this, jobVertex, jobVertex.getParallelism());
13            tasks.put(jobVertex.getID(), ejv);
14        }
15
16        // 连接 ExecutionEdge
17        for (ExecutionJobVertex ejv : tasks.values()) {
18            ejv.connectToPredecessors();
19        }
20    }
21}
22
23public class ExecutionJobVertex {
24    private final ExecutionGraph graph;
25    private final JobVertex jobVertex;
26    private final int parallelism;
27    private final ExecutionVertex[] taskVertices;
28
29    public ExecutionJobVertex(
30            ExecutionGraph graph,
31            JobVertex jobVertex,
32            int parallelism) {
33        this.graph = graph;
34        this.jobVertex = jobVertex;
35        this.parallelism = parallelism;
36        // 按并行度展开,创建 ExecutionVertex 数组
37        this.taskVertices = new ExecutionVertex[parallelism];
38        for (int i = 0; i < parallelism; i++) {
39            taskVertices[i] = new ExecutionVertex(
40                this, i, jobVertex.getConfiguration());
41        }
42    }
43
44    public void connectToPredecessors() {
45        // 连接上下游 ExecutionVertex
46        for (int i = 0; i < parallelism; i++) {
47            taskVertices[i].connectSource();
48        }
49    }
50
51    public ExecutionVertex[] getTaskVertices() {
52        return taskVertices;
53    }
54}
55
56public class ExecutionVertex {
57    private final ExecutionJobVertex jobVertex;
58    private final int subTaskIndex;
59    private final StreamConfig configuration;
60    private Execution currentExecution;
61    private SlotAndLocality assignedSlot;
62
63    public ExecutionVertex(
64            ExecutionJobVertex jobVertex,
65            int subTaskIndex,
66            StreamConfig configuration) {
67        this.jobVertex = jobVertex;
68        this.subTaskIndex = subTaskIndex;
69        this.configuration = configuration;
70    }
71
72    public void deploy() throws Exception {
73        // 创建 Execution 实例并部署
74        currentExecution = new Execution(this, subTaskIndex);
75        currentExecution.deploy();
76    }
77
78    public Execution getCurrentExecution() {
79        return currentExecution;
80    }
81}
82
83public class Execution {
84    private final ExecutionVertex vertex;
85    private final int attemptNumber;
86    private ExecutionState state;
87    private CompletableFuture<Void> releaseFuture;
88
89    public Execution(ExecutionVertex vertex, int attemptNumber) {
90        this.vertex = vertex;
91        this.attemptNumber = attemptNumber;
92        this.state = ExecutionState.CREATED;
93    }
94
95    public void deploy() throws Exception {
96        // 状态转换:CREATED → SCHEDULED → DEPLOYING → RUNNING
97        checkState(state == ExecutionState.CREATED);
98        state = ExecutionState.SCHEDULED;
99        // 申请 Slot,部署 Task
100        state = ExecutionState.DEPLOYING;
101        // TaskManager.submitTask()
102        state = ExecutionState.RUNNING;
103    }
104
105    public void markFinished() {
106        checkState(state == ExecutionState.RUNNING);
107        state = ExecutionState.FINISHED;
108    }
109}
110
111public enum ExecutionState {
112    CREATED, SCHEDULED, DEPLOYING, RUNNING, FINISHED, FAILED, CANCELED
113}
114
ExecutionGraph 是 JobMaster 内部的可执行调度图。attachJobGraph 方法遍历 JobVertex,创建 ExecutionJobVertex,然后连接 ExecutionEdge。ExecutionJobVertex 按并行度展开创建 ExecutionVertex 数组,每个 ExecutionVertex 对应一个并行子任务。ExecutionVertex.deploy 方法创建 Execution 实例,Execution 管理任务执行的状态机(CREATED→SCHEDULED→DEPLOYING→RUNNING→FINISHED)。
五、关键配置参数
1# 默认并行度
2parallelism.default: 1
3
4# 调度器类型
5jobmanager.scheduler: adaptive
6
7# 算子链优化
8pipeline.operator-chaining: true
9
10# 故障恢复策略
11jobmanager.execution.failover-strategy: region
12
13# 重启策略类型
14restart-strategy.type: fixed-delay
15
16# 固定延迟重启次数
17restart-strategy.fixed-delay.attempts: 3
18
19# 固定延迟重启间隔
20restart-strategy.fixed-delay.delay: 10s
21
22# 执行模式
23execution.attached: true
24
25# Slot 请求超时
26slotmanager.request-timeout: 5min
27
28# 每个 TaskManager 的 Slot 数
29taskmanager.numberOfTaskSlots: 1
30
关键配置说明:
- parallelism.default:默认并行度,所有算子的默认并行度,可在代码中单独设置。
- jobmanager.scheduler:调度器类型,adaptive 支持动态调整并行度,根据可用 Slot 数自动调整。
- pipeline.operator-chaining:算子链优化,默认 true,启用后可链接的算子合并为一个 JobVertex。
- jobmanager.execution.failover-strategy:故障恢复策略,region 只重启受影响的 Task 区域,减少故障恢复时间。
- restart-strategy:重启策略,fixed-delay 固定延迟重试,failure-rate 失败率重试。
- slotmanager.request-timeout:Slot 请求超时,默认5分钟,大作业可调大到10-15分钟。
六、常见问题与最佳实践
常见问题
- 算子链未生效
- 原因:并行度不同、非 forward 分发、禁用算子链、不同 SlotSharingGroup。
- 解决:检查并行度配置,确认分发模式为 forward,移除 disableChaining(),确认 SlotSharingGroup 配置。
- JobVertex 数量过多
- 原因:算子链优化未生效,每个算子独立 JobVertex,导致调度开销大。
- 解决:启用算子链,合并可链接算子,减少 JobVertex 数量。
- Execution 调度延迟
- 原因:Slot 不足、调度器配置不当、依赖关系复杂。
- 解决:增加 TM 数量,使用 adaptive 调度器,优化算子拓扑,检查 Slot 分配状态。
- 部署 Task 失败
- 原因:TaskManager 无响应、网络异常、资源不足。
- 解决:检查 TM 心跳,确认网络连通,增加资源,查看 TM 日志。
- Execution 状态异常
- 原因:状态转换非法、并发问题、故障恢复失败。
- 解决:检查日志,重启 JM,配置重启策略,查看 ExecutionGraph 状态。
- SlotSharingGroup 隔离
- 原因:不同 SlotSharingGroup 的算子不能共享 Slot,导致资源浪费。
- 解决:合理配置 SlotSharingGroup,避免不必要的隔离,提高资源利用率。
最佳实践
- 合理设置并行度:根据数据量和资源设置并行度,避免并行度过高导致调度开销大,或过低导致处理能力不足。Source 并行度受数据源分片数限制。
- 启用算子链:默认启用算子链,减少线程切换和序列化开销,提升性能。只有在需要隔离或调试时才禁用算子链。
- 使用 adaptive 调度器:adaptive 调度器支持动态调整并行度,根据可用 Slot 数自动调整,提高资源利用率和作业稳定性。适合资源波动较大的环境。
- 配置 region 故障恢复:region 策略只重启受影响的 Task 区域,而不是整个作业,减少故障恢复时间和资源消耗。适合大多数流处理作业。
- 监控 Execution 状态:关注 Execution 状态变化,及时发现调度延迟和部署失败问题。监控 SCHEDULED 状态持续时间,过长说明 Slot 分配延迟。
- 合理配置 SlotSharingGroup:默认所有算子共享同一个 SlotSharingGroup,提高资源利用率。只有在需要资源隔离时才配置独立的 SlotSharingGroup。
- 优化算子拓扑:减少不必要的 shuffle,使用 forward 分发模式,促进算子链合并。避免数据倾斜,合理设计 keyBy 字段。
七、总结
Flink 任务调度 Graph 经历三层演进:StreamGraph(流图,逻辑执行图)→ JobGraph(作业图,算子链合并后的物理图)→ ExecutionGraph(执行图,按并行度展开的可执行图)。StreamGraph 从 Transformation 构建,包含 StreamNode 和 StreamEdge。JobGraph 经过算子链优化,包含 JobVertex、JobEdge、IntermediateDataSet。ExecutionGraph 按并行度展开,包含 ExecutionJobVertex、ExecutionVertex、Execution,是实际调度和执行的图。
核心类包括 StreamGraph(逻辑执行图)、JobGraph(物理执行图)、JobVertex(作业顶点)、JobEdge(作业边)、IntermediateDataSet(中间数据集)、ExecutionGraph(可执行调度图)、ExecutionJobVertex(执行作业顶点)、ExecutionVertex(执行顶点,并行子任务)、Execution(执行实例,状态机跟踪)。算子链优化合并可链接的算子,减少线程切换和序列化开销。并行度展开将 ExecutionJobVertex 展开为多个 ExecutionVertex。Execution 状态机跟踪 CREATED→SCHEDULED→DEPLOYING→RUNNING→FINISHED。
理解任务调度 Graph 的三层演进和核心类实现,有助于排查算子链未生效、JobVertex 数量过多、调度延迟、部署失败、状态异常等常见问题,为 Flink 作业的稳定运行提供保障。合理设置并行度、启用算子链、使用 adaptive 调度器、配置 region 故障恢复、监控 Execution 状态,可以显著提高作业的性能和稳定性。
《Flink 任务调度 Graph 源码深度剖析:从 StreamGraph 到 ExecutionGraph 的三层演进》 是转载文章,点击查看原文。

