🔥承渊政道:个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》 《MySQL数据库学习》 《Python知识内容》 《cpolar知识学习》
✨逆境不吐心中苦,顺境不忘来时路!✨
🎬 博主简介:
读一篇优秀的数学建模论文,我通常不只想知道它“用了什么模型”.更想弄明白的是:问题是怎样拆开的,假设和约束如何对应,结果表格怎样组织,以及这些做法能给自己的论文哪些启发.这次我拿一篇他人的优秀建模论文做了文档整理实验.文件名为
26国赛C题.docx,解析结果记录为43页.我的目标是把它整理成方便阅读、检索和对照的学习资料,再用来复盘自己的论文.使用的组合是 WorkBuddy + 蓝耘元生代 GLM-5.3-Flash + TextIn xParse 连接器.过程从创建API Key、接入模型开始,最后得到全文 Markdown、结构化 JSON,以及单独整理的表格、公式和图片.先交代一个没有完全处理好的细节:公式源码能够提取和复制,但截图中的公式预览没有正常渲染,这部分我没有继续修复.后面会把文件生成、内容检查和显示效果分开说明.
目录
- 1.先看结果:一篇论文被整理成了哪些资料
- 2.三个工具分别做什么,为什么用蓝耘接入
- 3.从蓝耘模型广场开始配置
-
- 3.1找到本次使用的模型
- 3.2创建API Key
- 3.3确认文本模型接口地址
- 4.在WorkBuddy中接入蓝耘模型
- 5.启用xParse,先把论文解析出来
- 6.实际需求:全文能读了,表格、公式和图片怎么单独拿出来
-
- 6.1表格:从整篇阅读转向逐项对照
- 6.2公式:源码可复制,预览还没有处理好
- 6.3图片:保留索引,也看见索引的不足
- 6.4JSON:给后续程序处理留一个入口
- 7.蓝耘用量记录:33次调用,平台显示消费0.32元
- 8.整理完之后,怎样用于自己的论文学习
- 9.给开发者补充:配置之外的接口边界
- 10.这次体验留下的判断
1.先看结果:一篇论文被整理成了哪些资料
两轮指令之后,WorkBuddy 展示了以下产物:
| 产物 | 本次结果 | 对学习的作用 |
|---|---|---|
| 全文 Markdown | 已生成,另有图片本地化版本 | 连续阅读、搜索关键词、定位章节 |
| 结构化 JSON | 已生成,页面记录 page_count: 43 | 为按页码、类型继续处理内容提供基础 |
| 表格 | 21 个表格条目,包含续表 | 单独查看结果组织方式,导出 Markdown 和 CSV |
| 公式 | 汇总页记录 34 个独立公式 | 复制 LaTeX 源码,对照变量、目标函数与约束 |
| 图片 | 47 张导出图片及图片清单 | 按页码回看图表,学习可视化表达 |
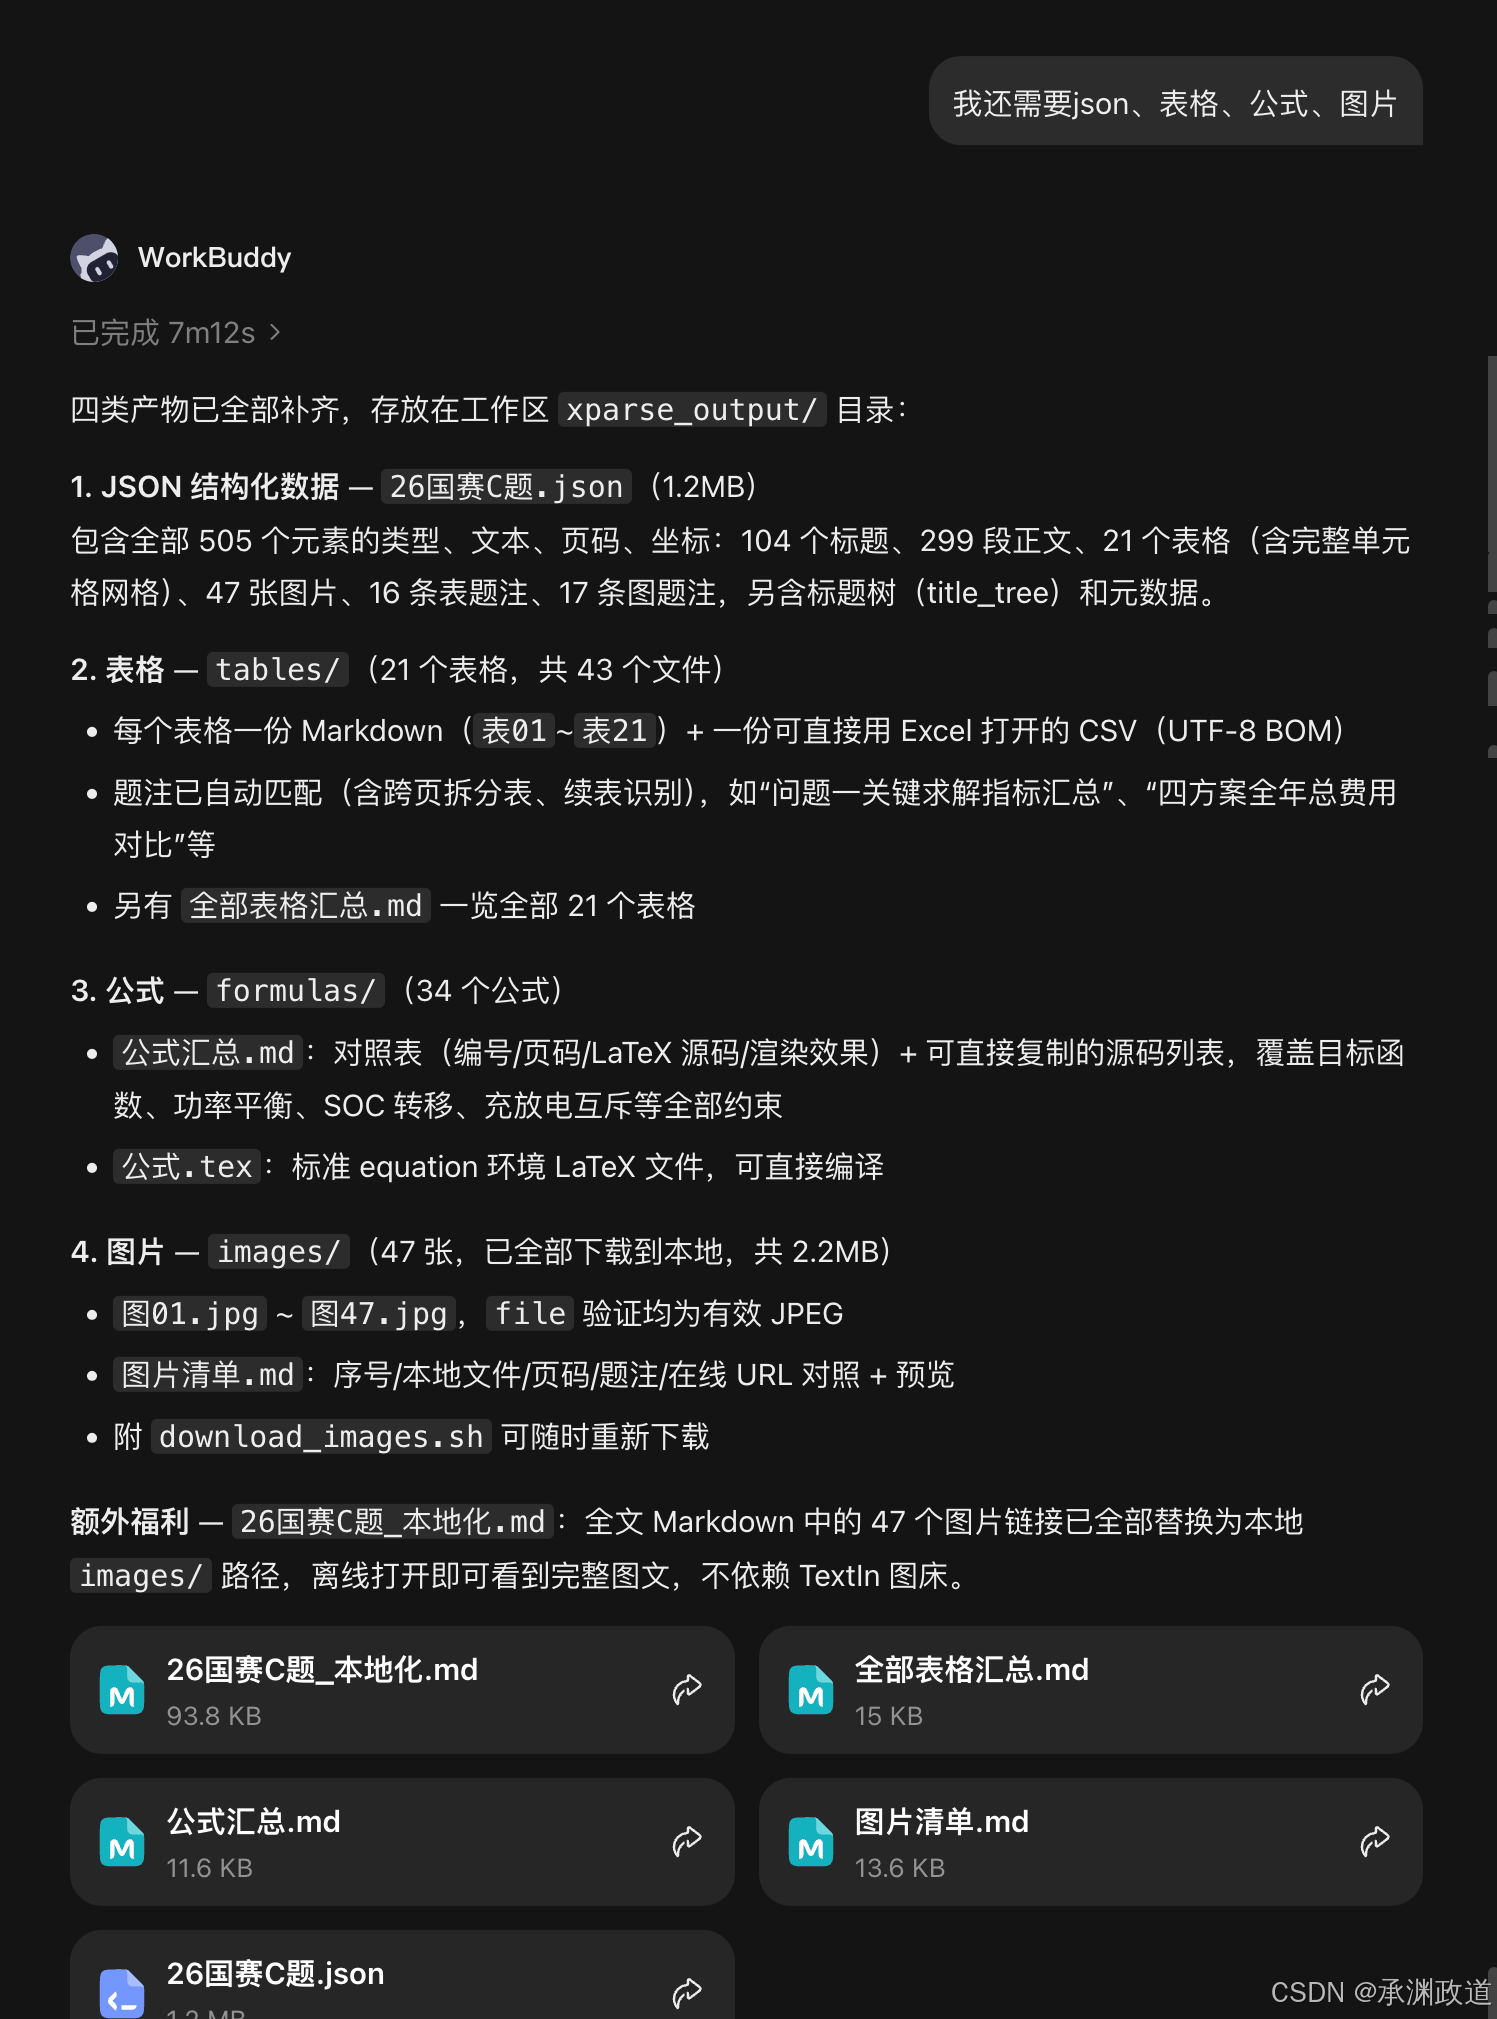
这里的数量来自本次产物汇总及截图.特别是表格,清单里有跨页后的“续”条目,因此 21 个表格条目不能直接理解为 21 张彼此独立的逻辑表格.
我对导出内容进行了人工检查,结果能够满足本次学习和整理需求.不过,这不是逐字符标注的准确率评测,也不能据此保证换一篇排版复杂的论文仍然有同样效果.
2.三个工具分别做什么,为什么用蓝耘接入
整个流程可以这样理解:
1我:上传论文,说明需要哪些资料
2                  ↓
3WorkBuddy:组织任务、调用连接器和文件工具
4   ↔ 蓝耘元生代:提供 GLM-5.3-Flash 模型调用服务
5                  ↓
6TextIn xParse:解析论文的文本与版面结构
7                  ↓
8WorkBuddy 在模型参与下继续整理解析结果
9                  ↓
10Markdown / JSON / 表格 / 公式源码 / 图片
11
蓝耘元生代提供模型服务。 我把平台的接口地址、API Key 和所选模型配置到 WorkBuddy,后续通过蓝耘查看该模型的调用记录与消费情况.
WorkBuddy 提供操作入口和执行环境。 上传附件、发送指令、启用连接器、生成文件、预览产物,都在这里完成.
TextIn xParse 提供文档解析能力。 本次明确调用的是它的智能文档解析连接器.不能把连接器对表格、公式和图片的解析结果,全都归功于GLM模型.TextIn 官方也将结构化文档解析以及 Markdown、JSON 等输出列为其产品能力.TextIn 官方介绍
对这次任务而言,通过蓝耘接入的实际价值主要有三点:
- 接入方式适合现有工具。 蓝耘提供 OpenAI 兼容接口,WorkBuddy 有自定义模型配置入口,本次可以通过界面完成接入.
- 模型信息和调用入口集中。 在蓝耘模型广场查看模型详情、价格和 API 示例,再到 API KEY 管理中创建凭证,操作路径比较清楚.
- 运行后能回看用量。 不只看聊天窗口有没有返回结果,还能在蓝耘核对模型、调用次数、失败数和平台显示的消费金额.
这些也是这个组合值得分享的原因.本文没有进行其他平台的同条件对比,因此不作“全网最低价”或“比某平台更快”的判断.蓝耘的统一接口与用量管理能力可参阅其官方 MaaS 页面.
3.从蓝耘模型广场开始配置
3.1找到本次使用的模型
进入蓝耘元生代的 MaaS 平台,在模型广场找到 glm-5.3-flash,打开详情.
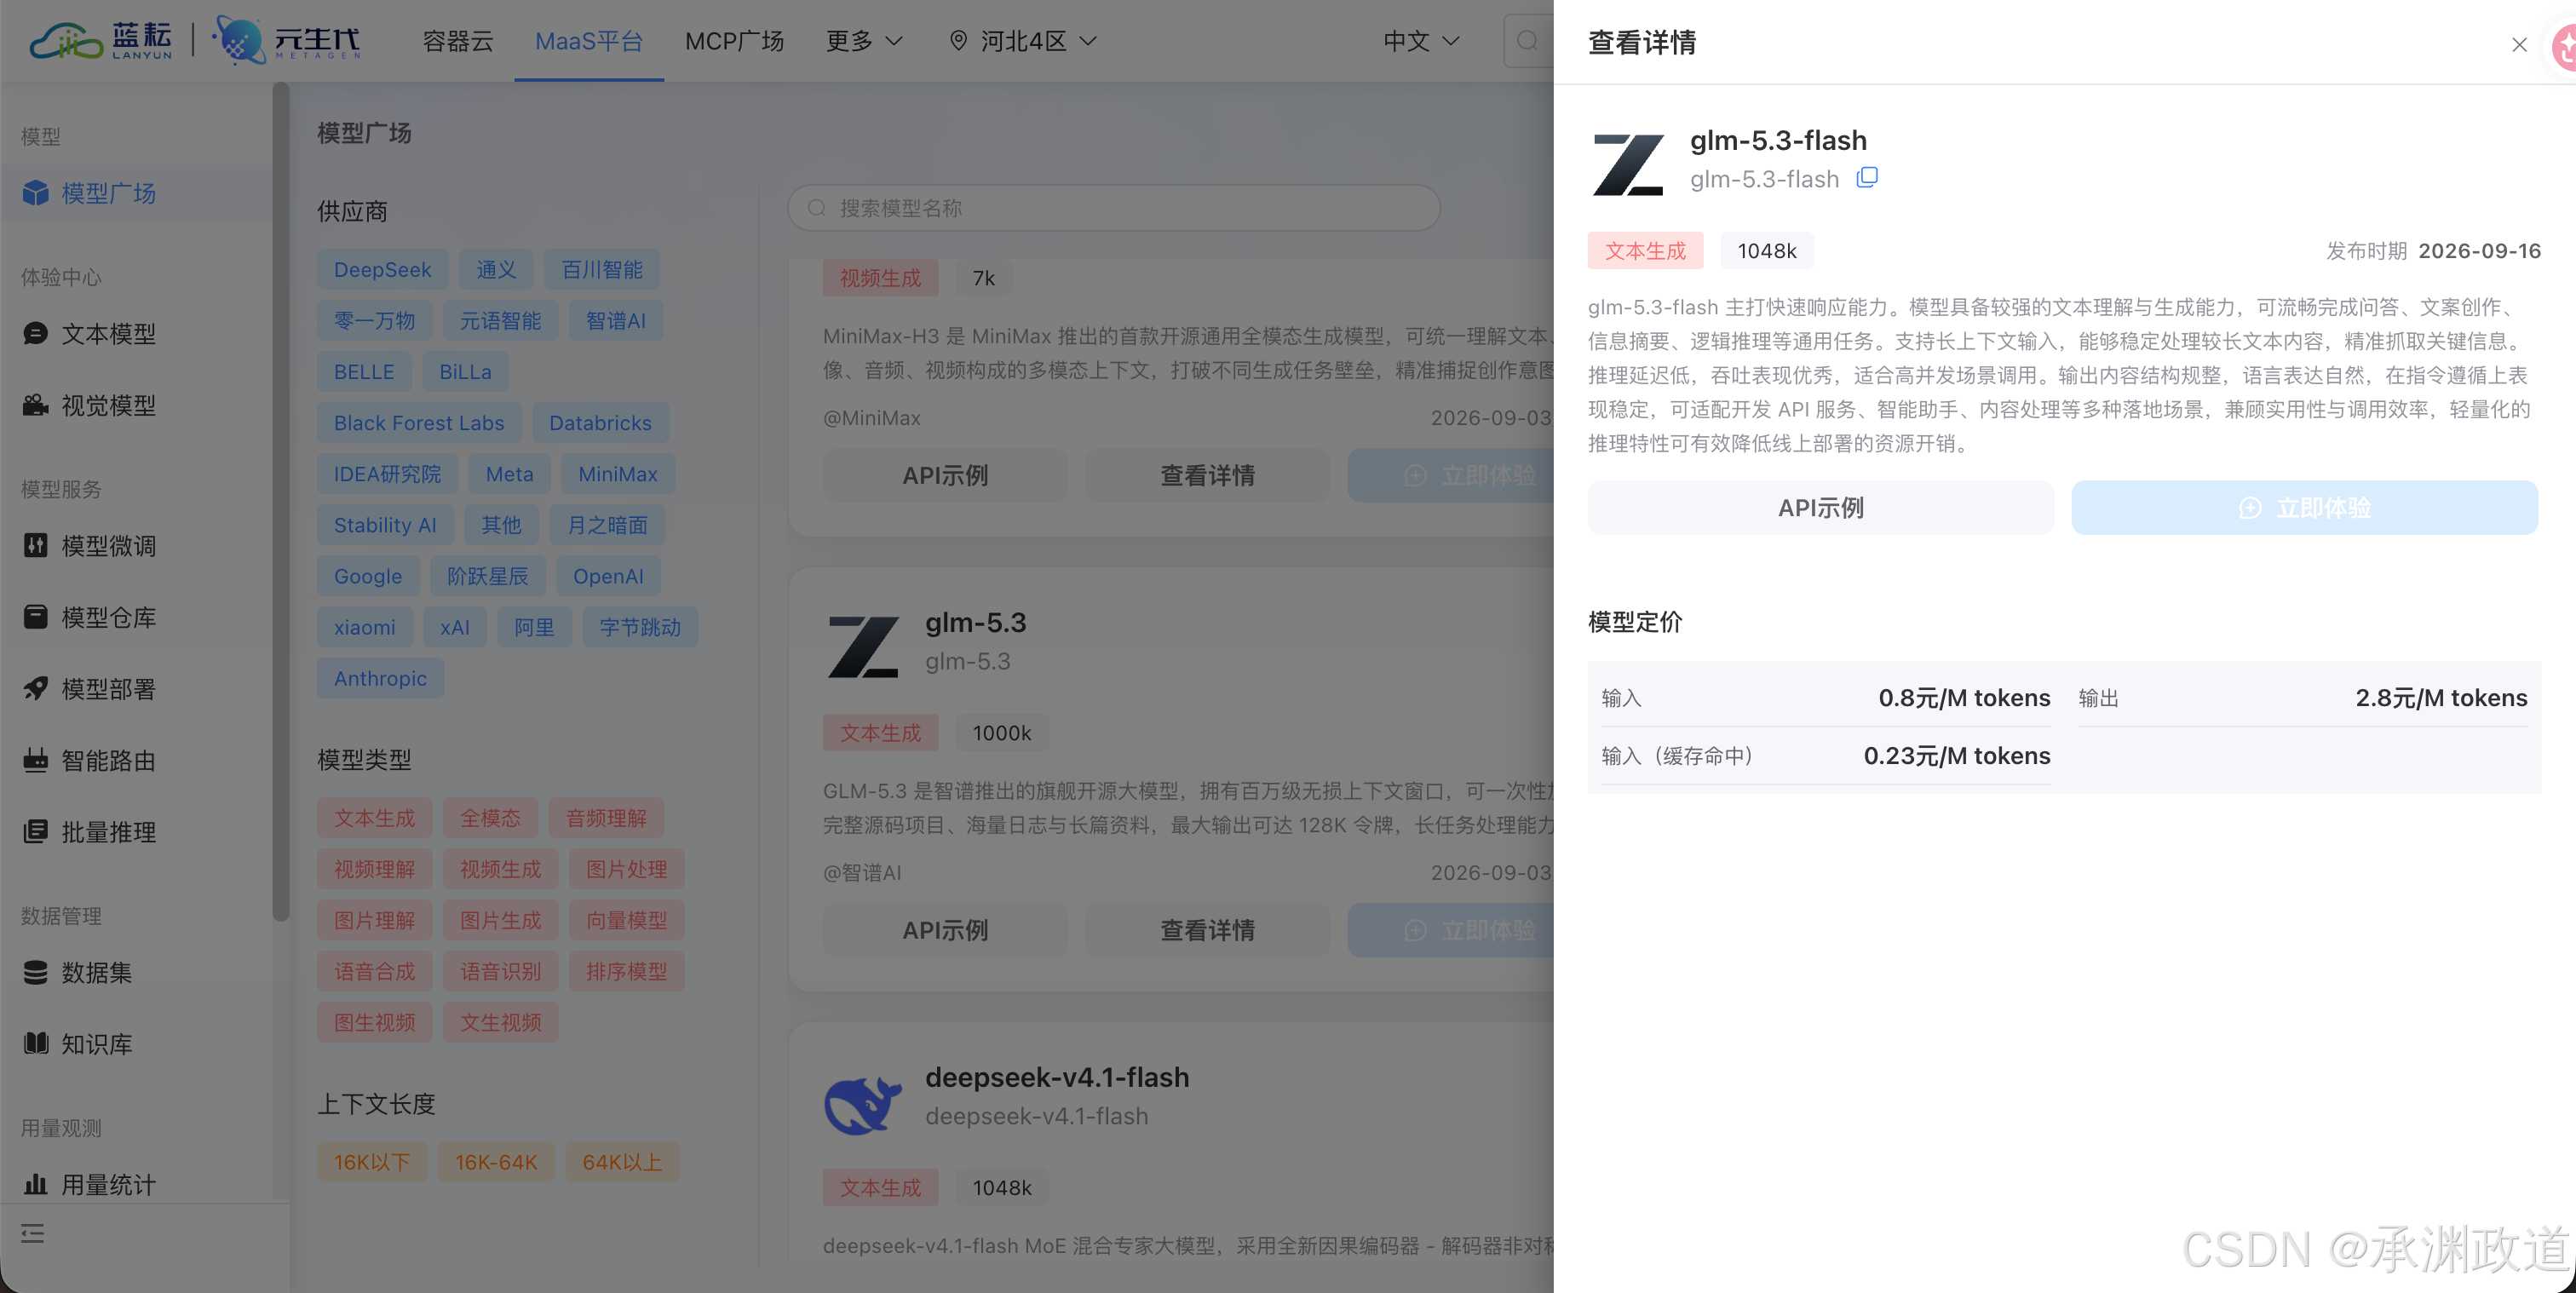
本次截图中的标价为:
| 计费项目 | 截图中的价格 |
|---|---|
| 输入 | 0.8 元 / 百万 tokens |
| 输入(缓存命中) | 0.23 元 / 百万 tokens |
| 输出 | 2.8 元 / 百万 tokens |
这张图用于记录当时看到的价格.实际费用还需要结合账单明细,不能把总 token 数直接乘某一个单价.
3.2创建API Key
打开“API KEY 管理”,点击“创建 API KEY”.我在备注里填写了 GLM-5.3-Flash,方便识别本次使用的凭证.
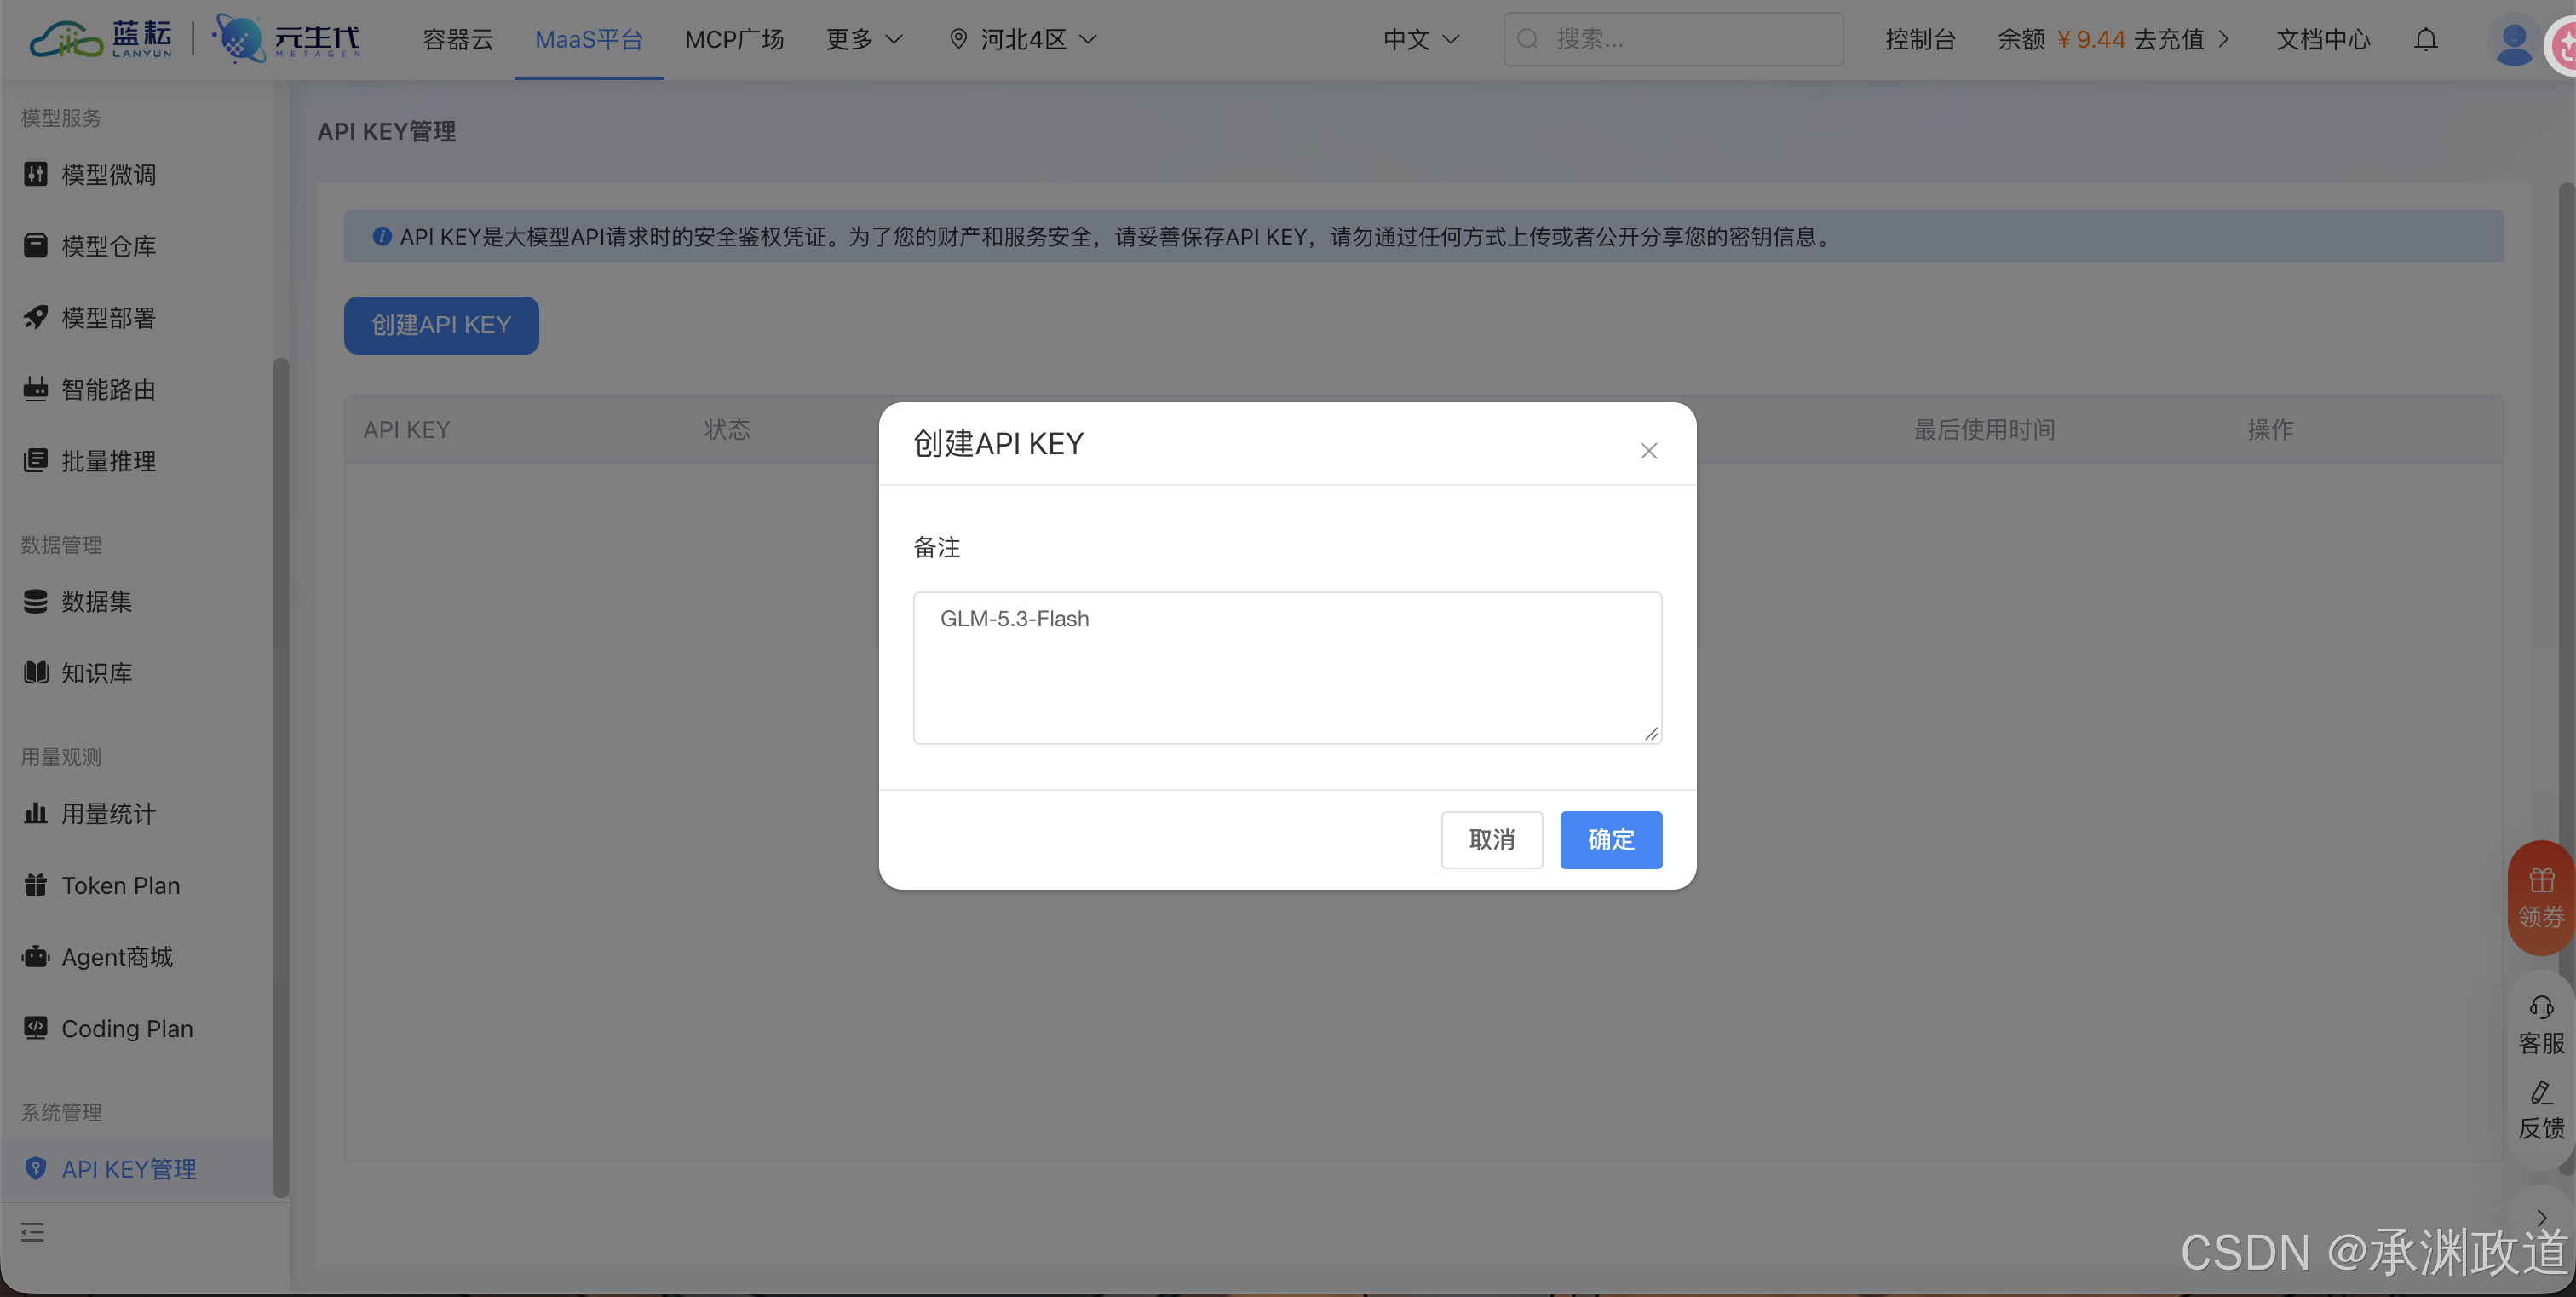
备注只是管理标签,不代表凭证只能调用该模型.真正指定模型的是客户端配置及请求里的模型字段.创建完成后,把自己的Key填入WorkBuddy;文章和分享截图中不要展示完整 Key.
3.3确认文本模型接口地址
本次蓝耘文档截图给出的完整请求地址是:
1https://maas-api.lanyun.net/v1/chat/completions
2
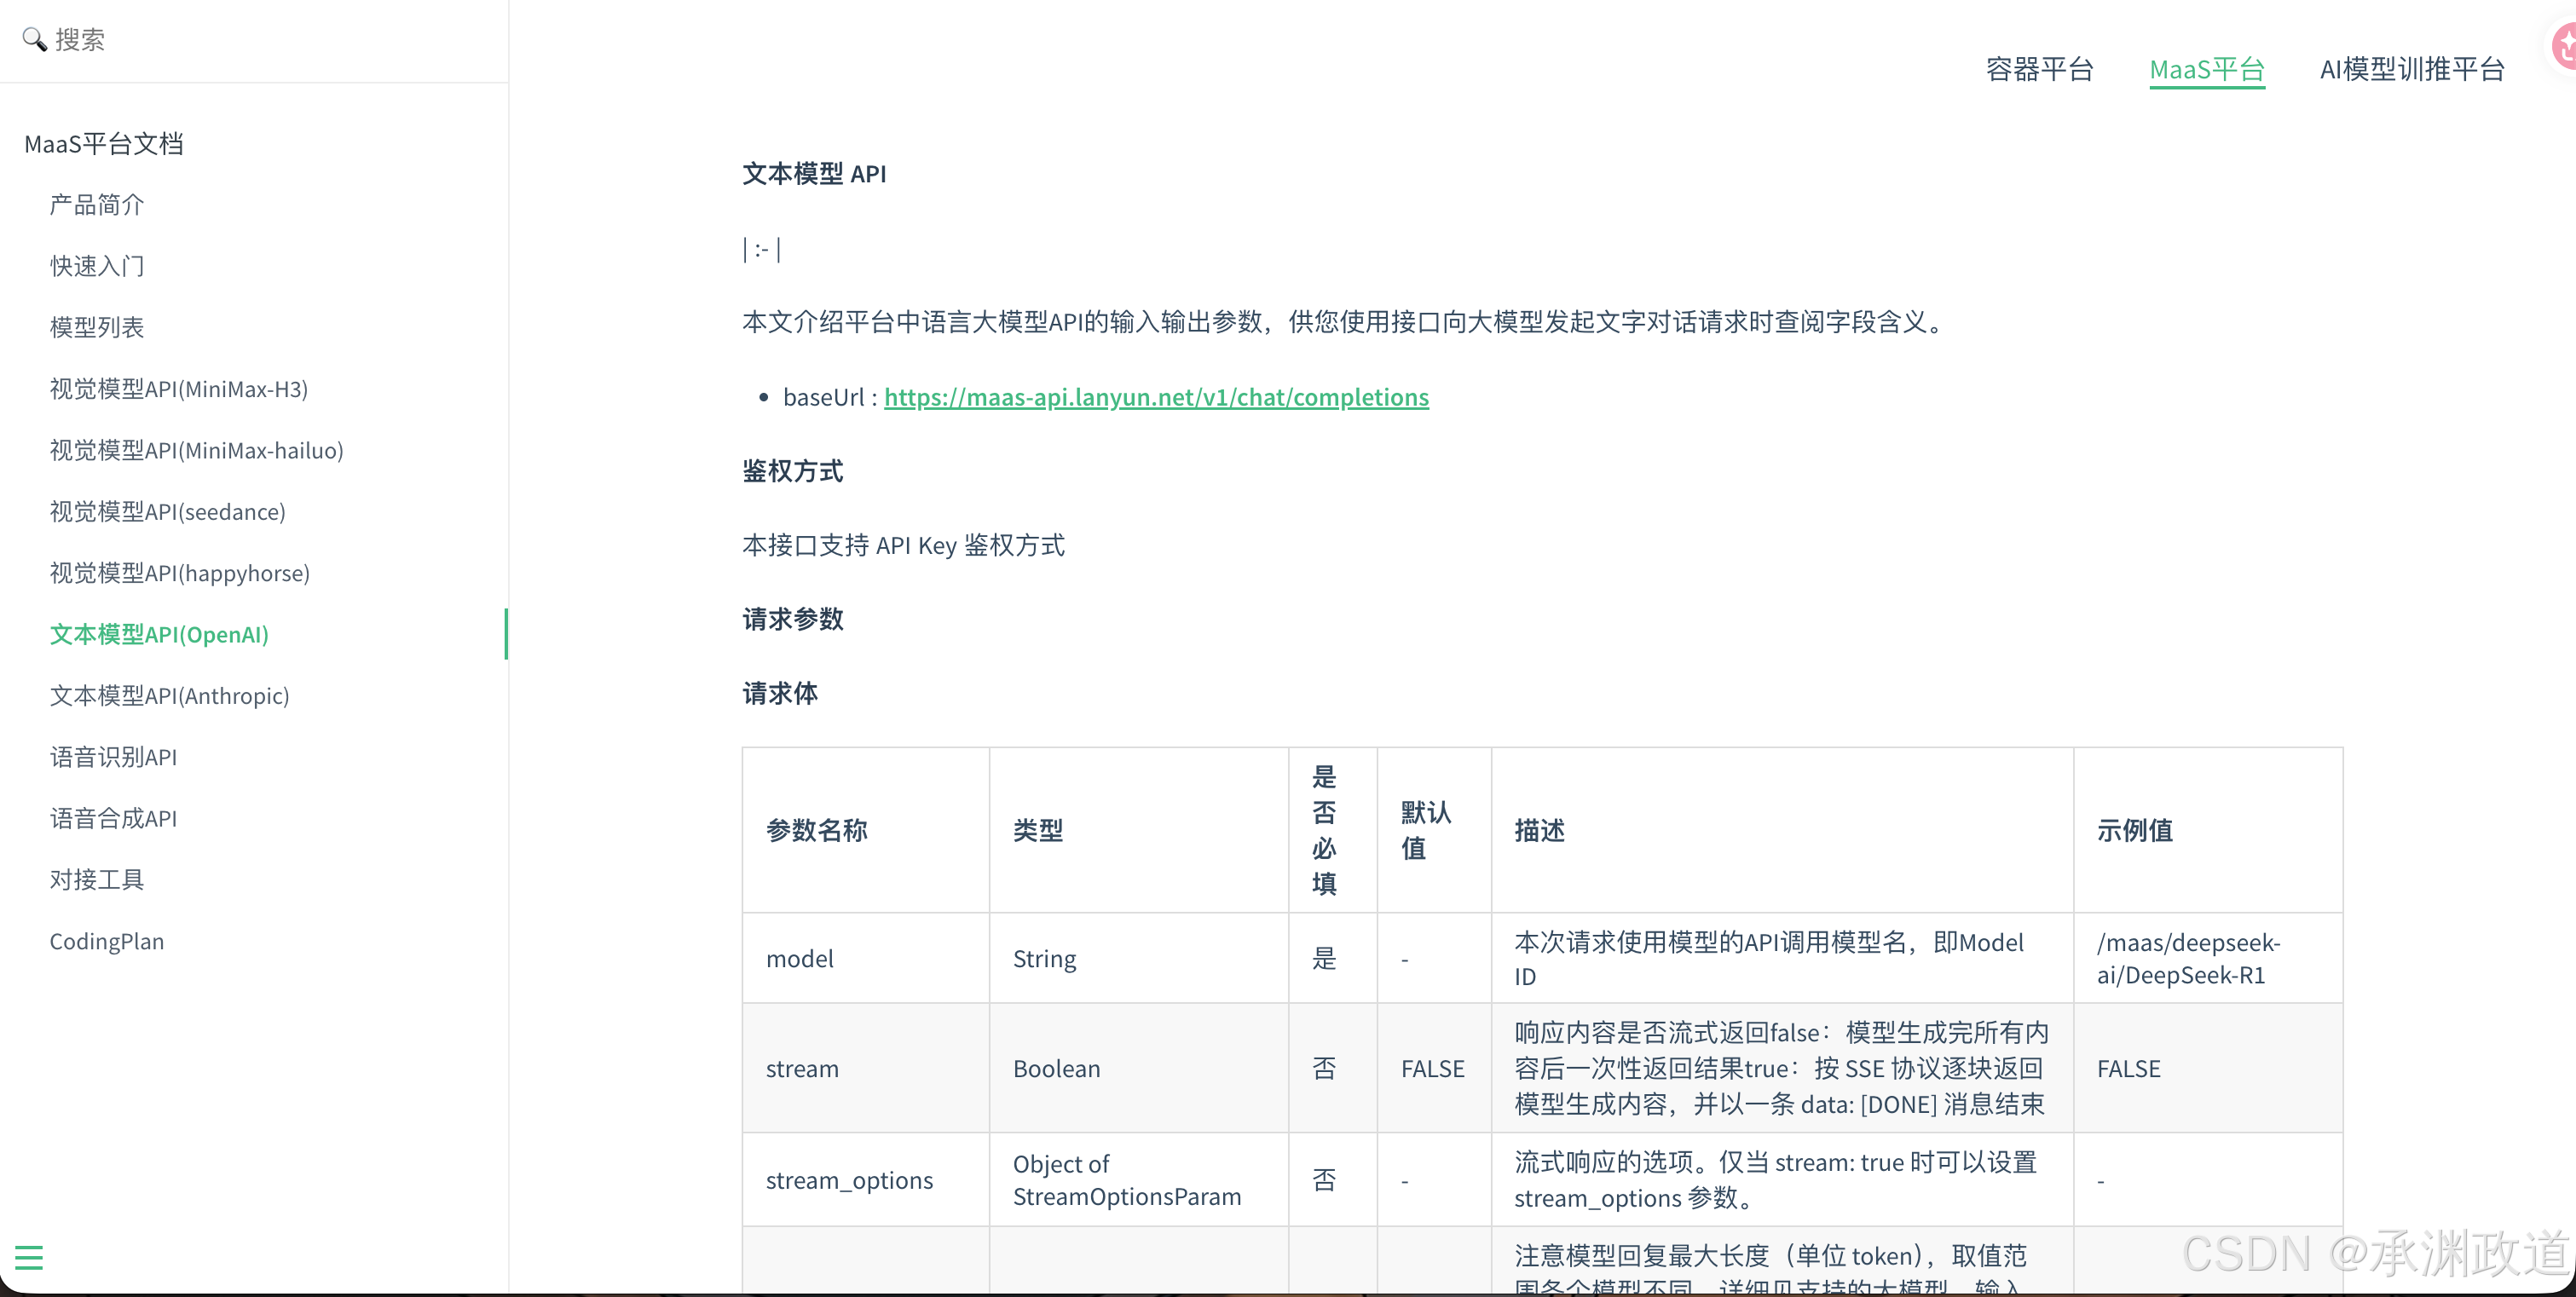
这里有个适合开发者顺手记住的区别:完整请求地址和某些 SDK 要求的基础地址不是同一个概念。 本文下面展示的是 WorkBuddy 界面中的实际填写方式,不要不加区分地复制到所有客户端的 base_url 字段.
4.在WorkBuddy中接入蓝耘模型
在 WorkBuddy 的模型选择菜单中进入“配置自定义模型”,也可以从“设置 → 模型”进入添加界面.本次填写如下:
| 配置项 | 本次设置 |
|---|---|
| 供应商 | 自定义 |
| 接口地址 | https://maas-api.lanyun.net/v1/chat/completions |
| API Key | 在本机填写蓝耘创建的 Key |
| 模型名称 | 截图中填写为 GLM-5.3-Flash |
| 工具调用 | 勾选 |
| 图片输入 | 未勾选 |
| 思考模式 | 未勾选 |
| 自定义协议 | 未勾选 |
| 输入、输出限制 | 使用提供商默认值 |
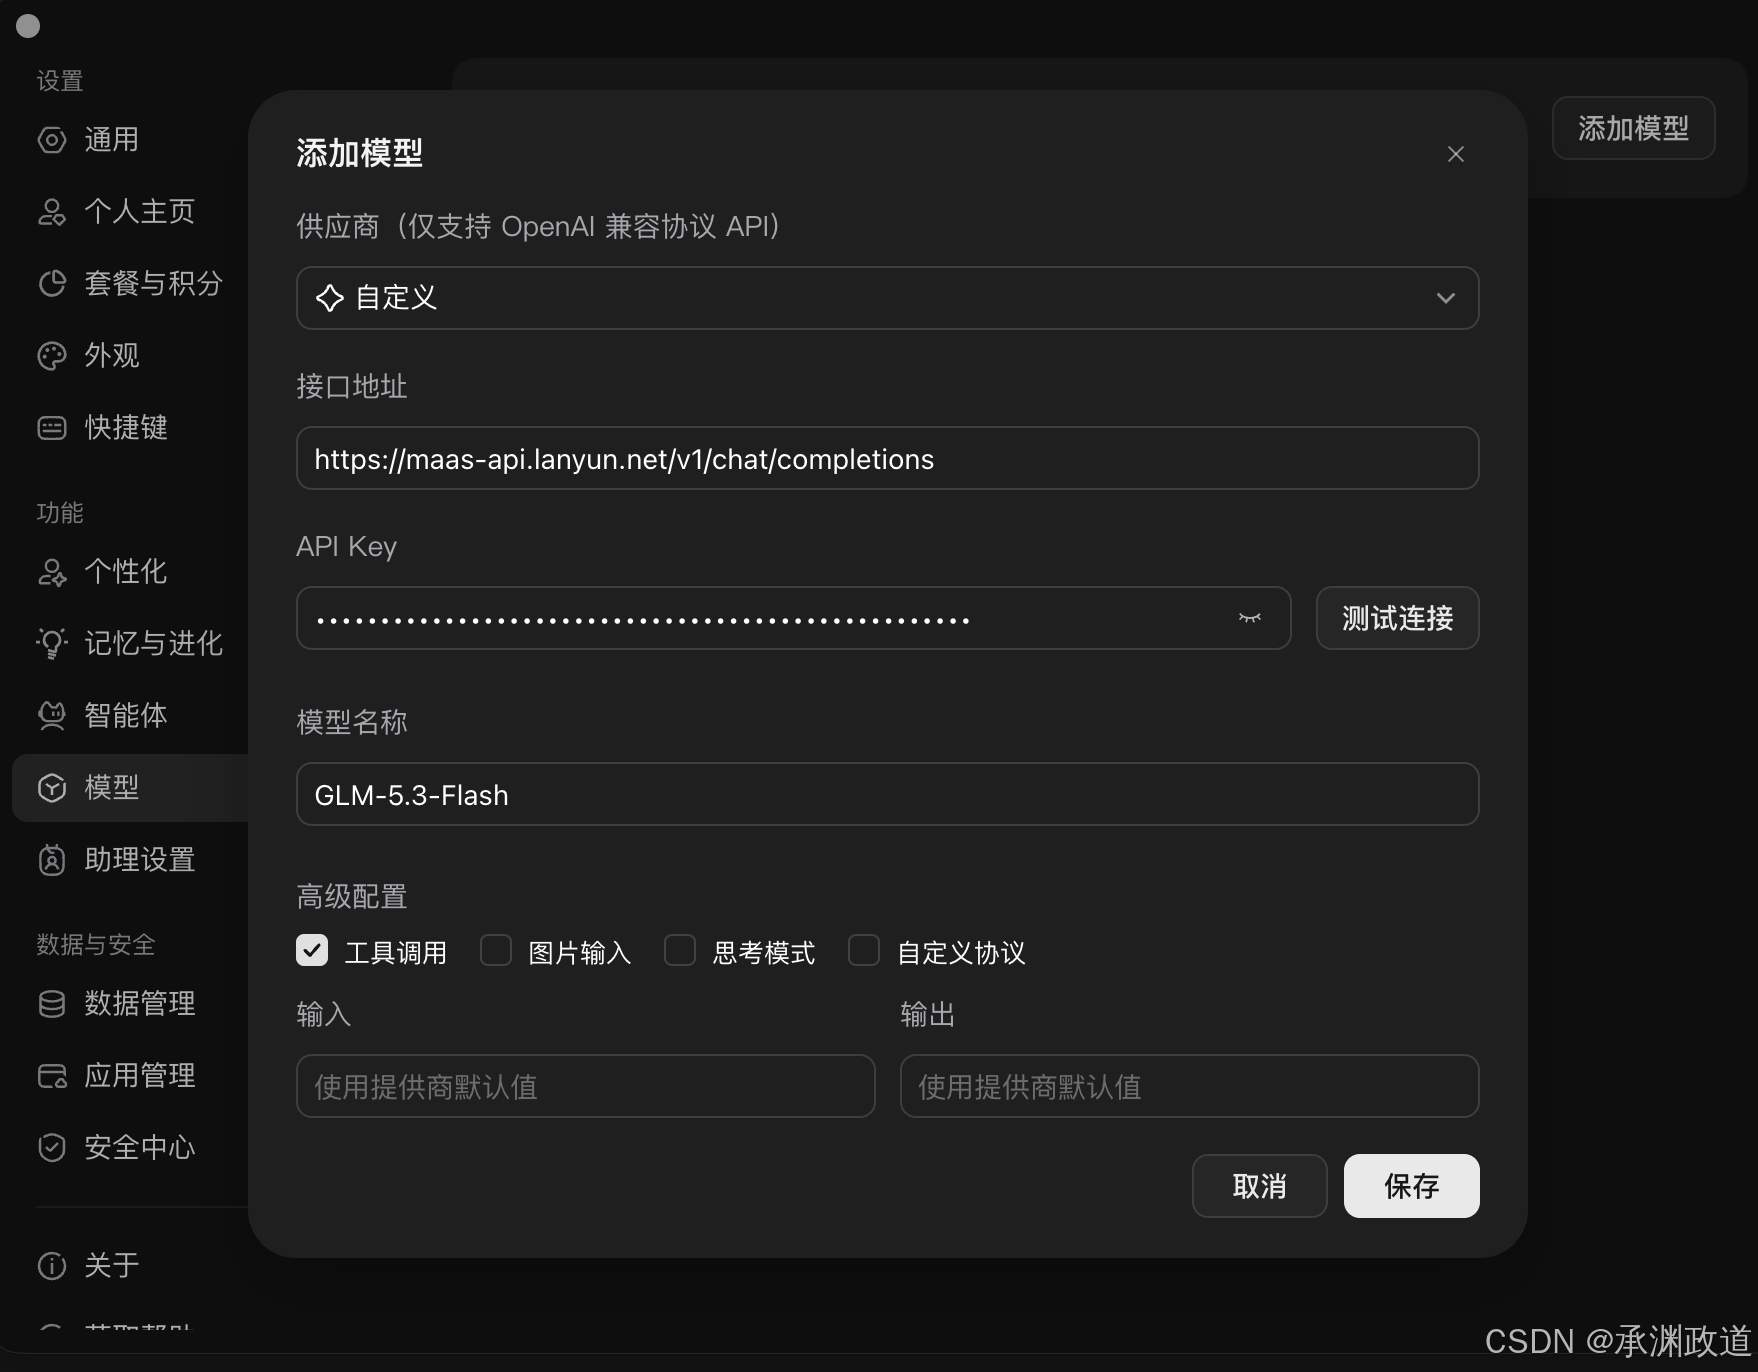
保存后,在任务输入框中选择刚配置的模型,再进行后续操作.WorkBuddy官方文档也说明,自定义模型可以通过界面配置 URL、API Key 和模型名称.
有两个细节值得保留:
第一,截图中的 WorkBuddy 配置名称写作 GLM-5.3-Flash,蓝耘统计页显示为 glm-5.3-flash.本文保留两处界面的实际写法,不能由此推断所有接口都忽略大小写.自己编写API请求时,优先复制蓝耘对应模型的API 示例中的准确模型ID.
第二,本次没有开启“图片输入”.论文里的图片是通过文档解析和后续文件整理导出的,这与“把图片直接交给视觉模型理解”是两件事.看到图片文件生成,并不能据此认定已经验证了模型的视觉能力.
5.启用xParse,先把论文解析出来
打开 WorkBuddy 的连接器列表,确认 TextIn xParse·智能文档解析 已启用.
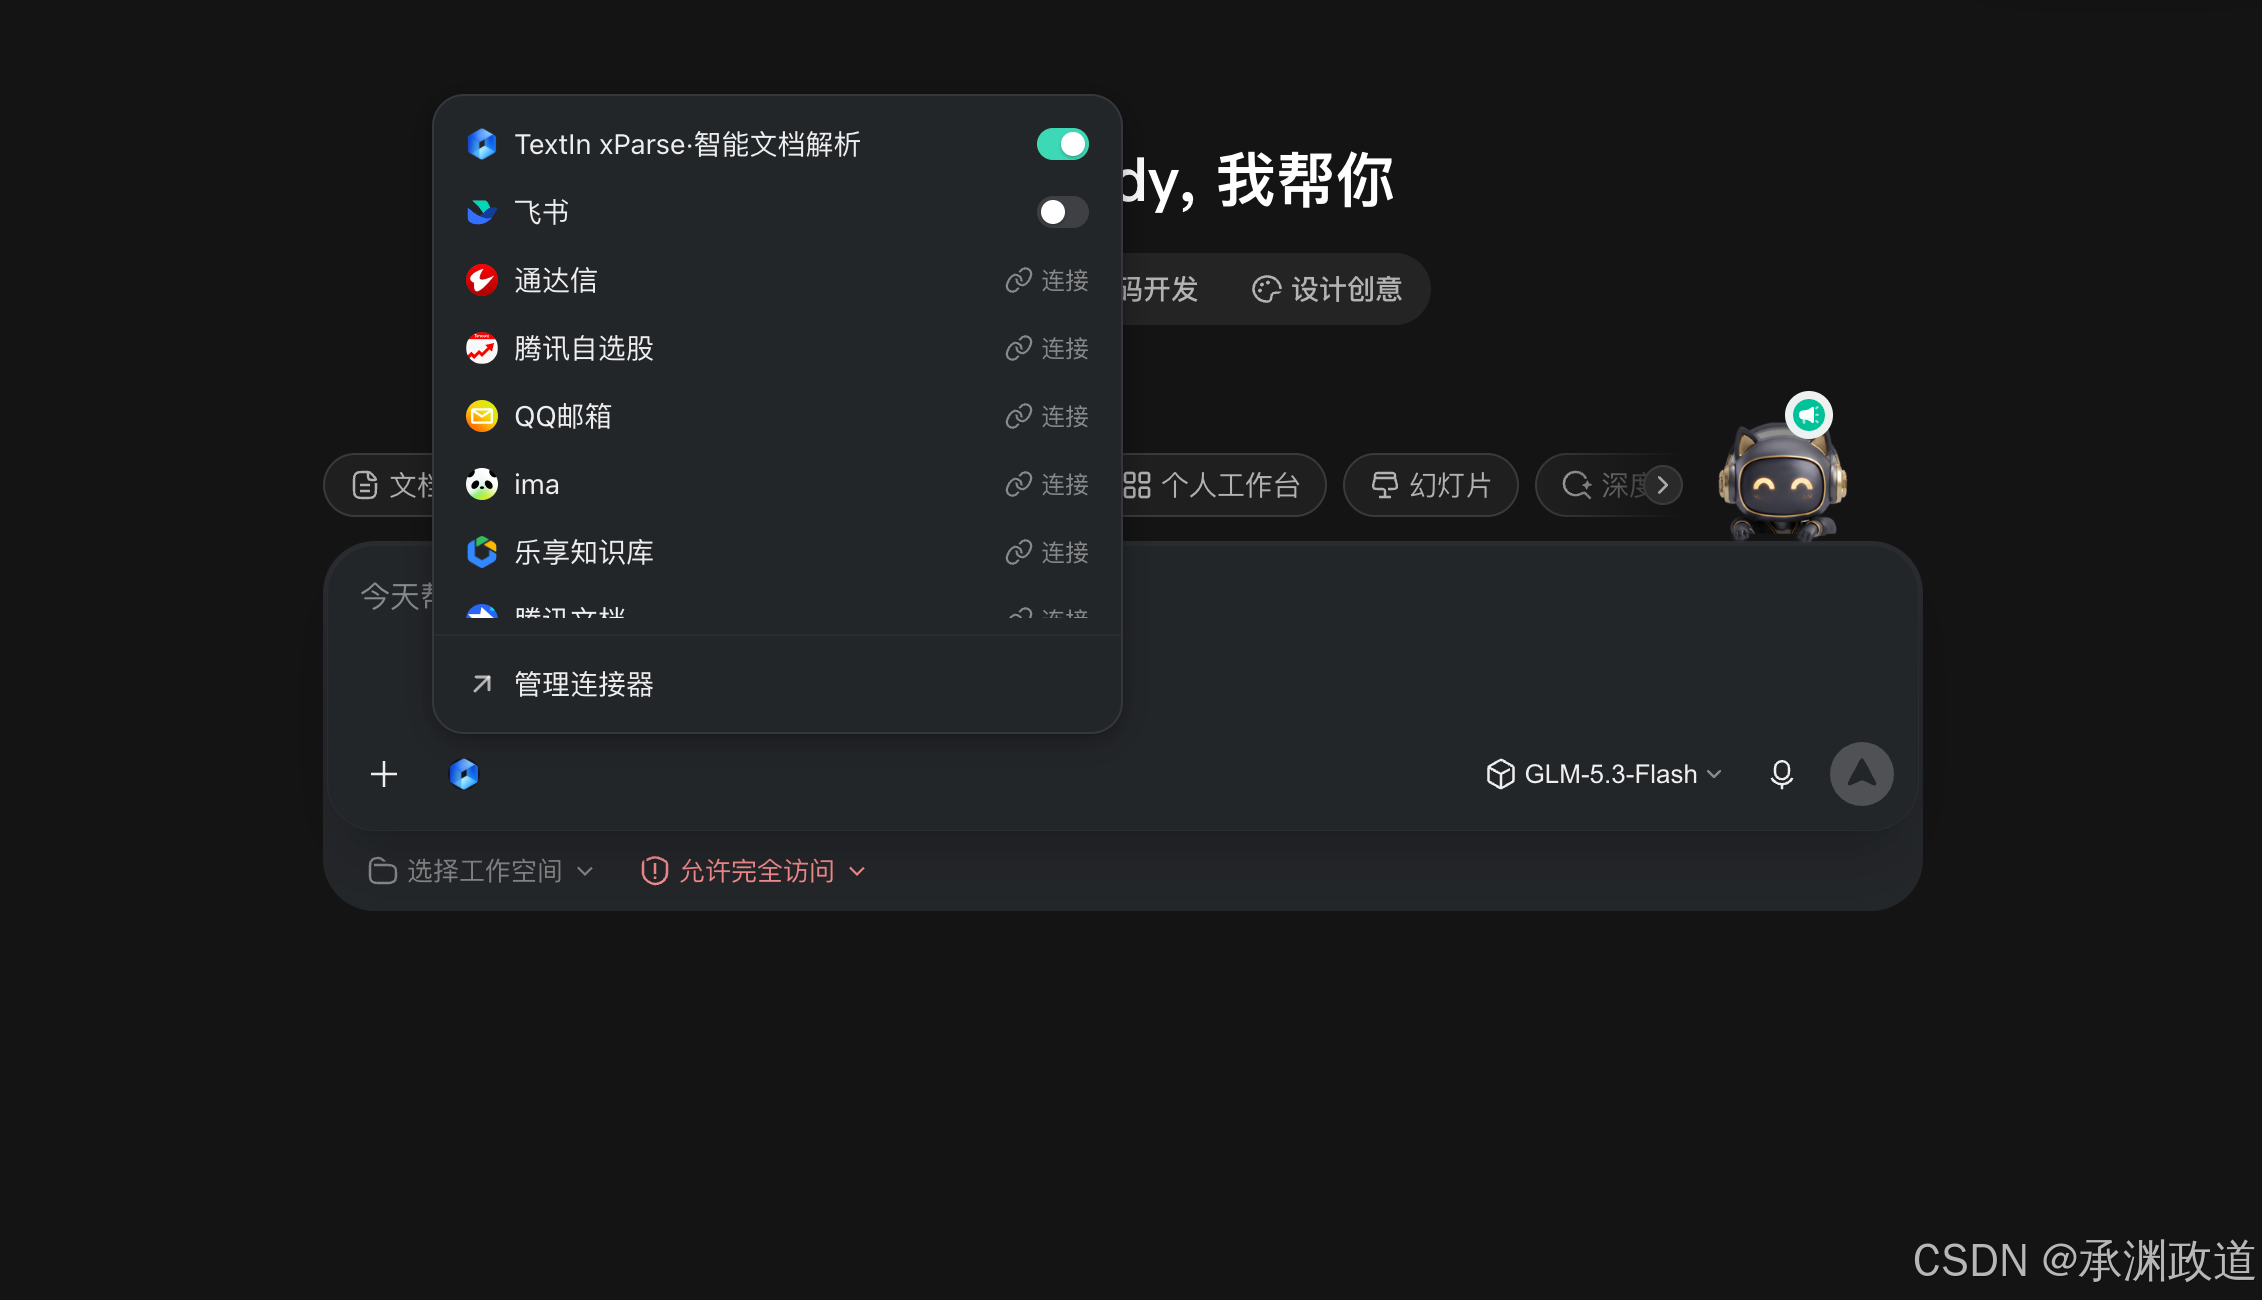
我的截图记录的是连接器已经可用的状态,没有记录首次开通或授权过程.复现时,如果你的账号尚未连接该服务,需要先根据客户端提示完成设置.
随后上传 26国赛C题.docx,选择刚才配置的模型,发送第一条指令:
1请调用TextIn xParse·智能文档解析连接器,帮我解析26国赛C题这篇论文
2
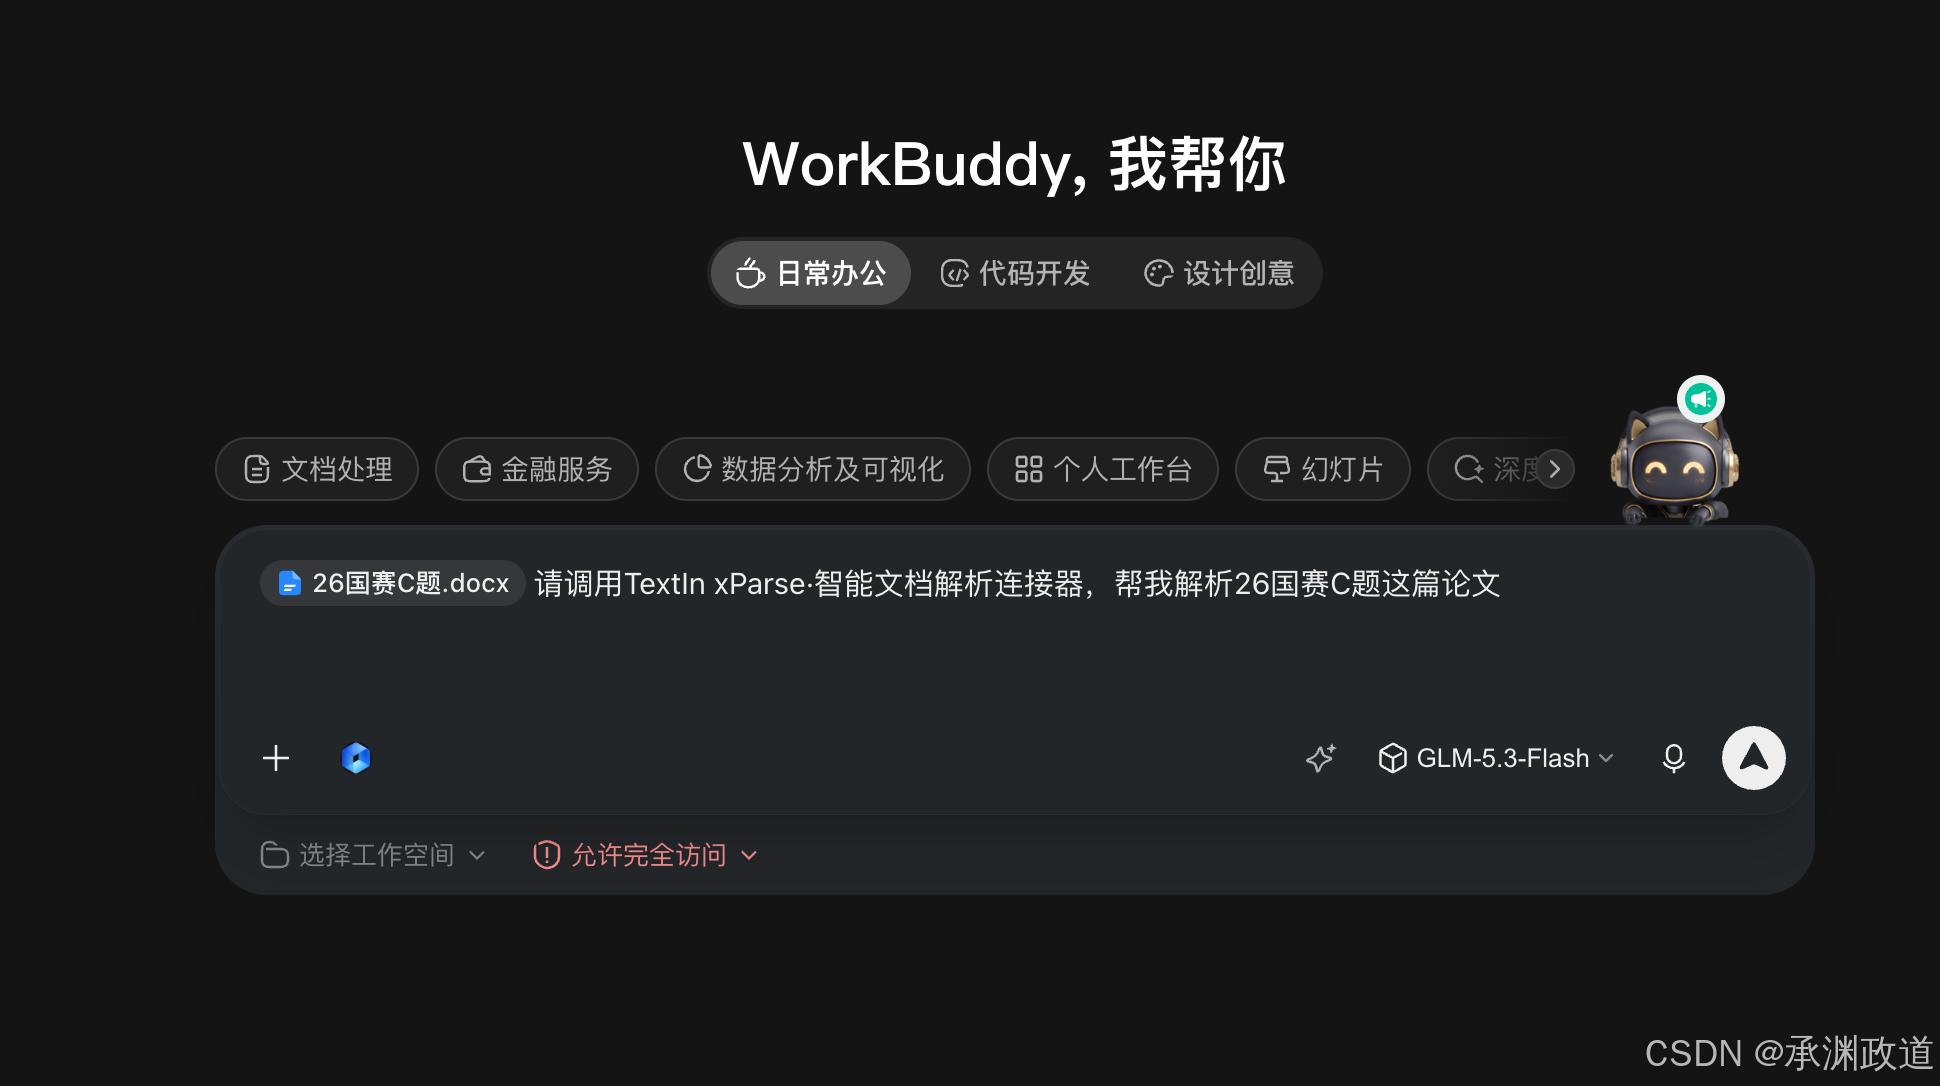
这条指令没有复杂的提示词技巧,只明确了输入文件和要使用的工具.对于学生读者,先完成这一步,就能判断整个组合是否真正跑通.
第一轮完成后,WorkBuddy 给出了论文内容概览,并生成了 26国赛C题.md.界面显示本轮任务用时 2 分 35 秒,附件显示大小为 96.1 KB.
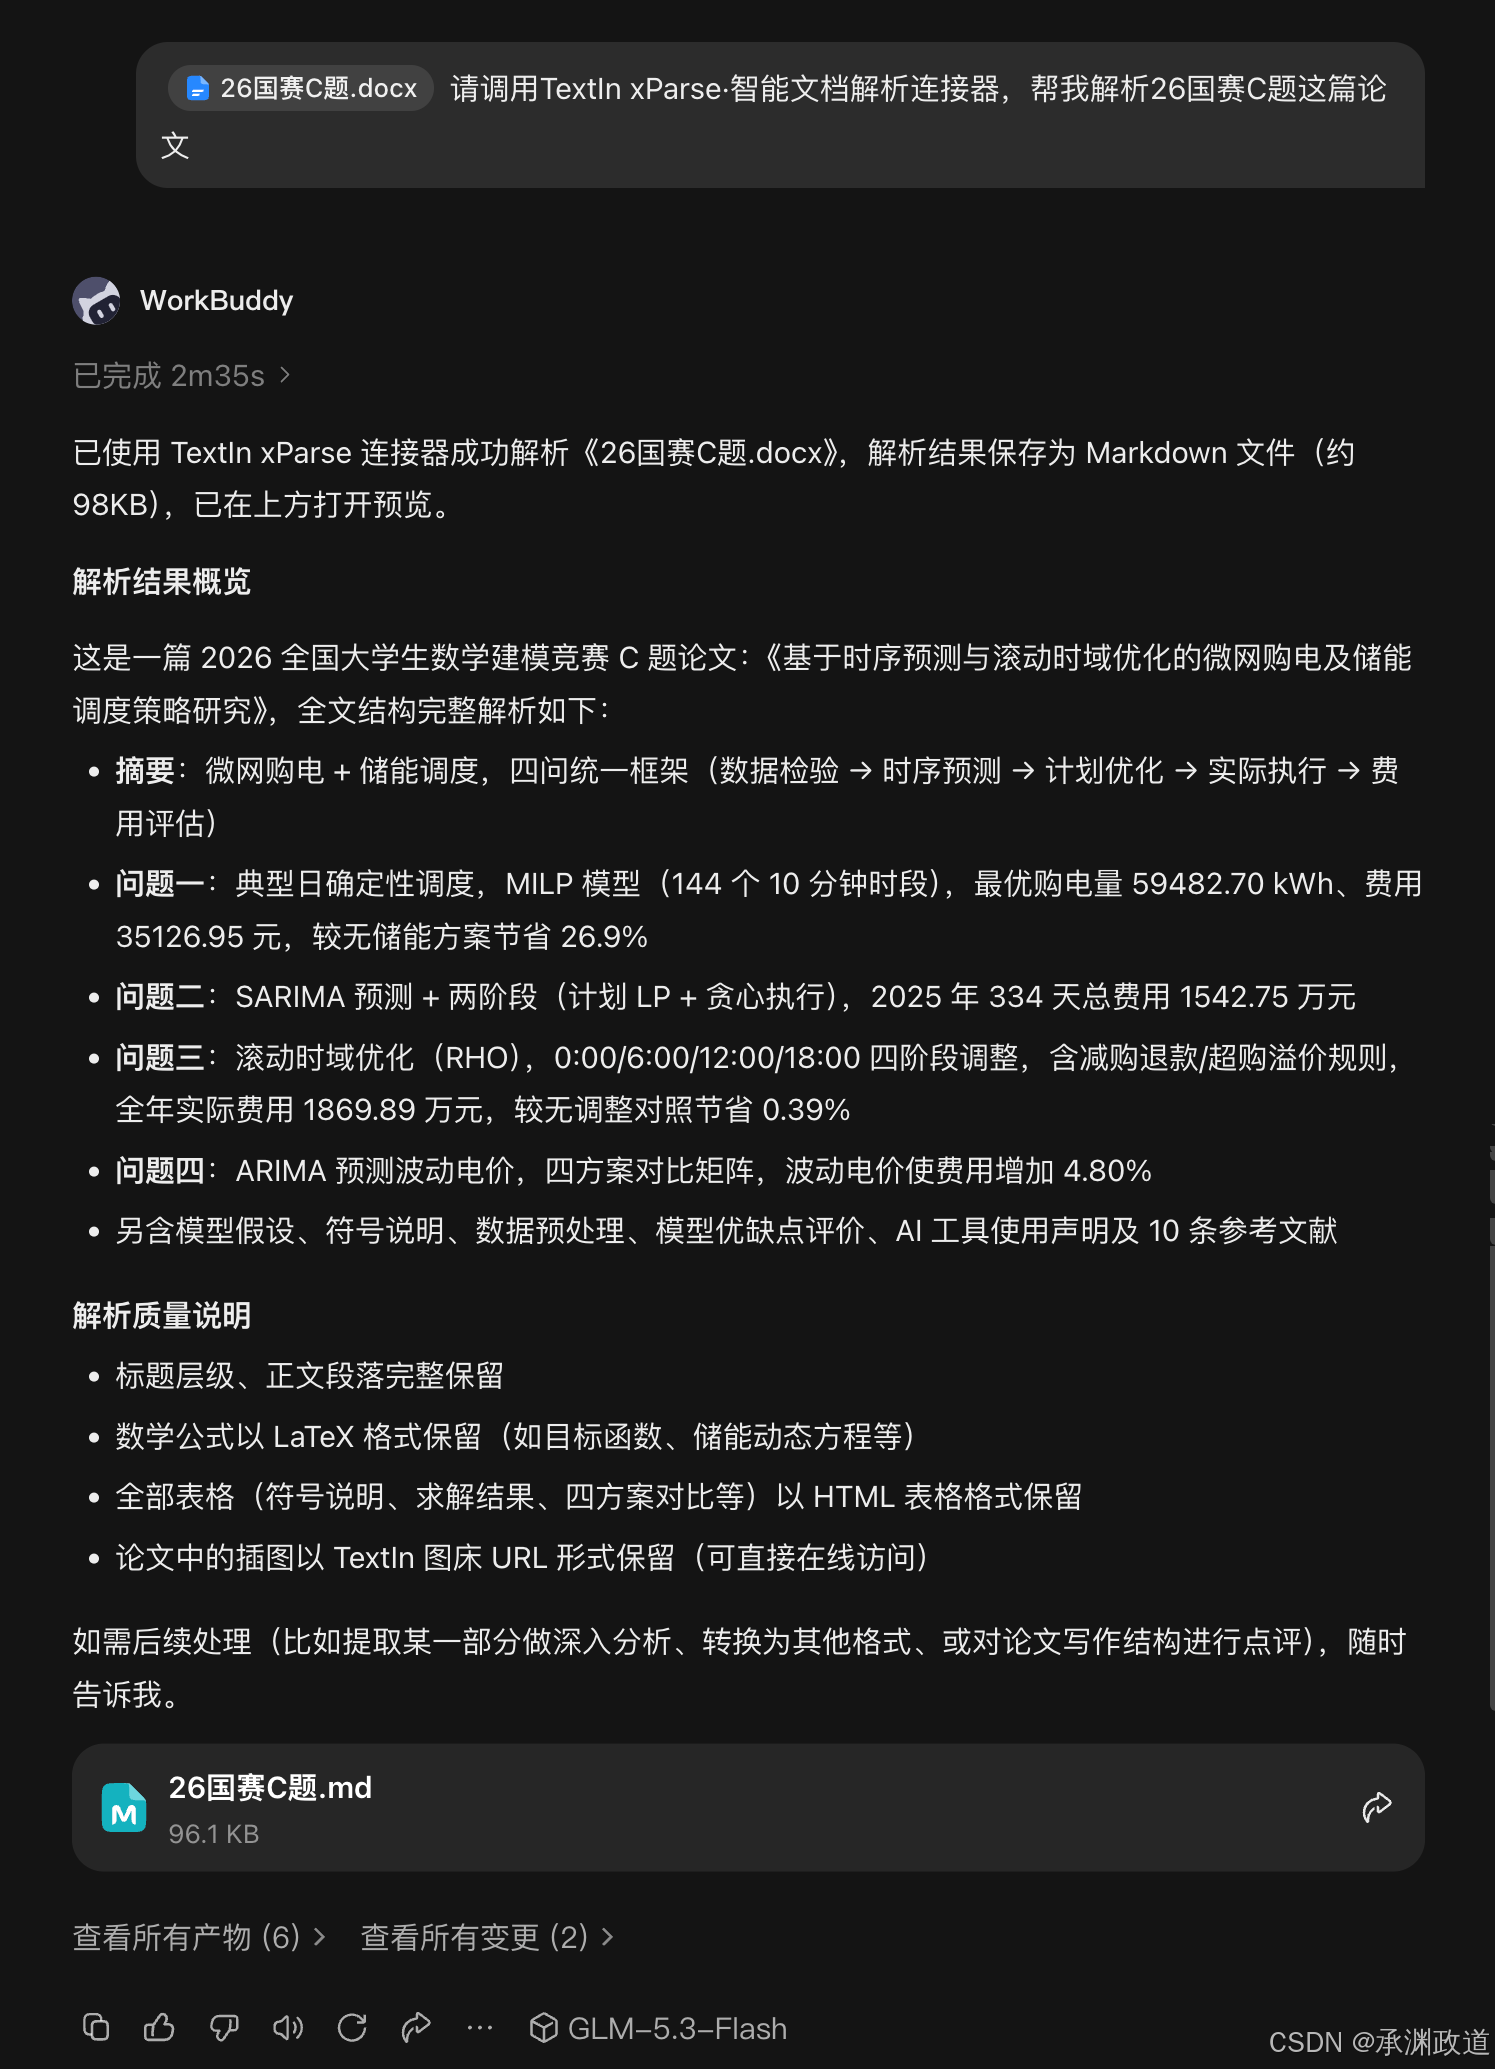
这里的2分35秒是WorkBuddy显示的本轮任务时间,包含这一轮工作流的处理过程,不是蓝耘模型的纯推理耗时,也不是 xParse 的独立性能测试结果.
6.实际需求:全文能读了,表格、公式和图片怎么单独拿出来
本次没有遇到鉴权报错、连接中断之类的问题.但第一轮得到全文Markdown后,我还有一个没有完成的实际需求:学习论文时,想单独查看和复用其中的表格结构、公式源码与图表,而不只是从头到尾读一份长文档。
所以我继续补了一条指令:
1我还需要json、表格、公式、图片
2
第二轮界面显示任务用时 7 分 12 秒,产物被整理到 xparse_output/ 目录中.它与第一轮是前后衔接的追加需求,不是一次报错后的重试.
按截图中的交付内容,目录可以简化理解为:
1xparse_output/
2├── 26国赛C题.json
3├── 26国赛C题_本地化.md
4├── tables/      # 表格 Markdown、CSV 与汇总
5├── formulas/    # 公式汇总与 LaTeX 文件
6└── images/      # 导出图片与图片清单
7
上面只保留主要结构,便于理解各类文件的用途.
6.1表格:从整篇阅读转向逐项对照
表格汇总页列出了标题、页码、行列数和对应文件名.截图中可以看到“主要符号说明”“求解器主要参数设置”“问题一关键求解指标汇总”等条目.
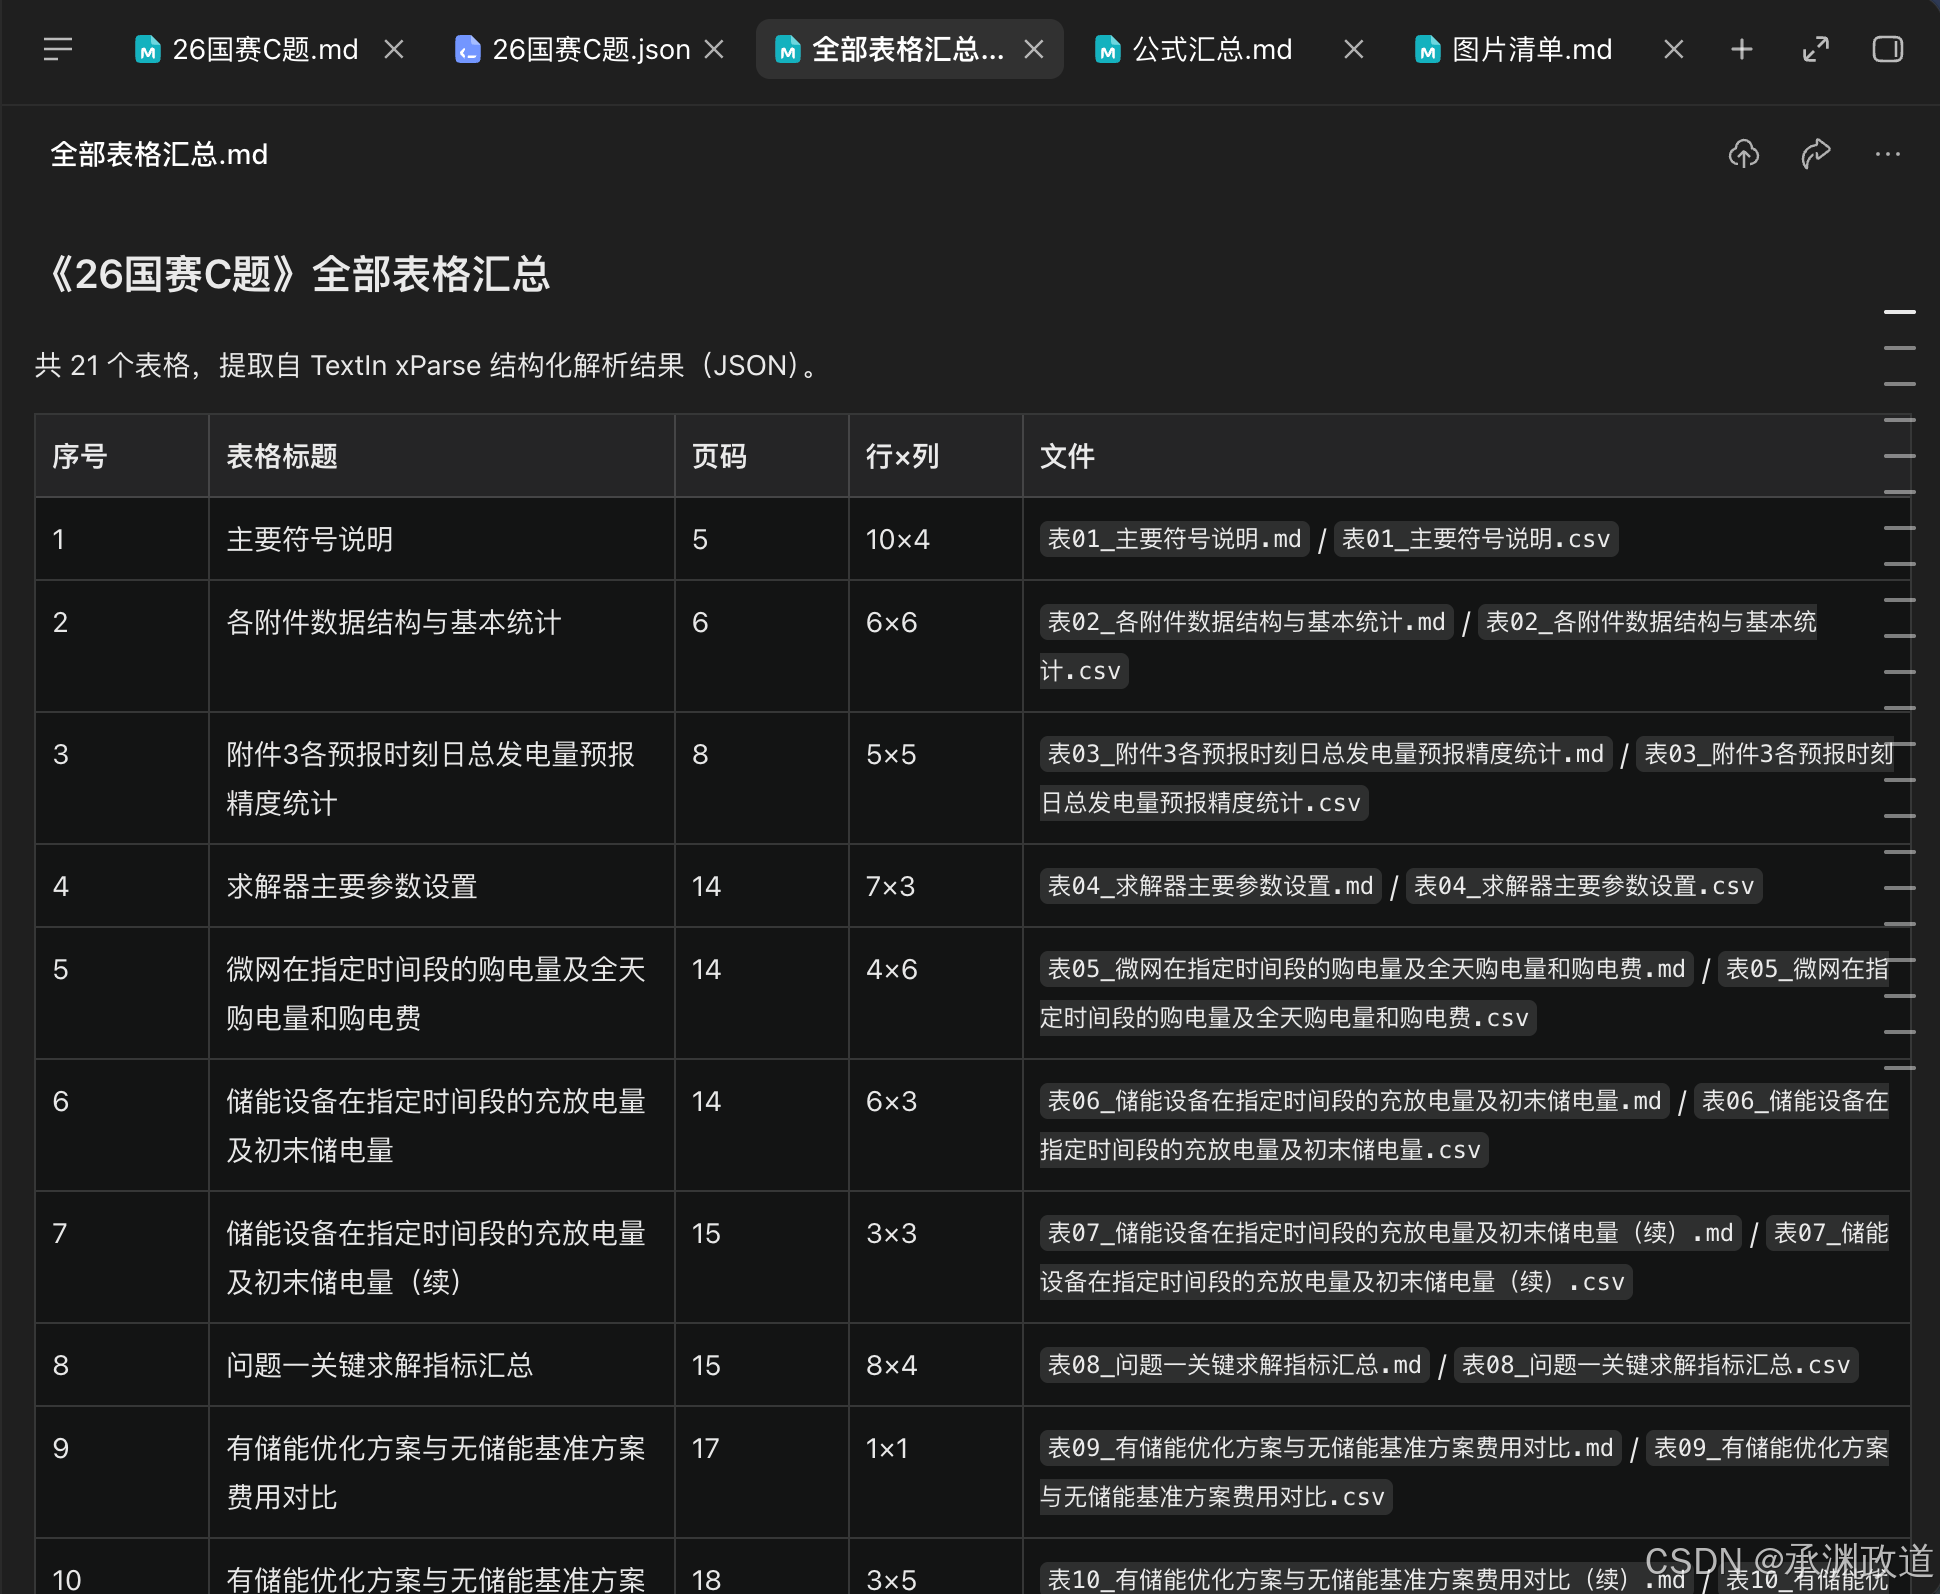
这类清单比简单的论文摘要更适合做对照学习.比如复盘自己的论文时,可以检查是否交代了求解器参数,结果有没有单位,是否给出了基准方案.
导出CSV后,还可以把表格作为后续整理的输入.不过,学习他人的结果呈现方式,不等于可以把他人的数值当成自己的实验结果.我的用途是参考结构、理解表达,再用自己的数据重新计算和制表.
清单也保留了需要人工判断的地方:有些条目带“续”,有的行列数较特殊.这意味着跨页表格是否需要合并、标题是否对应准确,仍应对照原文检查,不能只看“生成了多少个文件”.
6.2公式:源码可复制,预览还没有处理好
公式汇总页记录了 34 个独立公式,并列出编号、页码和 LaTeX 源码.
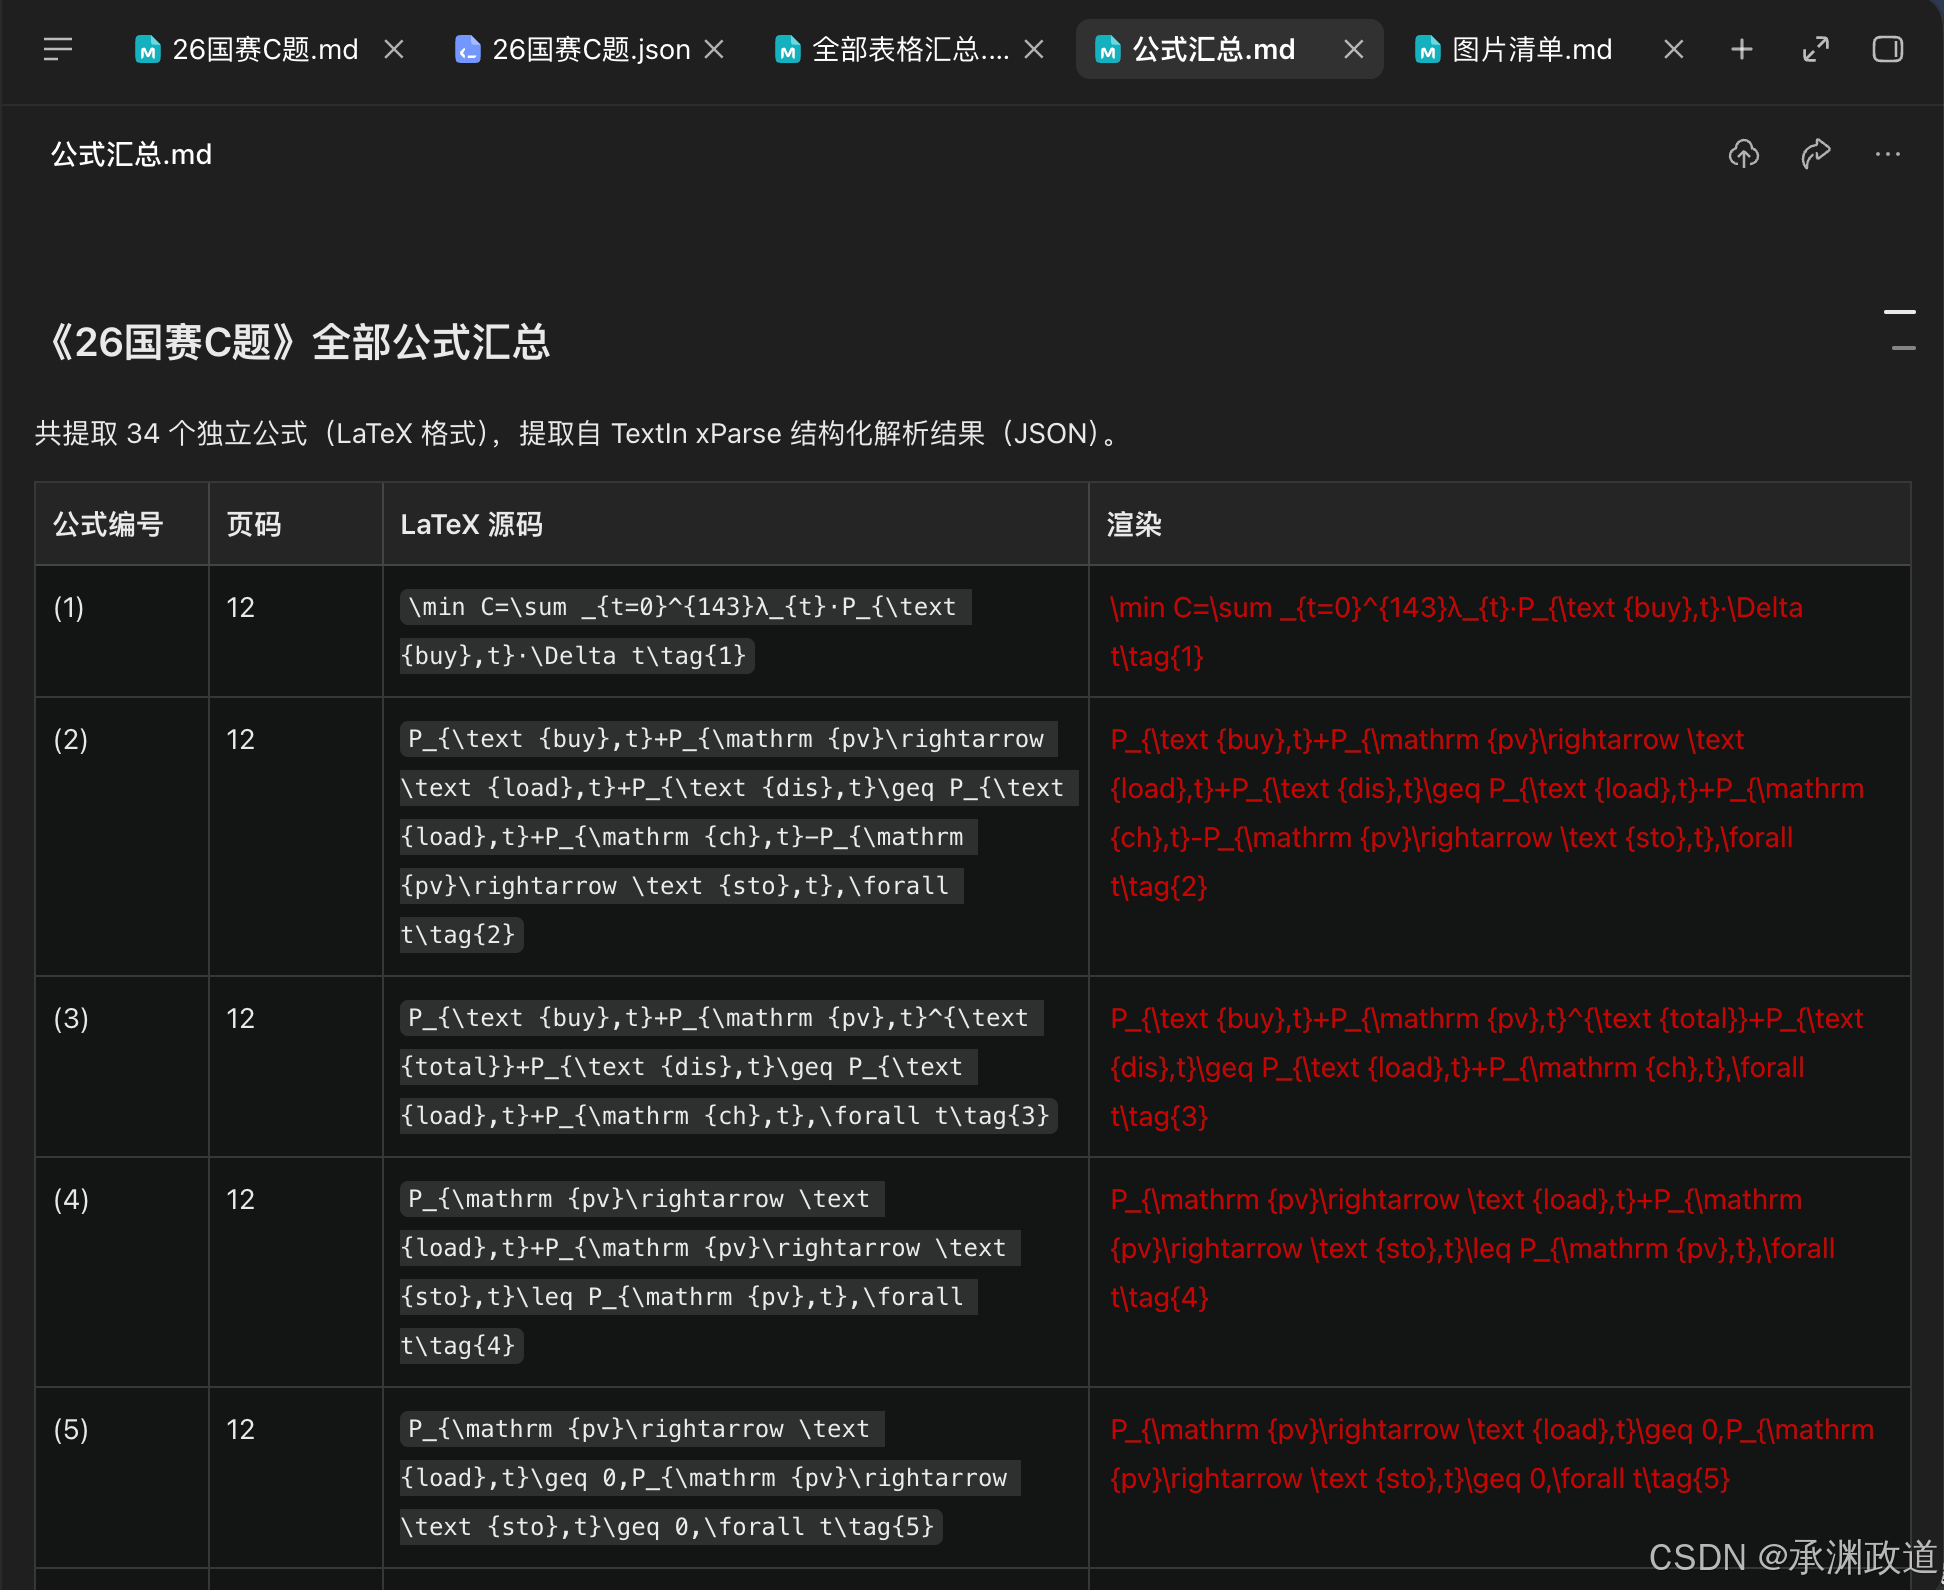
这一部分我确认了源码可以提取、复制,但没有继续处理预览效果.截图右侧仍显示红色源码,说明至少在该次预览中,公式没有正常显示为数学排版.
因此,本次能确认的是“拿到了可供后续检查和使用的公式源码”,不能写成“公式全部完美还原”或“生成的 LaTeX 已通过编译”.虽然产物清单列出了.tex 文件,我没有验证其编译结果.
截图不足以判断显示问题究竟来自渲染器支持、公式所处的表格环境,还是源码本身.后续若要将公式写入自己的文档,应先核对符号、上下标和编号,再在实际使用的编辑器中验证显示效果.
6.3图片:保留索引,也看见索引的不足
图片清单展示了导出的图片及其页码,方便从素材回到论文上下文.
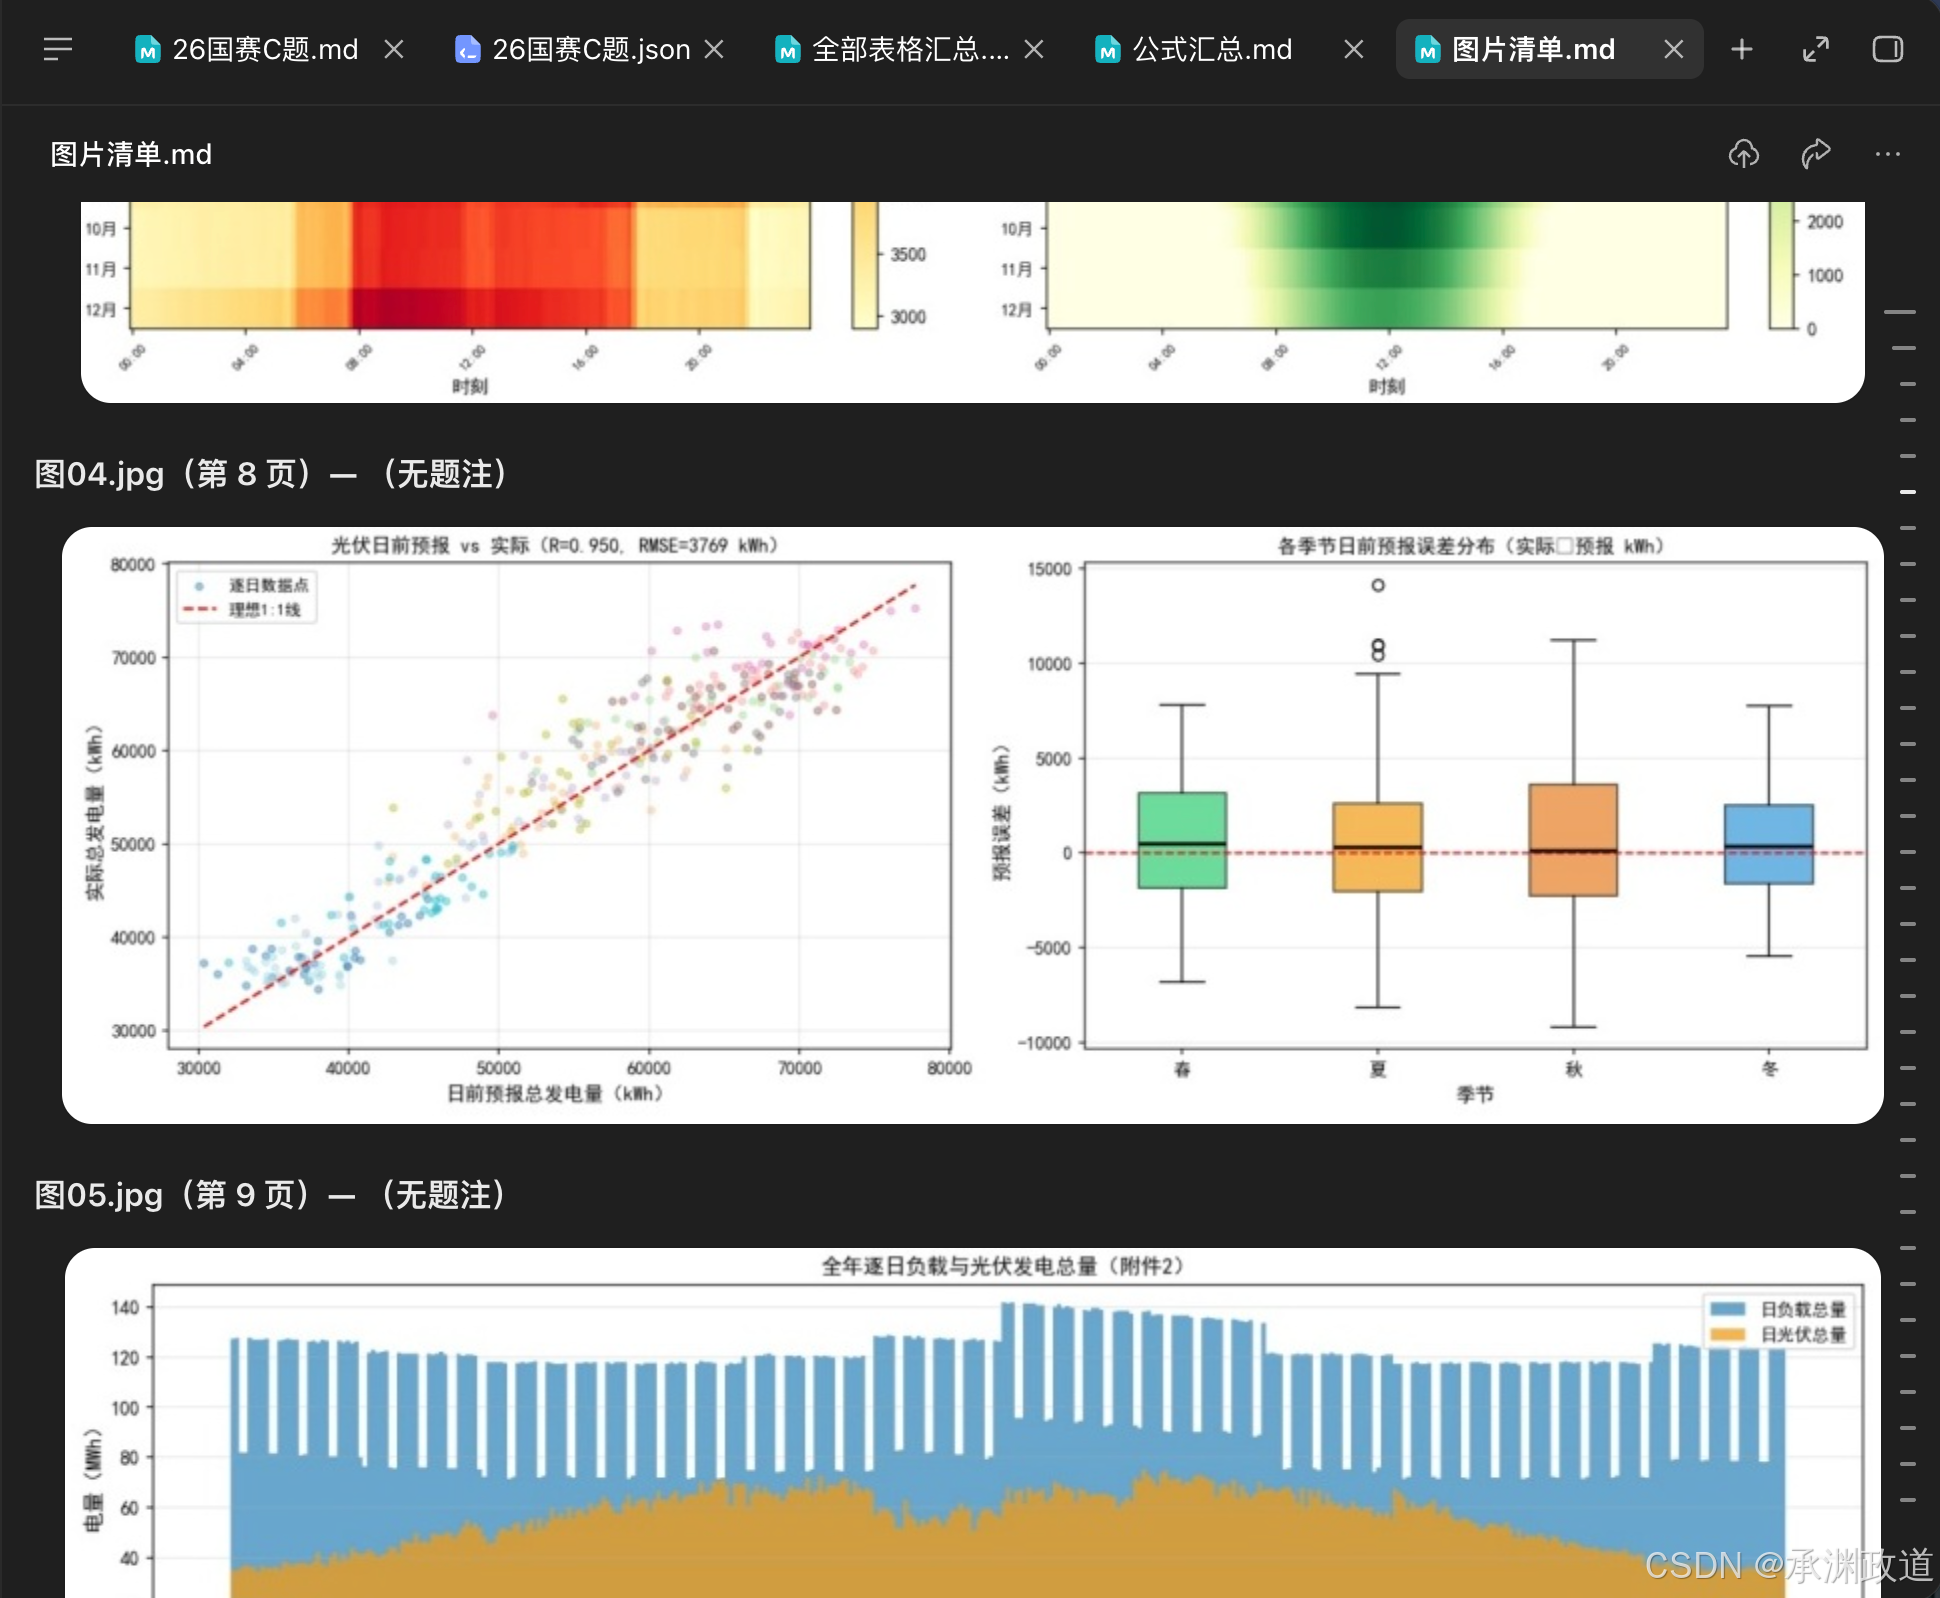
截图中部分图片标注为“无题注”.这不妨碍查看图片,但意味着清单并没有自动补齐所有图题关系,学习时仍要回到原文核对.
本次还生成了图片本地化的 Markdown 版本,方便把正文和图片放在一起保存.后续可以用这些图表研究配色、坐标轴、图例和组合图的组织方式,再用自己的实验数据绘图.
6.4JSON:给后续程序处理留一个入口
如果只想阅读,Markdown 已经够用;如果想继续写脚本,JSON 更适合保留结构化信息.
本次JSON截图中可以看到文件元数据、页数以及全文 Markdown 字段.对于开发者,可以在检查实际字段结构后,继续实现按页码建立索引、分类导出元素或关联原文位置.本文没有实际搭建检索系统,也不把这些后续用途写成已完成的功能.
7.蓝耘用量记录:33次调用,平台显示消费0.32元
任务结束后,我查看了蓝耘元生代的用量统计.截图筛选范围为最近3小时,这个范围内的记录全部来自本次论文解析及后续整理.
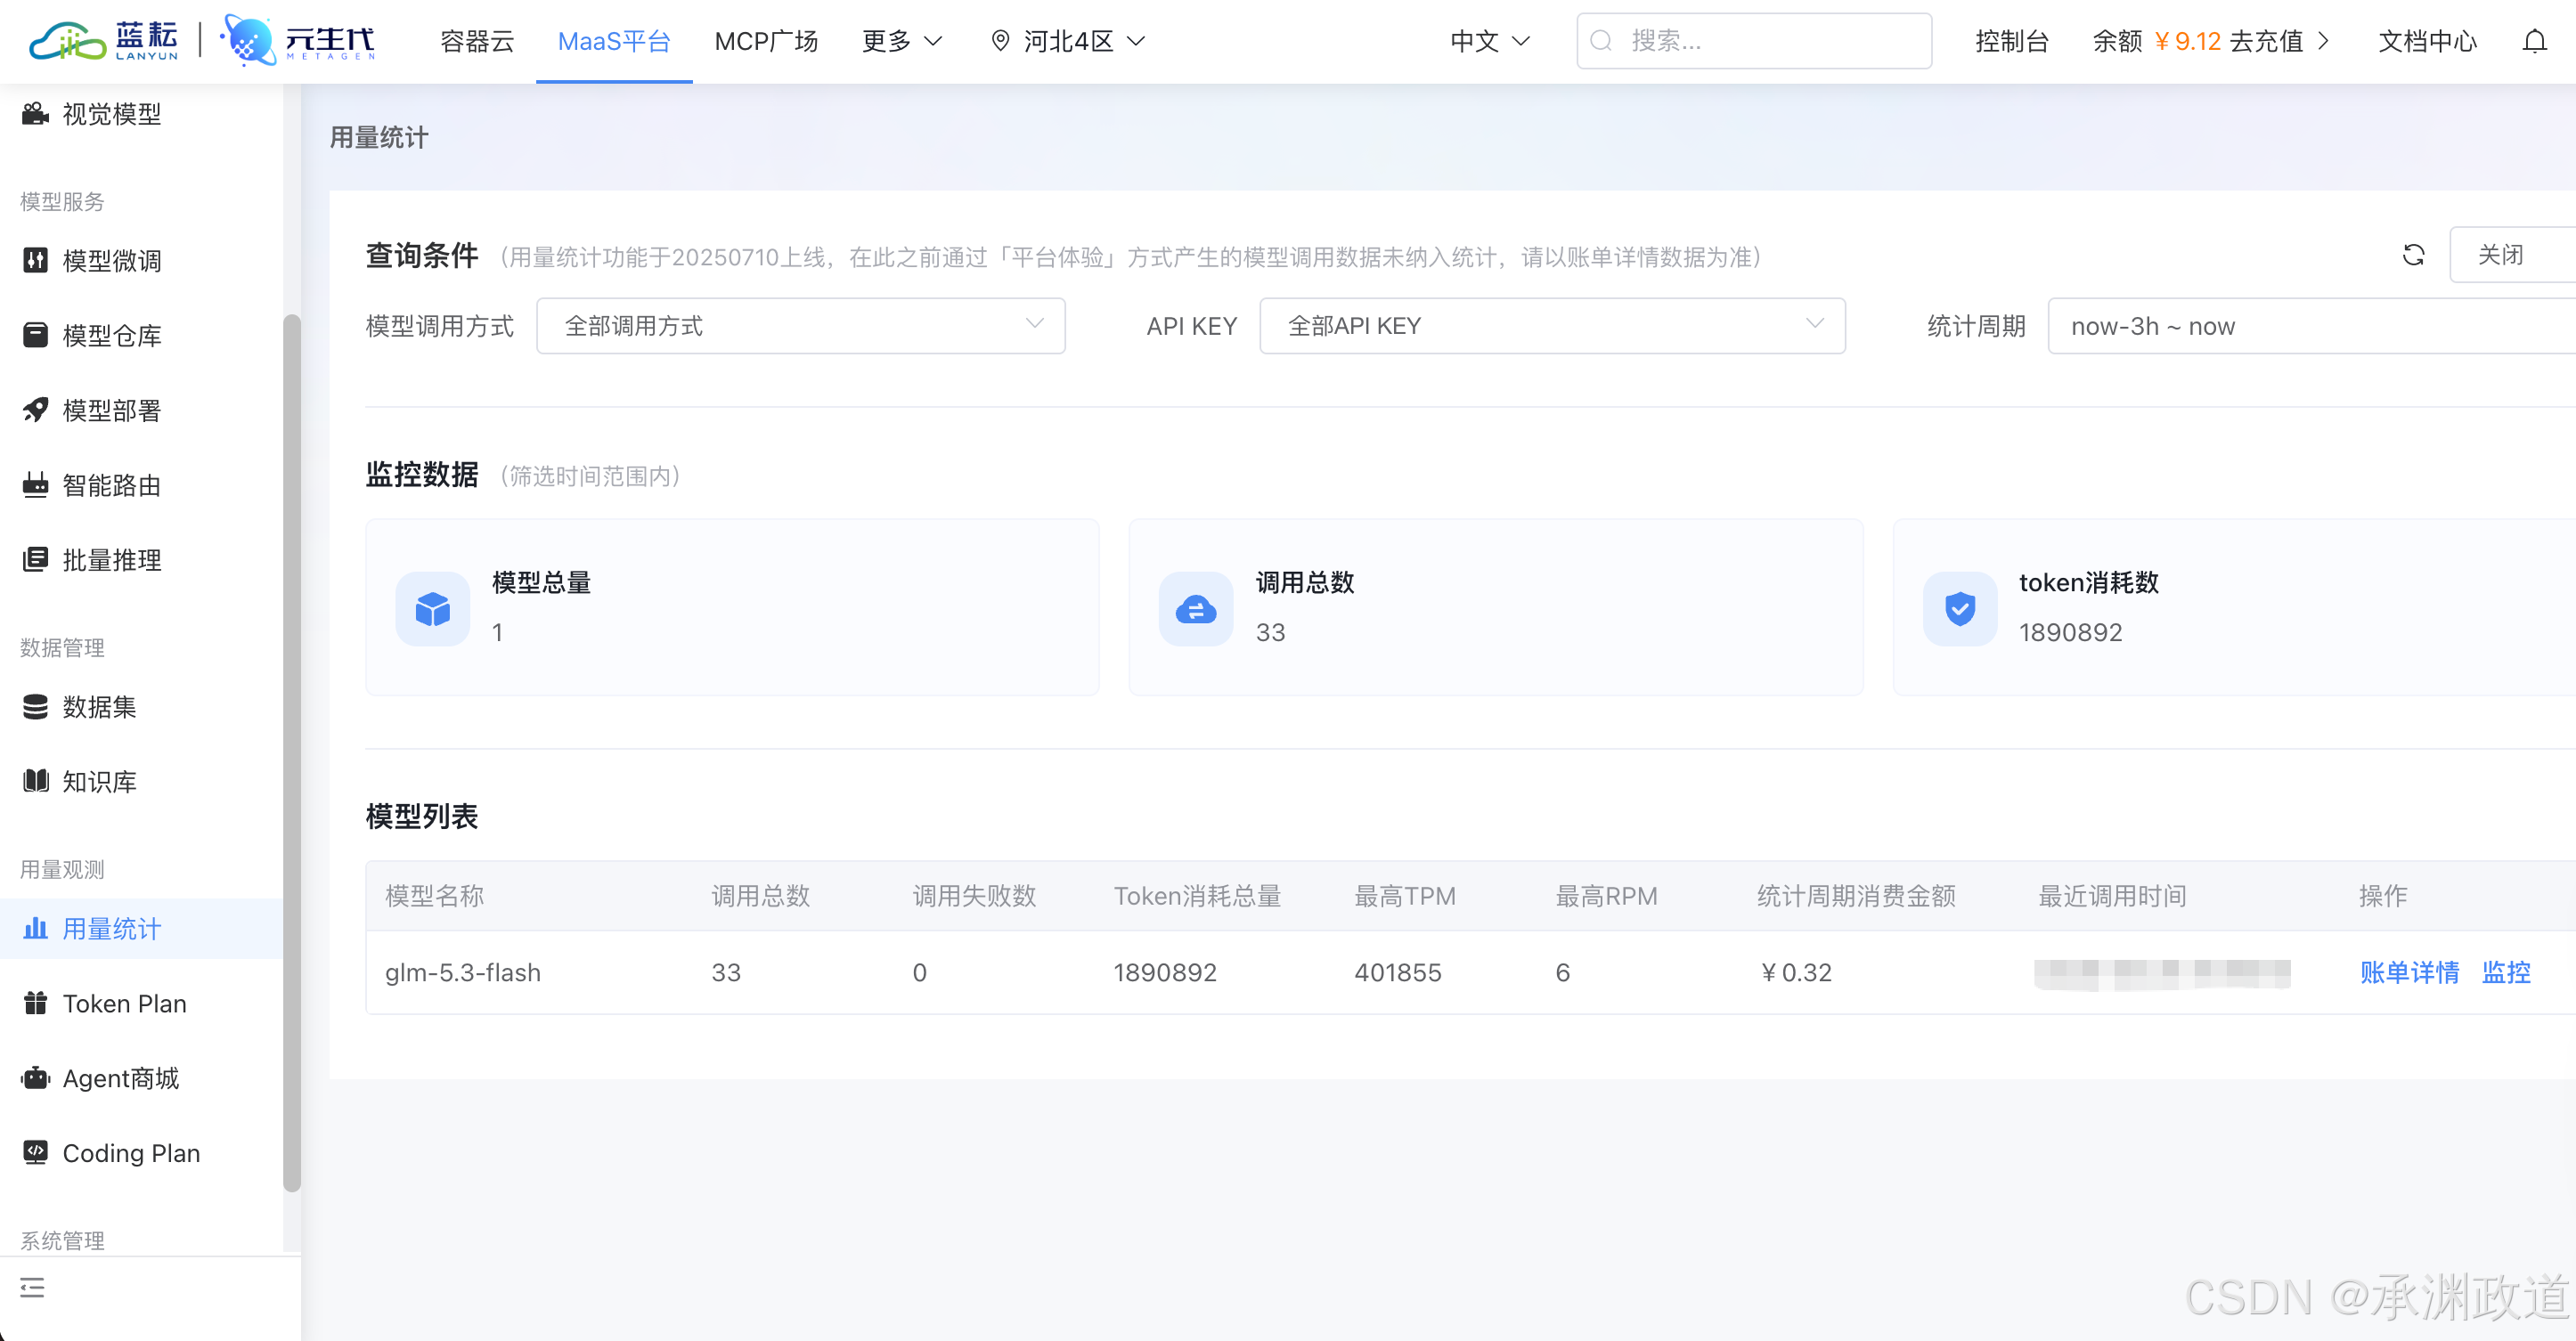
| 统计项 | 平台显示值 |
|---|---|
| 模型 | glm-5.3-flash |
| 调用总数 | 33 |
| 调用失败数 | 0 |
| Token 消耗总量 | 1,890,892 |
| 最高 TPM | 401,855 |
| 最高 RPM | 6 |
| 统计周期消费金额 | ¥0.32 |
这组记录让我能把“任务生成了文件”和“蓝耘确实产生了模型调用”对应起来.33次请求也说明,聊天里发送两轮指令,并不等于后台只请求两次模型.
费用这里必须说清楚三个范围:
- 0.32 元是蓝耘平台显示的本次模型调用费用。 它不代表已经核清了 WorkBuddy、TextIn 或其他服务的全部成本.
- 这不是所有 43 页论文的固定价格。 文档内容、追加指令和工作流执行过程不同,都可能改变调用量.
- 现有截图不足以逐项复算账单。 页面没有提供输入、输出、缓存命中等明细拆分,也没有完整计费调整信息;不能从总 token 数推断缓存命中率,或把费用差异归因于某项优惠.
同样,本次平台记录的 0 次调用失败,只能说明这个任务在所选统计范围内的情况,不能推广成长期可用率结论.
8.整理完之后,怎样用于自己的论文学习
这次实际完成的是文档解析和资料整理.至于把资料继续用于复盘,我更建议围绕具体问题阅读,而不是再让模型泛泛地“总结一下”.
下面这条是根据本次经验补充的学习指令示例,不属于截图中已经执行的两轮指令:
1请基于已解析的论文,制作一份建模学习对照表。
2
3按“研究问题—模型假设—目标函数—主要约束—求解方法—验证方式”组织。
4每项尽量注明原文章节或页码;找不到依据时标记“原文未明确说明”。
5区分原文明确写出的内容和你的解释,不补造实验过程。
6
7另外列出适合我复盘自己论文的检查问题,例如:
8参数来源是否交代,结果是否包含基准对照,误差是否解释,图表是否能独立读懂。
9不要把原文实验数据改写成我的结果。
10
有了这个对照表,再回到原论文看公式、表格和图,会更容易发现自己的稿件缺了哪一部分.例如,某个结论只有最终数值却没有基准方案,某张图好看但缺少单位,或者约束写出来了却没有解释它对应的现实含义.
AI 在这里适合承担定位、整理和提出检查问题的工作.模型是否选得合理、推导能否成立、自己的实验是否足以支撑结论,仍需要本人完成判断.
9.给开发者补充:配置之外的接口边界
这次正文流程通过 WorkBuddy 完成,不要求读者编写代码.若准备把相同模型接入自己的工具,下面是便于理解的 HTTP 请求结构,不是本次 WorkBuddy 的抓包记录,也没有在本文中单独执行测试:
1POST /v1/chat/completions HTTP/1.1
2Host: maas-api.lanyun.net
3Authorization: Bearer <在本机安全读取的蓝耘API_KEY>
4Content-Type: application/json
5
6{
7  "model": "glm-5.3-flash",
8  "messages": [
9    {
10      "role": "user",
11      "content": "请根据已解析的论文文本整理学习提纲;没有依据的内容请标明。"
12    }
13  ],
14  "stream": false
15}
16
真正使用时还需要提供已解析的论文文本或相关上下文.这个普通对话请求本身不会自动上传 DOCX、调用 xParse,也不会直接生成本地图片文件;连接器调用和文件整理需要由应用组织.
本次结果对开发者的参考价值,在于看到了一套工具协作流程如何落地:模型服务有明确入口,文档解析有专门工具,产物以常见格式保存,运行后还有平台用量记录可查.后续要扩展功能,可以从这些明确的输入输出入手.
10.这次体验留下的判断
对我的学习场景来说,这套组合完成了最需要的一步:把一篇较长的建模论文,整理成能分别查看的正文、表格、公式源码与图片.相比只得到一段摘要,这些材料更方便回到原文核对,也更方便拿自己的论文逐项检查.
蓝耘元生代在其中提供 GLM-5.3-Flash 的模型调用服务,并留下了本次 33 次调用、0 次失败和平台显示 0.32 元的用量记录;WorkBuddy负责把指令、连接器与文件操作组织起来;TextIn xParse 承担文档解析.三者的分工清楚,才容易理解结果来自哪里、下一步该检查什么.
公式预览仍未处理,部分图片没有题注,跨页表格也需要人工辨认.这些细节没有让我放弃使用导出的资料,却提醒我:文件生成之后,学习和核对才刚开始.
如果你也在复盘建模论文,可以先选一篇自己有权使用、并且愿意认真读完的材料,把这两轮整理流程跑一遍.最终要留下的,不只是一个文件夹,而是对“这篇论文为什么这样建模、自己的论文还能怎样改进”的具体理解.
🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 心态对了,生活就顺了!
人只有心态好,状态和运气才会越来越好.心里开阔的时候,带来的全都是积极的、向上的气场.当你拥有好心态,乐观精神会围绕你打造正能量磁场,你身边所有的事都将变得有秩序和顺利.当你积极善待生活,面前的所有难题都会迎刃而解.笑口常开,好命的第一步,心态好,一切都会很好.
《蓝耘元生代实测:用WorkBuddy + TextIn xParse拆解43页建模论文,整理表格、公式与图片》 是转载文章,点击查看原文。