目录
1. 企业级RAG真正要解决的是“可信”
2. 检索结果相关,不代表它可以使用
3. 生产级RAG不要只做向量检索
4. 回答必须和Evidence绑定
5. Citation不是在答案后面加个[1]
6. 企业RAG必须敢于拒答
7. 文档上传成功,也不等于知识可以使用
8. 企业知识源也不应该只有“上传文件”
9. 回答错误之后,还需要Quality Loop
10. 我现在更推荐的生产级RAG架构
11. Spring AI 2.0负责什么,业务系统又该负责什么?
12. 开源项目:Spring AI Business Copilot
13. 总结
本文所有架构思路、工程设计和核心代码,都来自我正在持续维护的开源项目 Spring AI Business Copilot。
项目基于 Java 21 + Spring Boot 4.1 + Spring AI 2.0 + PostgreSQL + pgvector,目前已经包含 Knowledge、Data、Support、Report、HR 等多个企业 AI Copilot。
本文讲到的 混合检索、引用校验、无依据拒答、知识版本、权限过滤、质量复核 都可以直接在项目中找到实现并运行测试。
如果这套企业 AI 工程实践对你有帮助,建议先给项目点个 Star ⭐。
后续这个系列还会继续拆 Text-to-SQL、Guardrails、Human-in-the-loop、Agent Evaluation 等生产级实现。
前言
很多人第一次做 RAG,流程基本都是:
1文档上传
2  ↓
3文本解析
4  ↓
5Chunk
6  ↓
7Embedding
8  ↓
9Vector Store
10  ↓
11TopK
12  ↓
13Prompt
14  ↓
15LLM
16
这条链路当然没有问题。
我之前的文章里也已经详细写过企业 RAG 的整体设计,包括文档解析、Chunk、向量检索、权限过滤、Rerank 等内容。
所以这篇不再重新讲一遍 Chunk 怎么切、Embedding 怎么调、TopK 怎么选。
这次继续往生产环境走一步。
因为真正把 RAG 接进企业系统以后,很快会遇到另一个问题:
检索到了,不代表这个答案就可以相信。
比如员工问:
北京出差住宿标准是多少?
知识库召回了一份《员工差旅制度》:
1一线城市住宿标准最高 500 元/晚。
2
模型回答:
根据公司差旅制度,北京住宿标准最高为 500 元/晚。
答案流畅、召回正常,甚至还能给你挂一个引用。
但问题是:
这是一份两年前的制度。
半年前,公司已经更新到 V3:
1一线城市住宿标准最高 600 元/晚。
2
这时候问题已经不再是:
RAG 能不能找到内容?
而是:
RAG 怎么保证找到的是当前有效、用户有权访问,而且真正能够支撑答案的内容?
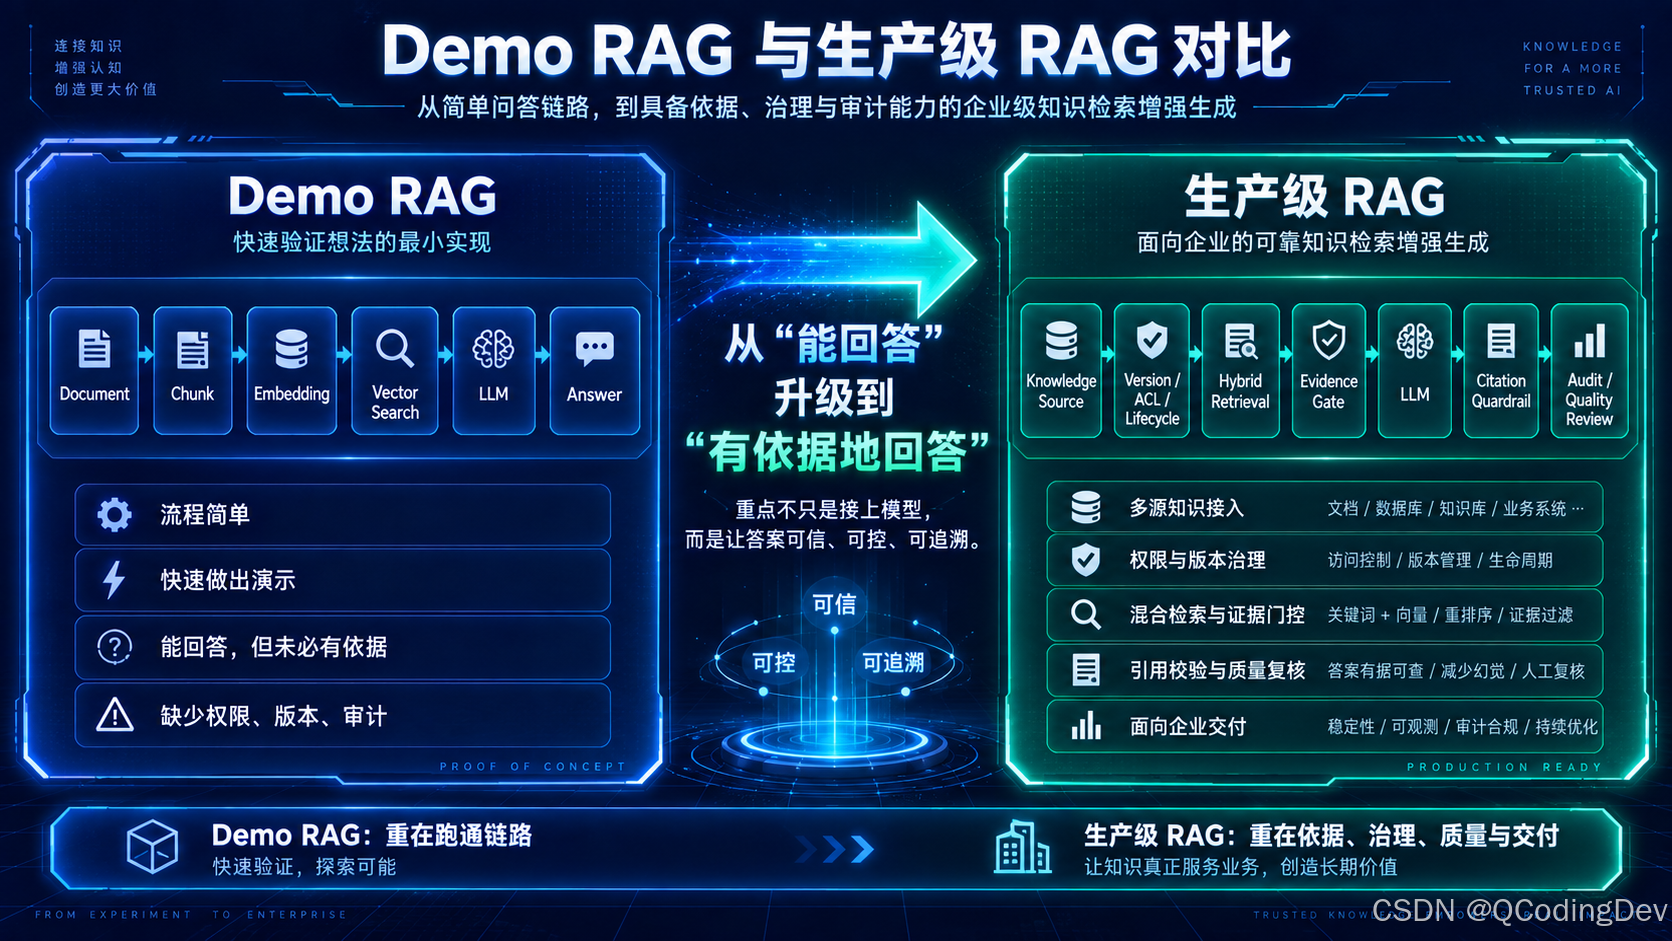
这就是 Demo RAG 和生产级 RAG 之间非常关键的一道分界线。
1. 企业级RAG真正要解决的是“可信”
一个简单 RAG 主要解决:
1Question
2   ↓
3Retrieval
4   ↓
5Context
6   ↓
7LLM
8   ↓
9Answer
10
但企业真正关心的问题会多很多:
- 这句话依据哪份文档?
- 引用的 Chunk 真的存在吗?
- 文档是不是当前版本?
- 文档有没有过期?
- 用户有没有权限查看?
- 两份制度冲突怎么办?
- 没有证据时模型会不会继续编?
- AI 回答错了以后能不能追查?
- 人工发现问题后怎么形成治理闭环?
所以我现在更倾向于把生产级 RAG 的可信能力拆成三层:
1检索可信
2Retrieval Trust
3
4      ↓
5
6回答可信
7Answer Trust
8
9      ↓
10
11知识可信
12Knowledge Trust
13
第一层保证:
找到的知识可以使用。
第二层保证:
模型的回答能够被证据支撑。
第三层保证:
进入 RAG 的知识本身处于正确生命周期。
这时候 RAG 才不只是:
1Vector Search + LLM
2
而逐渐变成一套完整的:
1Knowledge Governance
2        +
3Retrieval
4        +
5Evidence
6        +
7Generation
8        +
9Guardrails
10        +
11Audit
12
2. 检索结果相关,不代表它可以使用
RAG 优化时我们经常关注:
- TopK
- Similarity
- Hybrid Search
- Rerank
- Recall
- Precision
这些都重要。
但生产环境还要加一个前提:
相关性只是知识进入上下文的条件之一。
例如知识库里存在三份文档:
1员工差旅制度 V1
2状态:历史版本
3
4员工差旅制度 V3
5状态:当前版本
6
7财务特殊报销政策
8权限:Finance
9
员工询问:
北京出差住宿标准是多少?
从语义相关度来看,这三份文档都可能被命中。
甚至 V1 与 V3 的文本高度相似。
如果检索逻辑只有:
1ORDER BY similarity DESC
2LIMIT 10
3
就可能把:
- 历史版本
- 已经过期文档
- 当前用户无权访问的文档
一起交给 LLM。
这也是为什么我在 Knowledge Copilot 中没有单纯依赖向量相似度,而是把知识生命周期直接放进检索条件。
项目中的文本检索核心 SQL,实际会先做这些过滤:
1private static final String TEXT_SEARCH_SQL = """
2    SELECT c.id AS chunk_id,
3           ts_rank_cd(
4               to_tsvector('simple', c.content),
5               websearch_to_tsquery('simple', ?)
6           ) AS rank
7    FROM knowledge_chunks c
8    JOIN knowledge_documents d ON d.id = c.document_id
9    WHERE d.enabled = TRUE
10      AND d.current_version = TRUE
11      AND d.index_status = 'INDEXED'
12      AND (d.expires_at IS NULL OR d.expires_at > now())
13      AND d.conflict_status = 'NONE'
14      AND (
15            d.visibility_scope = 'ALL'
16            OR (d.visibility_scope = 'HR_REVIEWER' AND ?)
17            OR (d.visibility_scope = 'ADMIN' AND ?)
18          )
19      AND (?::text IS NULL OR d.category = ?::text)
20      AND to_tsvector('simple', c.content)
21          @@ websearch_to_tsquery('simple', ?)
22    ORDER BY rank DESC, c.id
23    LIMIT ?
24    """;
25
这里真正值得关注的不是全文检索 SQL 本身,而是:
1enabled = true
2
3current_version = true
4
5index_status = INDEXED
6
7未过期
8
9无冲突
10
11ACL匹配
12
13业务分类匹配
14
只有通过这些条件的知识,才有资格进入后续检索。
这意味着:
权限、版本和生命周期控制应该发生在 Retrieval 层,而不是 Prompt 层。
千万不要先把敏感文档塞进 Context,再告诉模型:
1如果用户没有权限,请不要回答。
2
因为这个时候数据已经进入模型上下文了。
3. 生产级RAG不要只做向量检索
另一个常见误区是:
RAG = Vector Search。
但实际企业知识里,大量查询并不完全适合纯向量检索。
例如:
1A10086退款规范
2
32026差旅管理制度
4
5P1故障处理流程
6
7采购审批三级权限
8
这种包含:
- 编号
- 专有名词
- 制度名称
- 业务关键词
的问题,Keyword / Full Text Search 往往也非常有价值。
所以 Knowledge Copilot 当前采用的是:
1PostgreSQL Text Search
2        +
3Keyword Search
4        +
5pgvector Vector Search
6        ↓
7      Fusion
8        ↓
9      TopK
10
核心逻辑类似这样:
1List<KnowledgeChunkRepository.TextSearchResult> textResults =
2        chunkRepository.findByTextSearch(question, topK * 2);
3
4List<KnowledgeChunkRepository.TextSearchResult> keywordResults =
5        chunkRepository.findByKeywordSearch(
6                KnowledgeQueryTerms.extract(question), topK * 2);
7
8float[] questionVector =
9        aiEmbeddingService.embed(
10                "knowledge.question-retrieval", question);
11
12List<KnowledgeEmbeddingRepository.SimilaritySearchResult> vectorResults =
13        embeddingRepository.findSimilarChunks(
14                questionVector,
15                embeddingModel,
16                topK * 2,
17                minSimilarity);
18
然后把不同通道的排序结果进行融合。
这里需要强调一点:
Hybrid Retrieval 解决的是“怎么找到更好的候选”。
但是它依然不能替代:
1Document Version
2ACL
3Expiry
4Conflict
5Index Status
6
Rerank 也是同理。
Rerank 能告诉你谁更相关,却不能告诉你谁有资格被使用。
4. 回答必须和Evidence绑定
传统 RAG 通常会这样构建 Prompt:
1请根据以下知识回答问题。
2
3Context:
4{retrievedChunks}
5
6Question:
7{question}
8
相比直接让模型裸答,这已经安全很多。
但是:
LLM 拿到 Context,不代表它一定只使用 Context。
它仍然可能:
- 使用自己的参数知识;
- 补全缺失的信息;
- 把两个 Chunk 拼出一个不存在的结论;
- 生成证据中没有出现的数字;
- 编造一个不存在的引用。
因此企业知识助手最好不要只返回:
1{
2  "answer": "北京住宿标准为600元/晚"
3}
4
更合理的是返回:
1{
2  "status": "ANSWERED",
3  "answer": "根据当前差旅制度,北京住宿标准最高为600元/晚。",
4  "citations": [
5    {
6      "chunkId": 1028,
7      "excerpt": "一线城市住宿标准最高600元/晚"
8    }
9  ]
10}
11
此时答案和证据形成:
1Answer
2  ↓
3Claim
4  ↓
5Citation
6  ↓
7Evidence
8
也就是说:
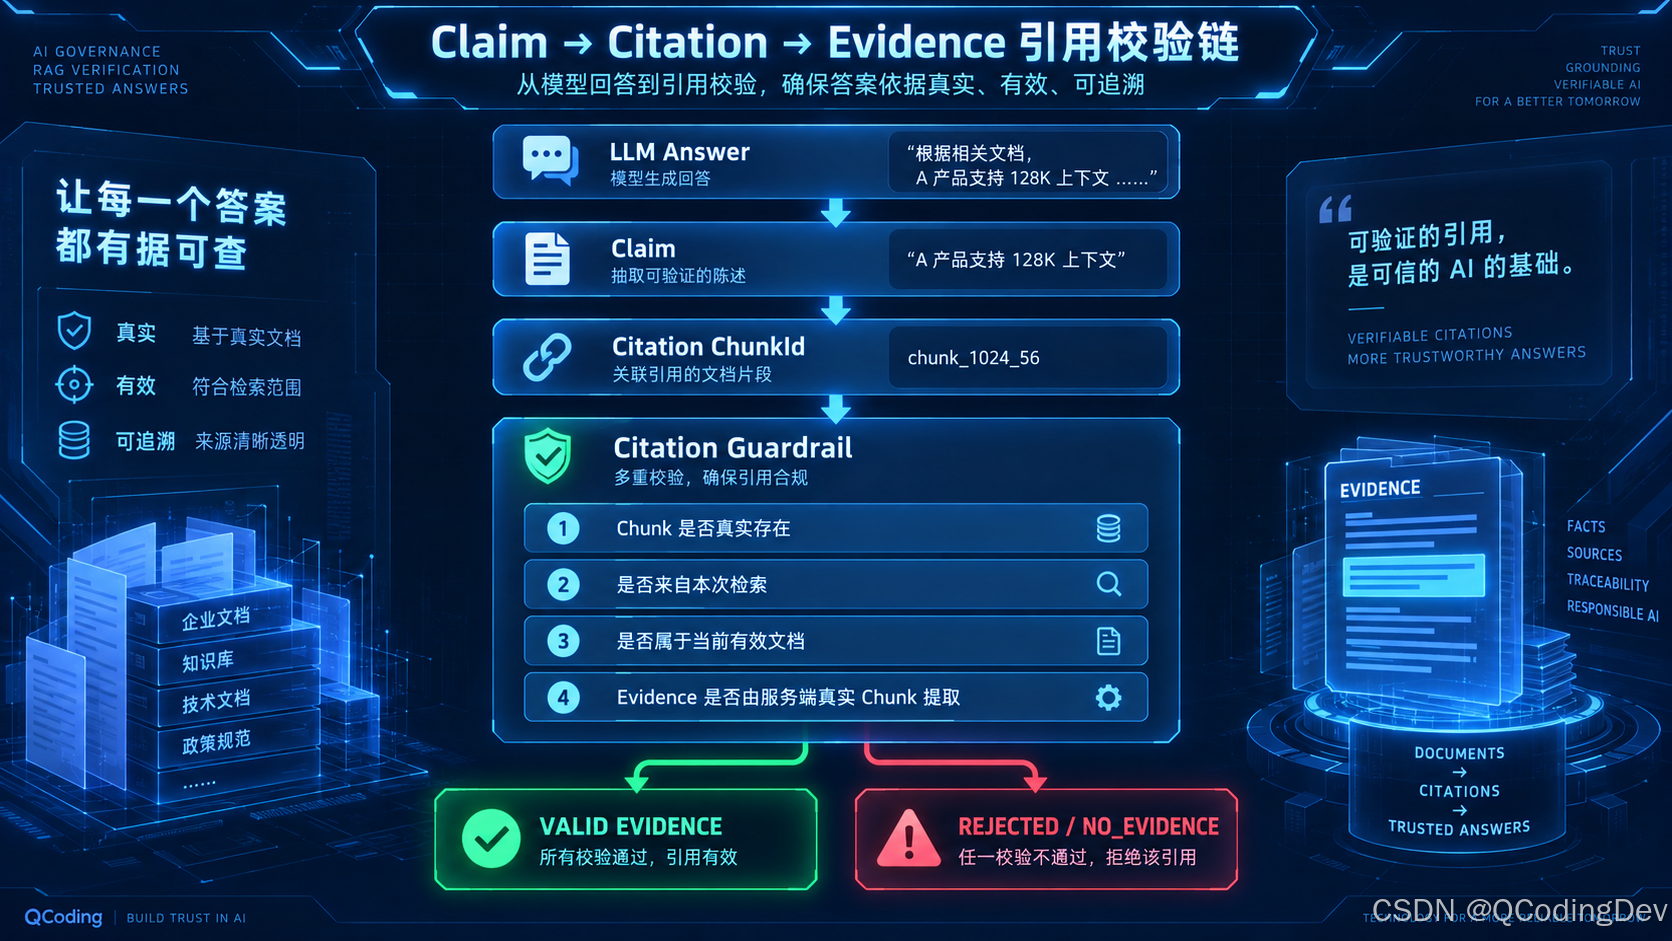
重要结论必须能够回到本次真实检索到的证据。
5. Citation不是在答案后面加个[1]
现在很多 RAG 系统已经开始支持引用:
1北京住宿标准最高600元/晚。[1]
2
3[1] 员工差旅制度.pdf
4
看起来已经能够溯源。
但如果这个 [1] 完全由 LLM 自己生成,它仍然可能出现幻觉。
比如模型返回:
1{
2  "chunkId": 99999
3}
4
但 99999 根本没有在这次检索结果里出现。
所以 Citation 不能直接信模型。
我在项目里单独做了一个 CitationGuardrailService。
核心代码并不复杂:
1public CitationValidationResult validate(
2        List<KnowledgeCitation> citations,
3        List<RetrievedKnowledgeChunk> retrievedChunks) {
4
5    List<String> violations = new ArrayList<>();
6
7    if (citations == null || citations.isEmpty()) {
8        violations.add("ANSWERED 状态至少需要一条引用,但模型未返回引用");
9        return new CitationValidationResult(false, violations);
10    }
11
12    Set<Long> validChunkIds = retrievedChunks.stream()
13            .map(r -> r.chunk().id())
14            .collect(Collectors.toSet());
15
16    for (KnowledgeCitation citation : citations) {
17        if (citation.chunkId() == null) {
18            violations.add("引用中的 chunkId 不能为空");
19            continue;
20        }
21
22        if (!validChunkIds.contains(citation.chunkId())) {
23            violations.add(
24                    "引用的 chunkId=" + citation.chunkId()
25                    + " 不在本次召回结果中");
26        }
27    }
28
29    return new CitationValidationResult(
30            violations.isEmpty(), violations);
31}
32
思路其实很简单:
1LLM说自己引用了什么
2        ↓
3系统拿本次真实Retrieved Chunks
4        ↓
5做集合校验
6        ↓
7引用真实存在?
8       ↙   ↘
9     YES    NO
10      ↓      ↓
11   Continue Reject
12
在项目里我甚至没有直接相信模型返回的引用摘录。
Citation 校验完成以后,excerpt 会重新从服务端真实 Chunk 中生成。
因为模型完全可能把原文:
1原则上不超过600元
2
改写成:
1统一标准为600元
2
虽然看起来只改了一点点,但语义已经发生变化。
所以:
Citation ID 可以让模型选择,但 Citation Evidence 最好由系统重新绑定。
6. 企业RAG必须敢于拒答
企业 AI 最危险的一种能力其实是:
什么都敢回答。
比如员工问:
公司对海外长期驻场的住房补贴是多少?
系统检索后:
1没有找到任何当前有效知识。
2
这个时候最危险的处理是:
1LLM根据常识继续生成。
2
更加可靠的处理应该是:
1NO_EVIDENCE
2
直接告诉用户:
当前知识库没有找到能够支持该问题的有效资料。
在 Knowledge Copilot 里,这个逻辑不是单纯写一句 Prompt:
1不知道的时候请说不知道。
2
而是直接进入系统状态。
例如当前 KnowledgeAnswerService 的核心逻辑:
1if (retrievedChunks == null || retrievedChunks.isEmpty()) {
2
3    log.info("未召回知识分片,返回无依据状态");
4
5    return result(
6        new KnowledgeAnswerResponse(
7            KnowledgeAnswerStatus.NO_EVIDENCE,
8            null,
9            List.of(),
10            List.of(),
11            aiChatService.modelName()
12        ),
13        null,
14        null,
15        "NO_RETRIEVED_EVIDENCE"
16    );
17}
18
注意这里一个很重要的细节:
没有 Evidence 时,连 LLM 都不调用。
这样不仅避免模型幻觉,还能:
- 减少 Token 消耗;
- 降低模型调用延迟;
- 让拒答状态可以统计;
- 让监控系统区分“知识不足”和“模型失败”。
而即使模型返回了 ANSWERED,后面依然还会做 Citation Guardrail:
1CitationValidationResult validation =
2        citationGuardrailService.validate(
3                citations, retrievedChunks);
4
5if (!validation.valid()) {
6
7    return result(
8        new KnowledgeAnswerResponse(
9            KnowledgeAnswerStatus.REJECTED,
10            null,
11            List.of(),
12            validation.violations(),
13            modelName
14        ),
15        prompt.metadata(),
16        aiMetadata,
17        "CITATION_VALIDATION_FAILED"
18    );
19}
20
所以完整思路并不是:
1LLM说可以回答
2      ↓
3直接展示
4
而是:
1Retrieval
2    ↓
3Evidence Gate
4    ↓
5LLM
6    ↓
7Structured Output
8    ↓
9Citation Guardrail
10    ↓
11Final Answer
12
这里我认为有一句话特别重要:
有召回,不等于有依据。
7. 文档上传成功,也不等于知识可以使用
企业知识还有一个很容易被忽略的问题:
生命周期。
普通 Demo 里文档可能只有:
1上传
2↓
3切分
4↓
5入库
6
但生产环境需要考虑:
1旧版本怎么办?
2
3Embedding失败怎么办?
4
5索引做到一半应用重启怎么办?
6
7外部知识已经删除怎么办?
8
9文档已经过期怎么办?
10
11两份制度发生冲突怎么办?
12
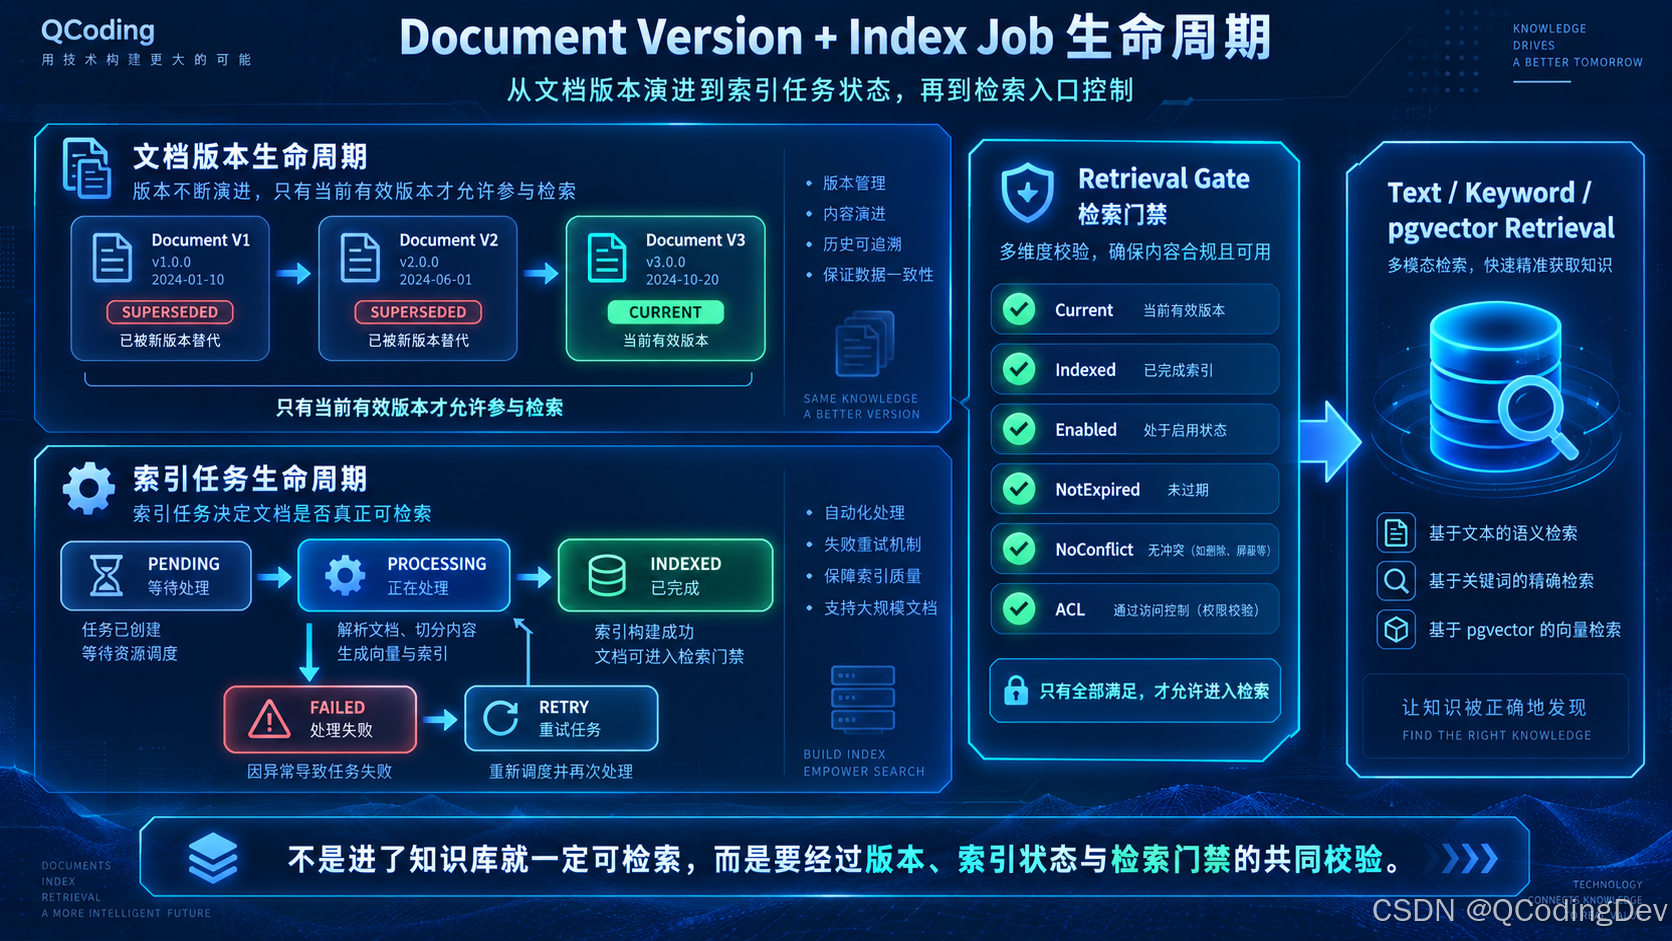
因此文档本身需要状态:
1Version 1
2SUPERSEDED
3
4Version 2
5SUPERSEDED
6
7Version 3
8CURRENT
9
索引任务也需要状态:
1PENDING
2   ↓
3PROCESSING
4   ↓
5SUCCESS
6
7或
8
9FAILED
10
只有同时满足:
1enabled
2
3current_version
4
5INDEXED
6
7not expired
8
9no conflict
10
11ACL passed
12
才允许进入检索。
这也是为什么我不建议企业知识库采用:
1上传文件 → 直接标记成功
2
而应该把:
文档状态
和:
索引任务状态
分开管理。
甚至还要处理一种比较隐蔽的情况:
1任务A开始索引V1
2      ↓
3任务A执行很慢
4      ↓
5用户已经上传V2
6      ↓
7任务B完成V2索引
8      ↓
9任务A此时才执行完成
10
如果没有版本和任务状态保护,旧任务就可能反过来覆盖新数据。
8. 企业知识源也不应该只有“上传文件”
企业知识往往并不只来自上传 PDF。
还可能来自:
1MinIO / S3
2
3SharePoint
4
5Confluence
6
7Notion
8
9内部知识平台
10
11挂载目录
12
这时候新的问题又来了:
每次同步是不是重新全量向量化?
显然不应该。
更加合理的是:
1Source
2  ↓
3Cursor
4  ↓
5Incremental Sync
6  ↓
7Content Hash
8  ↓
9Changed?
10 ↙     ↘
11YES     NO
12 ↓       ↓
13Reindex Renew
14
除此之外,还必须处理:
- 源端删除;
- ACL发生变化;
- 同步失败;
- Cursor异常;
- 长期没有成功同步;
- 外部文档过期;
- 内容冲突。
因此做到后面会发现:
企业 Knowledge Copilot 已经不只是一个 RAG 页面。
它逐渐变成一个:
知识接入 + 知识生命周期 + 检索 + AI问答 + 质量治理系统。
这也是生产级 RAG 真正复杂的地方。
9. 回答错误之后,还需要Quality Loop
做到前面这些,是不是就不会回答错了?
当然不是。
LLM 永远不可能保证 100% 正确。
所以系统还需要解决最后一个问题:
错了以后怎么办?
简单一点的产品通常只有:
1👍 / 👎
2
但这对于真正定位问题还不够。
一次错误回答可能来自完全不同的原因:
1Retrieval Error
2检索错了
3
4Evidence Error
5证据不足
6
7Citation Error
8引用错误
9
10Answer Error
11模型理解错误
12
13Knowledge Error
14知识本身过期
15
16Policy Error
17规则设计问题
18
因此在 Knowledge Copilot 中,我把用户反馈继续进入 Quality Queue。
整体链路是:
1Answer
2  ↓
3Feedback
4  ↓
5Quality Queue
6  ↓
7Reviewer
8  ↓
9Evidence Assessment
10+
11Answer Assessment
12+
13Remediation
14+
15Disposition
16  ↓
17Closed
18
这样人工审核结果才能反过来指导系统优化。
例如:
1召回错误
2→ 调整Retrieval
3
4引用错误
5→ 修复Citation Guardrail
6
7知识过期
8→ 修复Source / Lifecycle
9
10模型过度推断
11→ 调整Prompt / Evidence Gate
12
13资料本身错误
14→ 回到Knowledge Governance
15
这时候“用户点了一个差评”才真正形成工程闭环。
10. 我现在更推荐的生产级RAG架构
把前面的能力串起来以后,一套企业 Knowledge Copilot 大致会变成:
1                 Knowledge Sources
2                       ↓
3              Document Processing
4                       ↓
5              Version / Index Job
6                       ↓
7            Lifecycle + ACL Filter
8                       ↓
9        ┌──────────────┼──────────────┐
10        ↓              ↓              ↓
11   Text Search    Keyword Search   Vector Search
12        └──────────────┼──────────────┘
13                       ↓
14                  Result Fusion
15                       ↓
16                  Evidence Set
17                       ↓
18                 Evidence Gate
19                   ↙        ↘
20            NO_EVIDENCE    SUPPORTED
21                 ↓             ↓
22              Refuse           LLM
23                                 ↓
24                       Structured Answer
25                                 ↓
26                       Citation Guardrail
27                                 ↓
28                         Final Response
29                                 ↓
30                     Audit / Feedback
31                                 ↓
32                        Quality Review
33
这时候企业 RAG 已经从:
1Retrieval + LLM
2
升级成:
1Knowledge Lifecycle
2+
3Hybrid Retrieval
4+
5Evidence
6+
7Generation
8+
9Citation Guardrail
10+
11Audit
12+
13Quality Loop
14
11. Spring AI 2.0负责什么,业务系统又该负责什么?
这里也很容易产生一个误区:
使用 Spring AI 做了 RAG,就等于企业级 RAG 已经完成。
实际上不是。
Spring AI 2.0 可以帮我们提供很多 AI 应用基础设施,例如:
1Chat Model
2
3Embedding Model
4
5Vector Store
6
7Prompt
8
9Structured Output
10
11Tool Calling
12
13Advisor
14
这些能力能大幅降低 Java 开发 AI 应用的成本。
但:
1Document Version
2
3ACL
4
5Knowledge Lifecycle
6
7Index Job
8
9Citation Validation
10
11NO_EVIDENCE
12
13Conflict Management
14
15Quality Review
16
17Audit
18
这些仍然需要你的业务系统负责。
这和我们以前做 Spring Boot 项目其实非常像。
Spring Boot 帮我们解决:
1IOC
2MVC
3Transaction
4AOP
5
但是:
1订单状态
2
3审批规则
4
5业务权限
6
7库存一致性
8
依然要自己设计。
AI Framework 也是同样的道理。
框架负责提供能力,企业系统负责守住业务边界。
12. 开源项目:Spring AI Business Copilot
本文上面讲到的这些能力,并不是我单独整理的一套概念。
目前都在持续落到我的开源项目:
Spring AI Business Copilot
⭐ GitHub:
 https://github.com/qcodingdev/spring-ai-business-copilot
当前项目已经包含:
1Knowledge Copilot
2企业知识助手
3
4Data Copilot
5Text-to-SQL / 数据分析
6
7Support Copilot
8客户服务
9
10Report Copilot
11企业报告
12
13HR Copilot
14招聘与员工服务
15
其中本文拆解的 Knowledge Copilot 已经覆盖:
- 文档版本管理
- 持久化索引任务
- PostgreSQL Text Search
- Keyword Search
- pgvector Vector Search
- 混合检索
- Role / Category权限过滤
- 无依据拒答
- Citation Guardrail
- 过期与冲突知识过滤
- Answer Feedback
- Quality Review Queue
项目可以直接 Clone 后运行。
如果你正在学习:
1Spring AI 2.0
2
3RAG
4
5Agent
6
7企业AI架构
8
9AI工程治理
10
也可以直接拿它做学习和二次开发参考。
如果看到这里还没有 Star,可以顺手支持一下。⭐
后续我也会继续基于这个项目拆:
Text-to-SQL 真正进入生产为什么不能直接执行 SQL?
Guardrails 和 Human-in-the-loop 到底应该放在哪一层?
Agent Evaluation 怎么做离线评测、Readiness 和上线门禁?
13. 总结
回到本文最开始的问题:
企业级 RAG 真正难在哪里?
现在答案应该比较清楚了。
难的并不是:
1把PDF转成向量。
2
而是:
1知识是不是最新的?
2
3用户有没有权限?
4
5索引是否真的完成?
6
7检索结果能不能作为证据?
8
9引用是不是真的?
10
11没有证据时AI敢不敢拒答?
12
13知识更新后旧版本怎么处理?
14
15AI回答错了以后怎么追查?
16
所以我现在更愿意把企业 RAG 理解成:
一个围绕“可信知识”建立起来的 AI 应用系统,而不仅仅是向量检索。
Vector Search 只是其中一个组件。
真正决定它能不能进入企业生产环境的,是:
版本、权限、生命周期、证据、引用、拒答、审计和质量闭环。
最终我们真正需要完成的是:
1AI能回答
2
到:
1AI为什么这样回答,我能够证明。
2
的升级。
👨💻 关于作者|QCoding
专注 AI应用开发与Java技术实践。
持续分享 Spring AI、RAG、 Agentic、Agent Evaluation、企业AI架构、工程治理与AI转型实践

