摘要:当单个 Agent 无法独立完成复杂任务时,多 Agent 协作成为必然选择。在众多协作范式中,Pipeline(串行流水线)模式是最简单、最直观、也最容易踩坑的一种——它把一个大任务拆成多个有先后依赖的子任务,让每个 Agent 只专注一个环节,前一个 Agent 的输出成为后一个 Agent 的输入。本文从第一性原理出发,系统拆解 Pipeline 模式的任务分解、串行编排与中间态传递三大核心问题,对比 LangGraph、LangChain LCEL 与自研轻量编排三种实现路径,并给出可运行的生产级代码。无论你是刚接触多 Agent 开发的工程师,还是正在优化已有编排系统的架构师,都能从中获得可直接落地的工程实践。
📌 版本声明:本文基于 LangGraph 0.2+、LangChain 0.3+、Python 3.11+ 编写,撰写时间 2026 年 10 月。核心概念(任务分解、串行编排、中间态传递)适用于所有 Agent 编排框架,具体 API 以所使用版本为准。
适用边界:适用于存在天然先后依赖、每个阶段可由独立 Agent 可靠完成的文本类 Agent 任务。若子任务之间高度耦合、需要频繁回环协商,或存在并行分支,Pipeline 不是最优选择,此时应参考本系列的 MapReduce(第 23 篇)与 Supervisor(第 24 篇)模式。
文章目录
-
- 一、为什么需要 Pipeline:单 Agent 的边界
-
- 1.1 单 Agent 做一件事很擅长,做多件事很吃力
- 1.2 多 Agent 协作的四大范式
- 1.3 从"一步到位"到"流水线"的心智转变
- 1.4 什么时候该拥抱多 Agent:判据清单
- 1.5 Pipeline 在协作范式中的地位
- 1.1 单 Agent 做一件事很擅长,做多件事很吃力
- 二、Pipeline 模式核心概念:专门章节
-
- 2.1 任务分解(Task Decomposition)
- 2.2 串行编排(Orchestration)
- 2.3 中间态传递(Intermediate State Passing)
- 2.1 任务分解(Task Decomposition)
- 三、环境准备
-
- 3.1 环境与依赖
- 3.2 案例任务定义
- 3.1 环境与依赖
- 四、核心实战:从零搭建串行 Pipeline
-
- 4.1 第一步:定义强类型中间态(Pydantic)
- 4.2 第二步:实现各环节 Agent
- 4.3 第三步:用 StateGraph 串起流水线
- 4.4 第四步:加入失败与重试 —— 让流水线"抗造"
- 4.5 一次真实运行的完整观测
- 4.1 第一步:定义强类型中间态(Pydantic)
- 五、进阶:中间态传递的三个实战技巧
-
- 5.1 技巧一:用"不可变快照"做可观测与回滚
- 5.2 技巧二:显式传递 vs 隐式传递的选择
- 5.3 技巧三:Schema 版本演进与向后兼容
- 5.1 技巧一:用"不可变快照"做可观测与回滚
- 六、方案对比:LangGraph vs LCEL vs 自研轻量编排
-
- 6.1 LangChain LCEL 的 Pipeline
- 6.2 自研轻量编排:何时需要,怎么设计
- 6.3 三方案横向对比
- 6.4 真实业务案例:内容审核流水线
- 6.1 LangChain LCEL 的 Pipeline
- 七、适用边界与风险提示 ⚠️
-
- 7.1 Pipeline 适合什么
- 7.2 Pipeline 不适合什么
- 7.3 三大典型陷阱
- 7.1 Pipeline 适合什么
- 八、进阶:让 Pipeline 更工程化
-
- 8.1 加入校验环节:在错误扩散前拦截
- 8.2 Mock 测试:不依赖真实 LLM 的回归测试
- 8.3 观测与监控:Pipeline 的可观测性
- 8.4 降级方案:Pipeline 的最后一层兜底
- 8.5 与 LLM 供应商解耦:换个模型不改代码
- 8.1 加入校验环节:在错误扩散前拦截
- 九、总结
-
- 落地自检清单(Checklist)
- 常见问题(FAQ)
- 落地自检清单(Checklist)
- 参考资料
一、为什么需要 Pipeline:单 Agent 的边界
1.1 单 Agent 做一件事很擅长,做多件事很吃力
想象一个真实场景:你要构建一个"竞品技术报告自动生成系统"。用户丢进来一个竞品产品名,系统要输出一份包含功能拆解、技术栈推断、定价策略、优劣势对比的完整调研报告。
如果让一个 Agent 完成全部工作,会发生什么?
它会尝试把"搜集信息、分析技术栈、对比定价、撰写报告"这些差异极大的子任务塞进同一个上下文窗口、同一套工具集合、同一个角色设定里。结果往往是:
- 上下文被污染。调研网络资料时产生的噪声,会干扰最终写报告的判断。
- 角色冲突。一个 Agent 既要当"技术侦查员",又要当"定价分析师",还要当"报告写手",系统提示词(System Prompt)会膨胀到互相打架。
- 失败难以定位。总耗时 3 分钟的任务,一旦中途报错,你根本不知道是"网络检索挂了"还是"分析逻辑错了"还是"LLM 输出格式不对"。
- 无法并行与复用。同样的"技术栈推断"逻辑,下次别的产品也要用,但你没法单独抽出这段能力。
这正是多 Agent 协作要解决的问题:让每个 Agent 只做一件它最擅长的事,再用编排机制把它们串起来。
1.2 多 Agent 协作的四大范式
业界常见的多 Agent 协作范式,本质上是围绕"任务如何拆分"与"结果如何汇聚"两个维度展开的。我把它们归为四类:
| 范式 | 协作方式 | 代表框架 | 适用场景 |
|---|---|---|---|
| Pipeline(串行) | 前一个 Agent 的输出 → 后一个 Agent 的输入 | LangGraph、自研 DAG | 有先后依赖的线性流程 |
| MapReduce(并行) | 任务扇出给多个 Agent 并行处理,再聚合 | LangGraph、Celery | 子任务相互独立、可并行 |
| Supervisor(主管) | 一个主管 Agent 调度下属 Agent | LangGraph、AutoGen | 任务动态、需决策路由 |
| 黑板模式(共享内存) | Agent 共享一块黑板,自主读写 | OpenCOPL、自研 | 协作目标模糊、需逐步逼近 |
本文聚焦第一种:Pipeline 串行流水线。它是理解多 Agent 协作的基石——后面的 MapReduce、Supervisor 本质上都是在 Pipeline 基础上扩展出并行与调度能力。
1.3 从"一步到位"到"流水线"的心智转变
理解 Pipeline 的关键,是接受一个反直觉的观点:把任务拆细、拆多,反而更快更稳。
流水线作业之所以在工业界统治了一百多年,是因为它把一个复杂的整体制造过程,变成了一个个可分工、可优化、可质检的环节。Agent 流水线同理:
需求/原始数据
Agent 1
数据采集
Agent 2
去重清洗
Agent 3
特征提取
Agent 4
分析研判
Agent 5
报告撰写
最终产出
每一跳(hop)都是一个独立的 Agent,有自己的 System Prompt、工具集和上下文。数据在环节间以结构化的"中间态"传递,而不是把整段对话历史甩给下一个 Agent。
这就是 Pipeline 模式的精髓:分工明确、状态可控、环节可测。
1.4 什么时候该拥抱多 Agent:判据清单
在动手之前,先问自己四个问题。只有同时满足多数条件,多 Agent(尤其是 Pipeline)才值得引入:
| 判据 | 说明 | 单 Agent 能胜任吗? |
|---|---|---|
| 任务异构程度 | 子任务是否需要不同角色/工具/专业背景 | 任务越异构,越需要多 Agent 分工 |
| 上下文窗口压力 | 全量上下文是否超过模型上下文窗口或将导致质量下降 | 超限则需要拆分 |
| 环节可复用性 | 某个环节是否会在其他任务中重复使用 | 可复用则应抽取独立 Agent |
| 可观测需求 | 是否需要定位"哪一步出了问题" | 多环节天然提供更细的观测点 |
💡 常见的过度设计信号:如果任务用几十行代码就能单 Agent 跑通,且对稳定性要求不高,那么引入多 Agent 反而增加了延迟和 Token 开销。多 Agent 是能力手段,不是目标本身。 记住这条原则:能单 Agent 就单 Agent,单 Agent 撑不住时再拆分。
1.5 Pipeline 在协作范式中的地位
在四大多 Agent 协作范式中,Pipeline 是最基础的一种,也是理解其他三种模式的"最小切片":
多 Agent 协作范式
Pipeline
串行流水线
有先后依赖
最基础模式
MapReduce
并行扇出
结果聚合
Supervisor
主管调度
动态路由
黑板模式
共享内存
自主读写
理解 Pipeline,就等于理解了"如何把任务拆成带依赖的环节、如何约束环节间交互、如何管理中间态"——这些能力在 MapReduce(并行扇出时内部的子流水线依然是串行)、Supervisor(主管分发的每个子任务内部往往也是串行)里同样需要。因此,Pipeline 是所有多 Agent 架构的地基。
二、Pipeline 模式核心概念:专门章节
在动手写代码之前,必须先厘清三个核心概念。它们是 Pipeline 能否跑得稳的根基,也是新手最容易翻车的地方。
2.1 任务分解(Task Decomposition)
任务分解是把一个大目标拆成若干有向依赖的子任务。拆分的质量直接决定流水线的成败。
好的拆分遵循三个原则:
- 单一职责:每个子任务只做一类事。让"数据清洗"的 Agent 顺带"写报告",就是职责污染。
- 清晰接口:每个子任务有明确的输入输出(中间态 Schema),前后环节依赖的是接口契约,而非隐式的对话上下文。
- 最小耦合:环节之间只通过中间态传输必要数据,不共享可变全局状态。
1┌───────────────────────────────────────────────┐
2│           任务分解的三层视角                    │
3│                                               │
4│  语义层    : 这个任务"做什么"                  │
5│  接口层    : 输入什么、输出什么(Schema)      │
6│  实现层    : 用哪个 Agent / 工具 / 模型去做    │
7└───────────────────────────────────────────────┘
8
初学者容易犯的错误是分解太粗(一个"分析报告"就完事)或分解太细(把"调用一次 API"也当成一个环节)。分解粒度以**“这一环是否需要独立的角色设定或工具集”**为准绳。
一个实用的粒度自检方法:把候选环节的 System Prompt 分别写出来,如果两个环节的 System Prompt 高度雷同、工具集也完全一样,那么它们大概率应该合并成一个环节;反之,如果某一环的 System Prompt 明显膨胀(超过正常角色描述),则应考虑继续拆分。经验上,单环节 System Prompt 控制在 100~300 字、工具集 2~5 个是比较健康的区间。
任务分解还有一层容易被忽略的“输入输出对齐”问题:上一层产出的结构与下一层期望的输入结构必须匹配。这就是我们后面会反复强调的中间态 Schema 一致性的重要性——它本质上是把分解结果“固化成契约”。
2.2 串行编排(Orchestration)
串行编排解决"环节之间如何驱动、如何控制流程"的问题。包括:
- 顺序执行:严格按依赖执行,前序未完成不得启动后续。
- 条件分支:根据中间态的值决定走哪个分支(例如质检不通过就重试)。
- 失败处理:环节失败时是重试、跳过、还是整条流水线回滚。
编排层是 Pipeline 的"骨胳",它不关心 Agent 内部怎么想,只关心环节的调用顺序、数据的流转、异常的分流。好的编排层应该让业务逻辑(Agent 做什么)与流程控制(Agent 怎么被调)解耦。
调度策略层面,Pipeline 编排器通常要支持三种基本控制原语:
| 控制原语 | 作用 | 典型手段 |
|---|---|---|
| 顺序执行 | 保证前序完成后才启动后续 | 图节点 + 有向边 |
| 条件分支 | 根据中间态走不同路径 | 条件边 / route 函数 |
| 循环重试 | 环节失败或质检不通过时重复执行 | 回边 + 重试计数 |
无论用 LangGraph 还是自研,这三大原语都缺一不可。掌握它们,你就掌握了编排层的核心能力。
2.3 中间态传递(Intermediate State Passing)
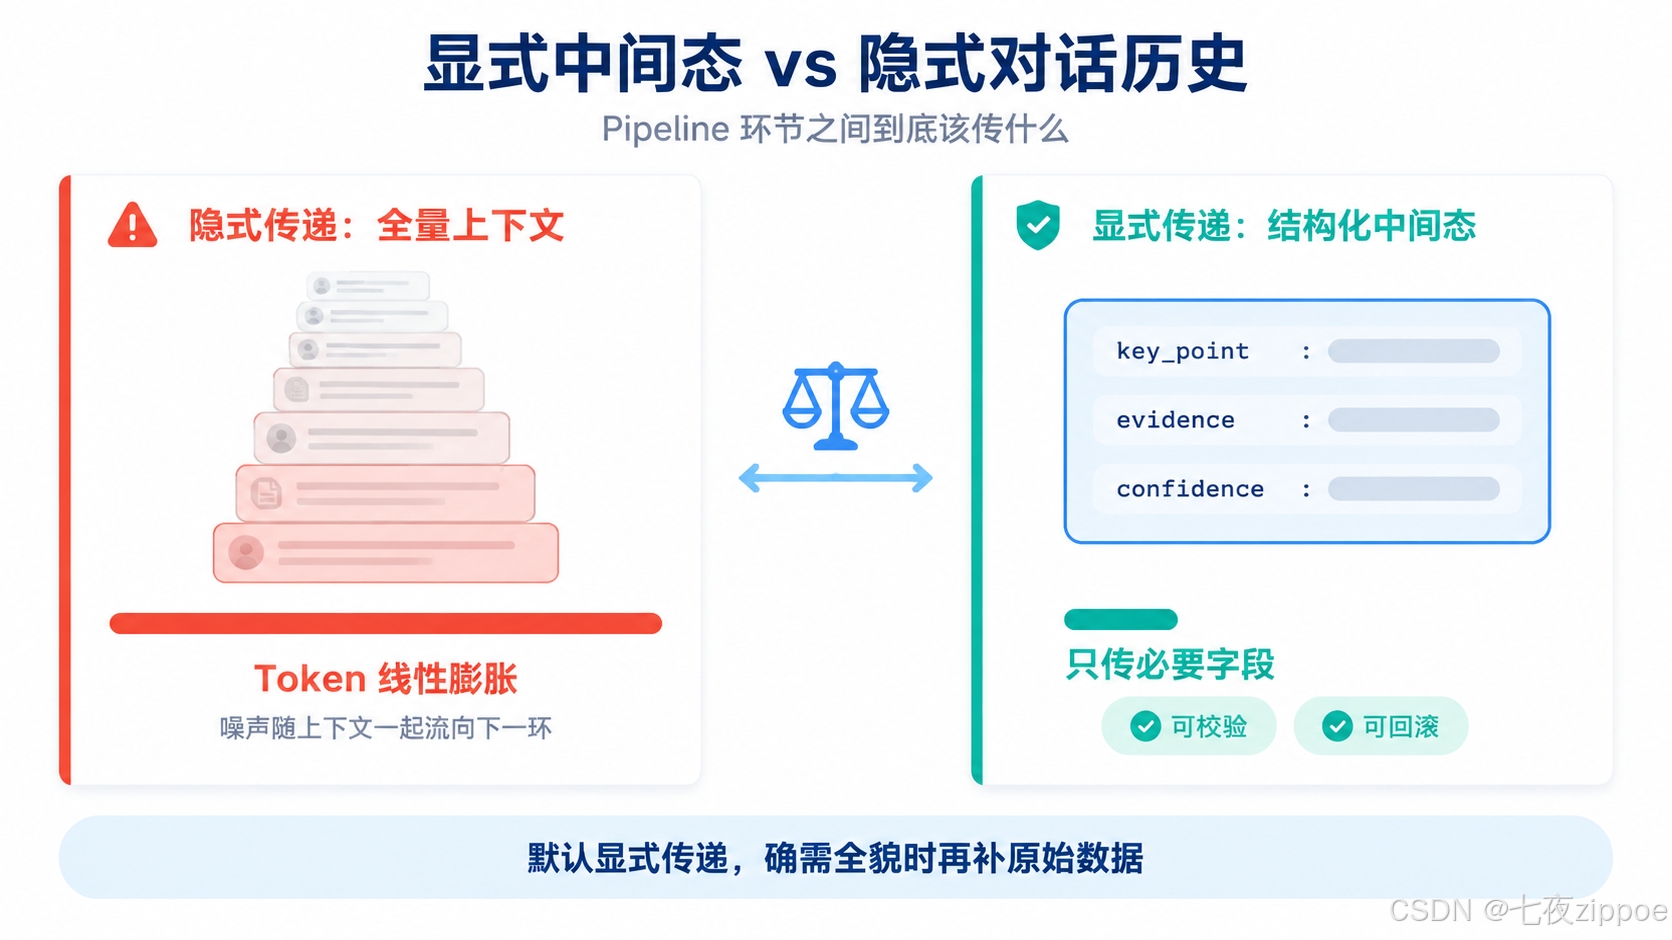
图1:显式中间态与隐式传递的上下文体积对比——决定该往下游传什么
中间态(Intermediate State) 是前一个 Agent 传给后一个 Agent 的结构化数据。与"直接把整个对话历史传给下一个 Agent"相比,中间态传递有两个关键优势:
- 节省 Token:只传必要的数据,而不是把前面几轮的所有对话、检索到的所有原文都带上。一个环节只把"提炼后的结构化结论"传下去,能省下大量上下文窗口。
- 可控性强:中间态是强类型的(有明确的 Schema),可以做校验、可观测、可回滚。而对话历史是自由文本,无法做结构化校验。
中间态应该被设计成不可变的快照(每个环节产生一份新的中间态,而不是原地修改),这样便于追踪"谁改了什么"。
状态存储 Agent 3 (分析) Agent 2 (清洗) Agent 1 (采集) 编排器 状态存储 Agent 3 (分析) Agent 2 (清洗) Agent 1 (采集) 编排器 任务 + 初始输入 采集原始数据 写入 state.v1(原始) 读取 state.v1 去重清洗 写入 state.v2(清洗后) 读取 state.v2 分析研判 写入 state.v3(结论)
看到没有?编排器负责"读"和"写"状态,Agent 只负责"算"。职责彻底分离,这也是 Pipeline 能工程化的根本原因。
中间态与上下文压缩的关系值得单独强调。很多团队误以为"上下文压缩"就是单纯地截断文本或做摘要,但在 Pipeline 里,显式中间态本身就是一种最有效的上下文压缩——它不是事后压缩,而是在设计阶段就决定了"下游只需要知道什么"。
我们可以把两种思路对照起来看:
| 方式 | 触发时机 | 压缩方式 | 风险 |
|---|---|---|---|
| 显式中间态 | 设计时 | 定义接口,只传必要字段 | 可能丢失边缘细节 |
| 运行时摘要 | 执行时 | 用 LLM 压缩长上下文 | 可能丢失关键信息、额外耗 Token |
| 滑动窗口裁剪 | 执行时 | 按 Token 裁剪最旧内容 | 可能切断关键上下文 |
实践建议:优先用显式中间态"从源头上减少"需要传的上下文;运行时摘要作为辅助手段,用于确实需要保留全貌的环节;滑动窗口裁剪尽量少用,因为它可能切断依赖关系。
三、环境准备
为了让代码跑得起来,我们需要一个具体的案例贯穿全文:“竞品技术报告生成 Pipeline”。下面以 LangGraph 为主实现,同时给出 LCEL 和自研轻量实现的对比。
3.1 环境与依赖
1# Python 3.11+
2python -m venv .venv
3source .venv/bin/activate
4
5# 核心依赖
6pip install langgraph>=0.2 langchain langchain-openai
7pip install pydantic>=2.0 tenacity
8
9# 可选:用本地模型跑(降低依赖)
10pip install langchain-ollama
11
💡 模型说明:本文示例默认使用 OpenAI 兼容接口(
OPENAI_API_KEY环境变量)。如果你希望零成本复现,可以把ChatOpenAI换成ChatOllama(本地跑qwen2.5:14b或llama3.1:8b),核心编排逻辑完全不变——这恰好印证了 Pipeline 编排层与 LLM 供应商解耦的设计。
3.2 案例任务定义
我们做一个 三环节流水线,验证 Pipeline 的核心要素:
Agent C:报告撰写
Agent B:要点提炼
Agent A:资料采集
输入:产品名
调搜索工具抓取资料
输出:原始资料列表
输入:原始资料
LLM 提取技术要点
输出:结构化要点
输入:结构化要点
LLM 组织成文
输出:最终报告
为了让代码聚焦编排而不过度膨胀,我把它抽象成一个 “输入分析 → 加工处理 → 输出定稿” 的通用 pipeline,便于你迁移到自己的领域。
四、核心实战:从零搭建串行 Pipeline
这一章是全文的核心,分四步走:定义中间态 → 实现各环节 Agent → 串起流水线 → 运行与验证。
4.1 第一步:定义强类型中间态(Pydantic)
Pipeline 的根基是中间态的 Schema。我们用 Pydantic 定义,让每个环节的输入输出都"有据可查"。
1# state.py —— 定义流水线中间态
2from typing import Any
3from pydantic import BaseModel, Field
4
5class RawMaterial(BaseModel):
6    """环节A输出:采集到的原始资料"""
7    source: str = Field(..., description="资料来源/URL")
8    content: str = Field(..., description="原始文本内容")
9    collected_at: str = Field(..., description="采集时间戳")
10
11class AnalyzedPoint(BaseModel):
12    """环节B输出:提炼后的结构化要点"""
13    key_point: str = Field(..., description="要点标题")
14    evidence: str = Field(..., description="支撑证据/引用")
15    confidence: float = Field(..., ge=0.0, le=1.0, description="置信度0-1")
16
17class FinalReport(BaseModel):
18    """环节C输出:最终定稿报告"""
19    title: str = Field(..., description="报告标题")
20    body: str = Field(..., description="报告正文")
21    sources: list[str] = Field(default_factory=list, description="引用来源列表")
22
为什么要用 Pydantic 而不是裸 dict?
- 强校验:
confidence字段约束在 0~1 之间,后续环节拿到的一定是合法数据,脏数据在入口就被拦截。 - 自文档:每个字段带
description,即使不读代码也能知道这个中间态长什么样。 - 可序列化:Pydantic 模型可以方便地转 JSON 存进 Redis / 数据库,便于跨进程传递和可观测。
4.2 第二步:实现各环节 Agent
每个 Agent 由 System Prompt(角色)+ 模型 + 工具 构成。这里我用 LangGraph StateGraph 的节点(node)函数来实现每个环节。
1# agents.py —— 三个环节的 Agent 节点
2from langchain_openai import ChatOpenAI
3from langchain_core.output_parsers import PydanticOutputParser
4from state import RawMaterial, AnalyzedPoint, FinalReport
5
6llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.2)
7
8# ---------- 环节A:资料采集(模拟,真实项目替换为搜索工具) ----------
9def collect_node(state: dict) -> dict:
10    """把产品名转成一批"原始资料"。真实项目这里应调用 Tavily/SerpAPI 等。"""
11    product = state["product"]
12    # 模拟抓取两份资料的返回 —— 真实场景用工具调用取代
13    materials = [
14        RawMaterial(
15            source=f"https://docs.example.com/{product}",
16            content=f"{product} 官方文档摘要:支持API、Webhooks、多租户...",
17            collected_at="2026-10-04T10:00:00Z",
18        ),
19        RawMaterial(
20            source=f"https://reviews.example.com/{product}",
21            content=f"{product} 用户评测:上手简单,但高级配置门槛较高...",
22            collected_at="2026-10-04T10:00:05Z",
23        ),
24    ]
25    # 中间态:把原始资料列表存进 state
26    return {"raw_materials": materials}
27
1# 环节B:要点提炼 —— 用 LLM 把原始资料提炼成结构化要点
2def analyze_node(state: dict) -> dict:
3    materials = state["raw_materials"]
4    parser = PydanticOutputParser(pydantic_object=AnalyzedPoint)
5
6    prompt = f"""你是资深技术分析师。请从以下原始资料中提炼3个关键要点。
7要求每个要点给出支撑证据和置信度。
8
9原始资料:
10{materials}
11
12{parser.get_format_instructions()}"""
13
14    response = llm.invoke(prompt)
15    points = parser.parse(response.content)
16    # 兼容:LLM 可能一次输出一个或多个,这里存成列表
17    points_list = points if isinstance(points, list) else [points]
18    return {"analyzed_points": points_list}
19
1# 环节C:报告撰写 —— 根据结构化要点组织成文
2def report_node(state: dict) -> dict:
3    points = state["analyzed_points"]
4    parser = PydanticOutputParser(pydantic_object=FinalReport)
5
6    prompt = f"""你是报告撰写专家。请基于以下结构化要点,撰写一份条理清晰的报告。
7
8要点:
9{points}
10
11{parser.get_format_instructions()}"""
12
13    response = llm.invoke(prompt)
14    report = parser.parse(response.content)
15    return {"final_report": report}
16
代码解读:
- 每个节点函数接收
state(整个流水线的共享状态),返回一个 dict,把本环节产出的数据写回 state。 - 环节 B、C 都依赖 LLM 输出 → 用
PydanticOutputParser把 LLM 的文本强转成结构化的中间态,保证下游拿到的类型安全。 - 环节 A 用模拟数据代替真实工具调用,是为了让你先看清编排骨架,不被工具调用细节干扰。
💡 Tool 的作用:在真实项目中,环节 A 的
collect_node应该调用TavilySearchResults(联网搜索)或自研检索工具,让它真正"动手"抓数据。这一步我们在第八章的进阶中补充。
4.3 第三步:用 StateGraph 串起流水线
这是 Pipeline 的核心——编排。LangGraph 的 StateGraph 让我们声明式地把节点连成图。
1# pipeline.py —— 编排串行流水线
2from typing import TypedDict
3from langgraph.graph import StateGraph, END
4from agents import collect_node, analyze_node, report_node
5
6# 定义流水线的全局状态类型(各环节往里面塞中间态)
7class PipelineState(TypedDict, total=False):
8    product: str            # 输入:产品名
9    raw_materials: list     # 环节A产出
10    analyzed_points: list   # 环节B产出
11    final_report: object    # 环节C产出
12
13# 1. 创建状态图
14graph = StateGraph(PipelineState)
15
16# 2. 注册三个环节节点
17graph.add_node("collect", collect_node)
18graph.add_node("analyze", analyze_node)
19graph.add_node("report", report_node)
20
21# 3. 声明串行边:collect -> analyze -> report -> END
22graph.set_entry_point("collect")
23graph.add_edge("collect", "analyze")
24graph.add_edge("analyze", "report")
25graph.add_edge("report", END)
26
27# 4. 编译成可执行对象
28app = graph.compile()
29
30# 5. 运行流水线
31def run_pipeline(product: str) -> FinalReport:
32    result = app.invoke({"product": product})
33    return result["final_report"]
34
35if __name__ == "__main__":
36    report = run_pipeline("Notion AI")
37    print("=== 最终报告标题 ===")
38    print(report.title)
39    print("=== 报告正文 ===")
40    print(report.body)
41    print("=== 引用来源 ===")
42    for s in report.sources:
43        print(" -", s)
44
运行预期输出(示意):
1=== 最终报告标题 ===
2Notion AI 技术能力评估报告
3=== 报告正文 ===
4Notion AI 在文档智能与知识管理场景表现突出,其关键技术点包括...
5=== 引用来源 ===
6 - https://docs.example.com/Notion AI
7 - https://reviews.example.com/Notion AI
8
这一步揭示了 Pipeline 的完整面貌:
1add_node(注册环节)  +  add_edge(定义依赖)  +  compile(编译)  +  invoke(运行)
2
add_node把"Agent 节点"注册进图。add_edge("collect", "analyze")声明依赖关系——这是串行的体现,LangGraph 保证analyze一定在collect之后执行。compile()做静态校验(比如检查有没有悬空的边、有没有环),返回可直接调用的对象。invoke({"product": ...})传入初始状态,返回最终状态。
4.4 第四步:加入失败与重试 —— 让流水线"抗造"
真实的流水线总会遇到 LLM 抽风、工具超时、输出格式错误。Pipeline 工程化的关键一环是容错。LangGraph 提供了 add_node 的重试参数与条件边。
1# pipeline_resilient.py —— 带重试与超时的流水线
2from langgraph.graph import StateGraph, END
3from agents import collect_node, analyze_node, report_node
4
5graph = StateGraph(PipelineState)
6
7# add_node 支持 retry:对超时(TimeoutError)和LLM服务错误重试最多3次
8graph.add_node("collect", collect_node, retry={
9    "max_attempts": 3,                    # 最多重试3次
10    "retry_on": [TimeoutError, ValueError],  # 哪类异常才重试
11    "backoff_factor": 2.0,                # 退避系数:1s -> 2s -> 4s
12})
13graph.add_node("analyze", analyze_node, retry={
14    "max_attempts": 3,
15    "retry_on": [ValueError],
16})
17graph.add_node("report", report_node)
18
19graph.set_entry_point("collect")
20graph.add_edge("collect", "analyze")
21graph.add_edge("analyze", "report")
22graph.add_edge("report", END)
23
24app = graph.compile()
25
26def run_with_timeout(product: str, timeout_sec: int = 120) -> FinalReport:
27    """带整体超时的运行封装"""
28    from langgraph.checkpoint.memory import MemorySaver
29    import asyncio
30
31    # 用 MemorySaver 支持中断/恢复(断点续跑)
32    graph_with_memory = graph.compile(checkpointer=MemorySaver())
33    config = {"recursion_limit": 50, "configurable": {"thread_id": "task-001"}}
34    result = graph_with_memory.invoke({"product": product}, config=config)
35    return result["final_report"]
36
关键点解读:
retry配置:对偶发的TimeoutError(工具超时)和ValueError(输出解析失败)做指数退避重试,而不是一失败就整条流水线报废。MemorySavercheckpoint:把每一步的中间态落盘,支持从断点恢复——如果环节 C 挂了,可以只重跑 C,不必重跑 A、B。recursion_limit:防止出现意外的循环导致无限执行。
⚠️ 注意:重试是"软兜底",不是"万能药"。如果某个环节稳定失败(比如 LLM 始终无法解析输出),重试只会浪费 Token 和时间。应配合第三层兜底——降级方案(见第八章)。
4.5 一次真实运行的完整观测
让我们模拟运行一次 pipeline,看看各环节是怎么串行的,以及我们能从中观察到什么。假设输入 {"product": "Notion AI"},并启用了轻量的耗时埋点(用第八章的 timed_node 装饰器):
1[observability] collect | OK | 812ms   | 2026-10-04T10:00:00.123Z
2[observability] analyze | OK | 2341ms  | 2026-10-04T10:00:02.925Z
3[observability] validate| OK | 45ms    | 2026-10-04T10:00:02.970Z
4[observability] report  | OK | 3109ms  | 2026-10-04T10:00:06.079Z
5流水线总耗时: 6.08s | 总Token: ~5400 | 中间态快照: 4份
6
从这份日志能读出什么?
- 耗时结构:
analyze(2.3s)和report(3.1s)最耗时,因为它们是 LLM 密集环节;collect(0.8s)是工具/模拟调用;validate(45ms)是纯规则校验几乎不耗时。性能瓶颈一眼可定位——如果要优化,优先优化 analyze 和 report。 - 串行总耗时 = 各环节之和:Pipeline 的一个固有特性是总延迟等于每个环节延迟相加。这正是它不适合并行任务的原因。
- Token 分布:可以通过埋点记录每个环节的输入/输出 Token,从而定位"哪一环的提示词最臃肿、最耗钱"。
- 状态流转:4 份快照分别对应输入态、collect 产出、analyze 产出、report 产出,回溯审计非常方便。
这个观测习惯要刻意养成:Pipeline 的性能分析和问题排查,完全依赖这些指标。没有观测,Pipeline 就像一个黑盒——出问题只能猜。
五、进阶:中间态传递的三个实战技巧
中间态传递是 Pipeline 工程化的分水岭。下面三个技巧能显著提升系统的健壮性与可维护性。
5.1 技巧一:用"不可变快照"做可观测与回滚
前面提到中间态应该设计为不可变快照。也就是说,每经过一个环节,我们新建一份中间态,而不是原地修改。
1# versioned_state.py —— 版本化中间态
2from dataclasses import dataclass, field
3from datetime import datetime, timezone
4import uuid
5
6@dataclass
7class VersionedSnapshot:
8    """一份不可变的中间态快照"""
9    version: str                 # 版本号(uuid)
10    step: str                    # 由哪个环节产生
11    payload: dict                # 该环节的结构化产出
12    created_at: str = field(default_factory=lambda: datetime.now(timezone.utc).isoformat())
13    parent: str | None = None    # 前一个快照的版本号,形成不可变链条
14
15class PipelineLog:
16    """用链表形式记录整个流水线的快照链,支持审计与回滚"""
17    def __init__(self):
18        self.snapshots: dict[str, VersionedSnapshot] = {}
19
20    def append(self, step: str, payload: dict, parent: str | None = None) -> str:
21        ver = str(uuid.uuid4())
22        snap = VersionedSnapshot(version=ver, step=step, payload=payload, parent=parent)
23        self.snapshots[ver] = snap
24        return ver   # 返回快照版本号,供下游引用
25
26    def chain(self, end_version: str) -> list[VersionedSnapshot]:
27        """沿着 parent 回溯整条链路,用于审计"""
28        chain = []
29        cur = end_version
30        while cur:
31            snap = self.snapshots[cur]
32            chain.append(snap)
33            cur = snap.parent
34        return list(reversed(chain))
35
为什么不可变这么重要?
- 可审计:每个环节"基于什么、产出什么"一目了然,出问题能精确定位到是哪个环节。
- 可回滚:如果环节 C 产出的报告质量差,我们能回滚到环节 B 的快照重试,而不必重跑 A。
- 并发安全:多个环节之间不共享可变对象,天然避免竞态条件。
5.2 技巧二:显式传递 vs 隐式传递的选择
这是 Pipeline 设计里争论最多的问题:下一个 Agent 到底该收到什么?
| 传递方式 | 做法 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 显式传递(推荐) | 把前序环节的结构化中间态作为输入传给下游 | Token省、可控、可校验 | 丢失部分上下文细节 | 环节职责清晰、数据可结构化 |
| 隐式传递 | 把整个对话历史 / 所有原始材料传给下游 | 上下文完整、Agent 更有"全局观" | Token爆炸、易被噪声干扰、不可校验 | 环节需要全量上下文做判断 |
实践建议:默认用显式传递,只在确实需要全量上下文时按需引入原始数据。例如环节 B 提炼要点后,环节 C 写报告时可以同时收到"结构化要点"和"原始资料"两份数据——但要把结构化要点放在高优先级位置,引导 LLM 优先依据它。
1# 混合传递示例:下游收到"结构化要点"+"原始资料原文"
2def report_node_hybrid(state: dict) -> dict:
3    points = state["analyzed_points"]
4    raw = state["raw_materials"]      # 全量原文,仅作补充参考
5
6    # 精心设计 prompt:让 LLM 优先用结构化要点,原文仅作佐证
7    prompt = f"""请基于【结构化要点】撰写报告,这些要点是核心依据。
8【原始资料】仅用于补充细节、提供引用,不可偏离要点结论。
9
10【结构化要点】:
11{points}
12
13【原始资料】:
14{raw}"""
15    ...
16
5.3 技巧三:Schema 版本演进与向后兼容
流水线上线后,中间态的字段可能演进(比如给 AnalyzedPoint 加一个 category 字段)。如果直接改 Schema,已经落库的历史记录和正在运行的旧 Agent 会解析失败。
处理办法是版本化 + 缺省值:
1from pydantic import BaseModel, Field
2
3class AnalyzedPointV2(BaseModel):
4    """V2:新增 category 字段,但用默认值保证向后兼容"""
5    key_point: str = Field(..., description="要点标题")
6    evidence: str = Field(..., description="支撑证据")
7    confidence: float = Field(..., ge=0.0, le=1.0, description="置信度")
8    category: str = Field(default="general", description="要点分类,V2新增")
9
10    # 兼容旧数据:提供 from_v1 转换方法
11    @classmethod
12    def from_v1(cls, v1) -> "AnalyzedPointV2":
13        return cls(
14            key_point=v1.key_point,
15            evidence=v1.evidence,
16            confidence=v1.confidence,
17            category="general",   # 旧数据默认归为 general
18        )
19
要点:新增字段给默认值,读取时兼容旧记录;拆字段(一个拆成两个)则提供迁移方法。这样流水线升级时不会破坏历史状态。
六、方案对比:LangGraph vs LCEL vs 自研轻量编排
实现 Pipeline 不止一种方式。本章把三类主流方案放在同一尺度下对比,帮你做选型决策。
6.1 LangChain LCEL 的 Pipeline
LangChain 的 LCEL(LangChain Expression Language)用管道符 | 串联,语法极简:
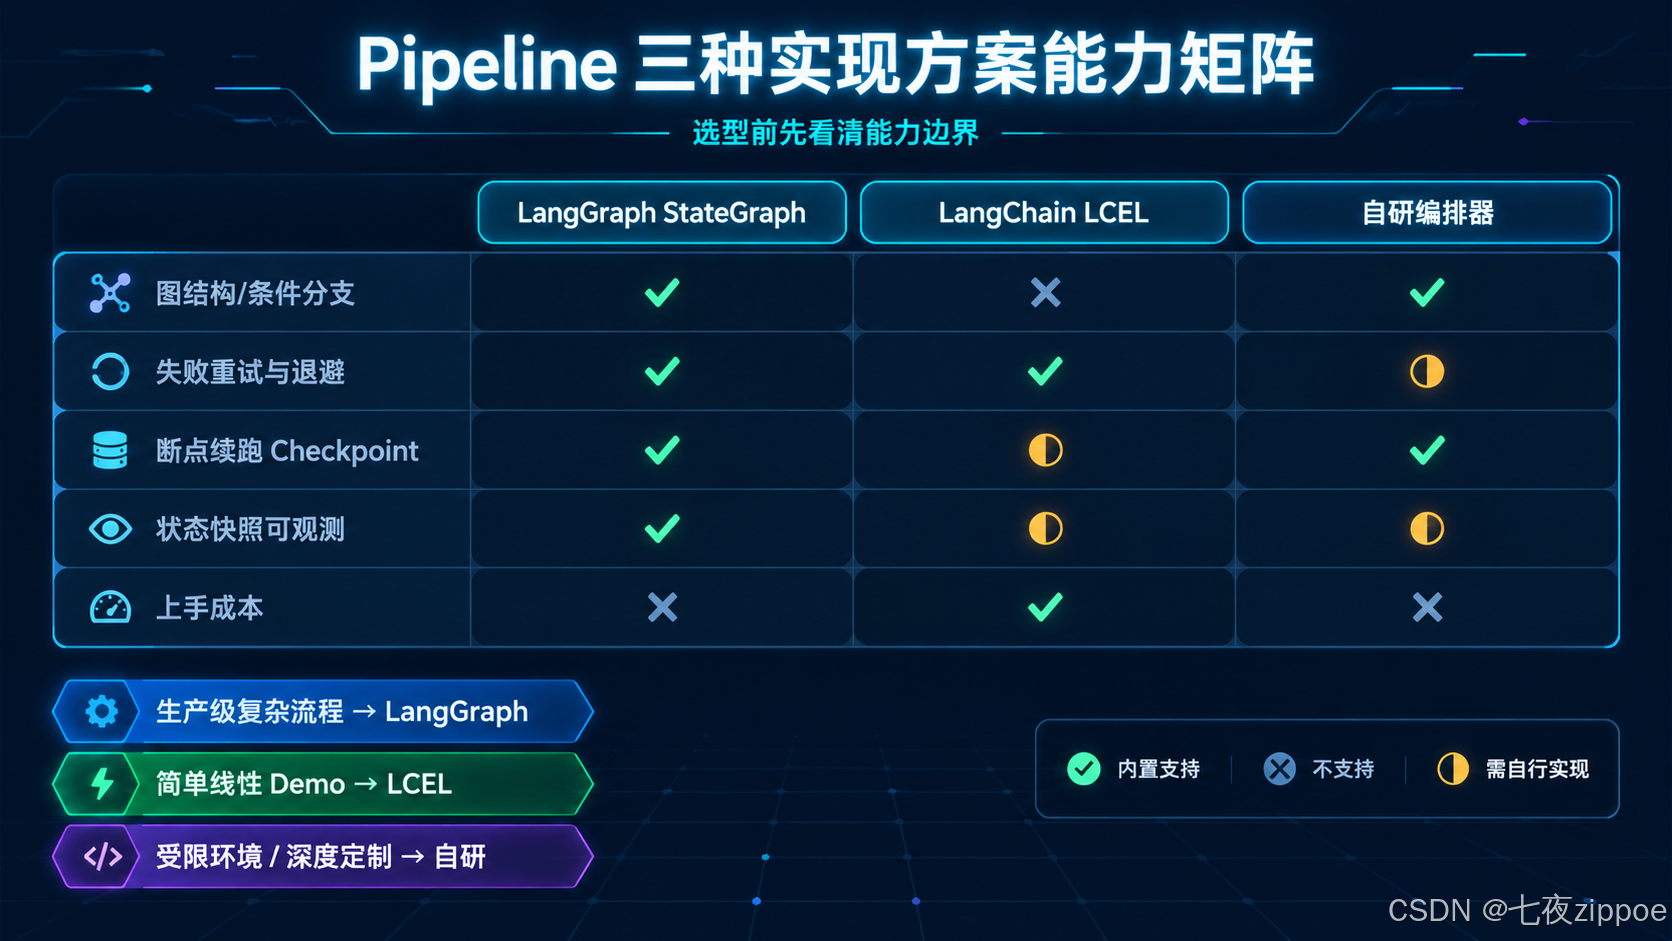
图2:LangGraph、LCEL 与自研编排的能力矩阵对比——选型前的取舍依据
1# lcel_version.py —— 用 LCEL 串起三个 Agent
2from langchain_openai import ChatOpenAI
3from langchain_core.prompts import ChatPromptTemplate
4from langchain_core.output_parsers import StrOutputParser
5
6llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.2)
7
8# 三个环节,各自独立 prompt
9collect_prompt = ChatPromptTemplate.from_template("你是采集员:{product}")
10analyze_prompt = ChatPromptTemplate.from_template("你是分析师,基于以下资料提炼要点:{data}")
11report_prompt = ChatPromptTemplate.from_template("你是写手,基于要点写报告:{points}")
12
13# 用 | 直接串成流水线,中间产出用 dict 显式命名
14pipeline = (
15    collect_prompt
16    | llm
17    | {"data": lambda x: x.content}        # 显式传递:把上一步输出命名为 data
18    | analyze_prompt
19    | llm
20    | {"points": lambda x: x.content}      # 显式传递:命名为 points
21    | report_prompt
22    | llm
23    | StrOutputParser()
24)
25
26result = pipeline.invoke({"product": "Notion AI"})
27print(result)
28
LCEL 优点:语法极简、上手快、适合线性且中间态简单的流水线。
LCEL 局限:只适合纯线性且中间态简单的流程。一旦要加条件分支、循环、失败重试,LCEL 就力不从心了——它的 | 无法表达图结构。
6.2 自研轻量编排:何时需要,怎么设计
在某些受限场景(不允许引第三方框架、需要深度定制、团队已有成熟的状态管理),自研是合理选择。一个最小可用的自研 Pipeline 编排器:
1# minimal_orchestrator.py —— 自研最小串行编排器
2class PipelineStep:
3    """定义流水线中的一个环节"""
4    def __init__(self, name, func, retries=1, timeout=None):
5        self.name = name
6        self.func = func          # 可调用对象:接收 state,返回 dict
7        self.retries = retries
8        self.timeout = timeout
9
10class Pipeline:
11    """自研串行流水线编排器"""
12    def __init__(self):
13        self.steps: list[PipelineStep] = []
14
15    def add_step(self, step: PipelineStep) -> "Pipeline":
16        self.steps.append(step)
17        return self
18
19    def run(self, initial_state: dict) -> dict:
20        state = dict(initial_state)   # 复制,保持中间态不可变思想
21        for step in self.steps:
22            for attempt in range(1, step.retries + 1):
23                try:
24                    # 执行环节,产出并入状态
25                    output = step.func(state)
26                    state.update(output)
27                    break
28                except Exception as e:
29                    if attempt == step.retries:
30                        raise RuntimeError(f"环节 {step.name} 失败: {e}")
31                    print(f"[warn] {step.name} 第{attempt}次失败,重试...")
32        return state
33
34# 使用示例
35pipeline = Pipeline()
36pipeline.add_step(PipelineStep("collect", collect_node, retries=3))
37pipeline.add_step(PipelineStep("analyze", analyze_node, retries=3))
38pipeline.add_step(PipelineStep("report", report_node))
39
40final_state = pipeline.run({"product": "Notion AI"})
41print(final_state["final_report"].body)
42
自研的优点:零外部依赖、完全可定制、便于理解;缺点:需要自己实现重试、超时、checkpoint、可观测等生产级能力——这些 LangGraph 已经内置。
6.3 三方案横向对比
| 维度 | LangGraph StateGraph | LangChain LCEL | 自研编排器 |
|---|---|---|---|
| 复杂度 | 中(需理解图概念) | 低(管道符) | 中(需自己造轮子) |
| 图结构支持 | ✅ 完整(分支/循环/条件) | ❌ 仅线性 | 自己实现 |
| 失败重试 | ✅ 内置 retry | ❌ 需手动 | 自己实现 |
| checkpoint/断点续跑 | ✅ 内置 MemorySaver | ❌ | 自己实现 |
| 可观测性 | ✅ 内置状态快照 | 弱 | 自己实现 |
| 上手成本 | 中 | 最低 | 高(生产级) |
| 适合场景 | 生产级复杂流程 | 简单线性 Demo | 受限环境/深度定制 |
选型建议:
- 生产级、流程可能变复杂 → 选 LangGraph(功能最全,能平滑升级到 MapReduce/Supervisor)。
- 快速验证、纯线性、中间态简单 → 选 LCEL(上手最快)。
- 环境受限 / 需完全掌控 / 教学 → 选 自研(但务必补齐重试与可观测)。
6.4 真实业务案例:内容审核流水线
为了让理论落到业务,我们看一个真实的 Pipeline 应用:内容安全审核系统。它比"竞品报告"更贴近生产,也更直观地展示了 Pipeline 的工程价值。
审核流水线
命中高危
疑似/放行
Agent 1
(结构化提取)
抽文本/图片/链接
Agent 2
(违规初筛)
规则+轻量模型
Agent 3
(深度研判)
语义分析+人审队列
Agent 4
(复核定级)
定级+留存证据
记录证据库
这条流水线的关键设计:
- 每个环节的中间态都是强类型的:
ExtractedContent(提取的结构化内容)、ScreeningVerdict(初筛结论:高危/疑似/放行)、ReviewDecision(最终定级与证据)。 - 条件分支真实发生:初筛命中的高危内容进入深度研判分支,未进入的走复核定级。
- 可观测与审计:每一份审核结果是不可变快照,存进证据库,满足合规审计要求。
这个案例的价值在于:它展示了 Pipeline 不只是"串一串 Agent",而是把规则引擎、轻量模型、强模型、人工审核有机结合在一起的编排骨架。规则初筛节省成本、强模型深度研判保证质量、人工审核兜底——每一环都是独立的可优化单元。
这就是 Pipeline 在生产环境中的典型形态:不追求单点全能,而是把不同能力的"工人"排成一条可靠的生产线。
七、适用边界与风险提示 ⚠️
Pipeline 虽简单,但它不是银弹。明确它的适用范围与陷阱,能让你的架构决策更清醒。
7.1 Pipeline 适合什么
✅ 天然线性的流程:数据采集 → 清洗 → 分析 → 报告,这类有明确先后依赖的任务,Pipeline 是最自然的选择。
✅ 环节职责清晰:每个环节只需要一个角色、一套工具就能独立完成,不需要跨环节协商。
✅ 中间过程可结构化:环节间的产物能表达成结构化中间态(列表、JSON、对象),方便校验与传递。
✅ 需要可观测、可回滚:希望每个环节都能单独追踪、单独重跑,Pipeline 的中间态快照天然支持。
7.2 Pipeline 不适合什么
❌ 需要回环协商的任务:如果后一个环节经常要让前一个环节"重新查一遍、rephrase",Pipeline 的线性结构会很痛苦。此时应选 Supervisor 模式。
❌ 子任务相互独立、可并行:如果多个子任务之间没有依赖,却用 Pipeline 串起来,会白白增加延迟。此时应选 MapReduce(第23篇会讲)。
❌ 中间态无法结构化:如果环节的产出是难以用 Schema 表达的自由内容(如开放式的创意发散),Pipeline 强制结构化的优势反而成了负担。
❌ 短小单一的任务:如果任务一个 Agent 就能搞定,硬拆成流水线只会增加复杂度与 Token 开销——过度设计。
7.3 三大典型陷阱
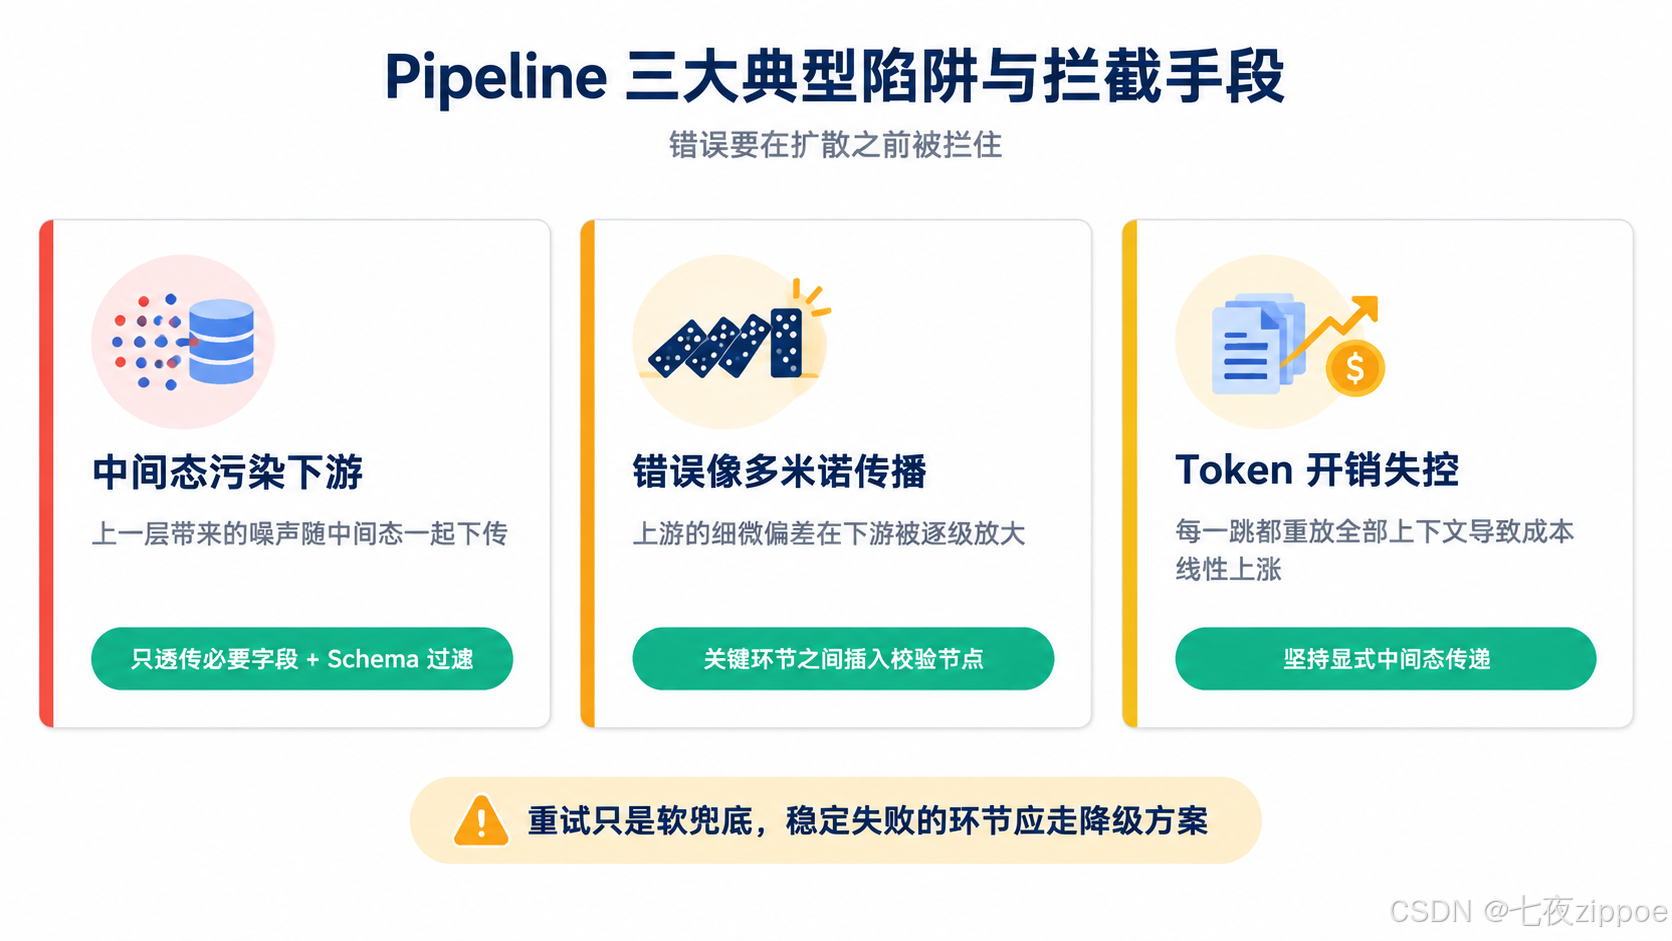
图3:Pipeline 三大典型陷阱与对应拦截手段——污染、错误传播、Token 膨胀
陷阱一:中间态"污染"下游
环节 A 采集的原始数据带着大量噪声,直接传给环节 B 导致 B 被干扰。解决:每个环节只透传必要的字段,用显式传递 + Schema 过滤噪声。
陷阱二:错误传播像多米诺骨牌
环节 A 输出一个微妙错误,会在 B、C 被放大,最终报告完全跑偏。解决:在关键环节之间加校验节点(见第八章),让校验 Agent 或规则把错误拦截在源头。
陷阱三:Token 开销失控
很多开发者偷懒把"整个对话历史"传给每个环节,导致每跳都重放全部上下文,Token 线性膨胀。解决:坚持显式中间态传递,只在必要时引入原始数据。
八、进阶:让 Pipeline 更工程化
到这里,Pipeline 已经能跑起来了。但要从"能跑"到"生产级",还需要补三块拼图:校验环节、Mock 测试策略、观测与监控。
8.1 加入校验环节:在错误扩散前拦截
在关键环节之间插入校验器,用规则或轻量 LLM 检查中间态质量。
1# validator.py —— 在环节B产出后校验要点质量
2from pydantic import ValidationError
3
4def validate_points(state: dict) -> dict:
5    """校验环节B的输出:要点数量、置信度、是否有证据"""
6    points = state.get("analyzed_points", [])
7    errors = []
8
9    if not points:
10        errors.append("要点为空")
11    if len(points) < 2:
12        errors.append(f"要点过少({len(points)}条),至少需要2条")
13
14    for p in points:
15        if p.confidence < 0.3:
16            errors.append(f"要点置信度过低: {p.key_point}")
17        if not p.evidence:
18            errors.append(f"要点缺少证据: {p.key_point}")
19
20    if errors:
21        # 标记质量不合格,触发兜底分支
22        return {"validation_passed": False, "validation_errors": errors,
23                "retry_attempt": state.get("retry_attempt", 0) + 1}
24    return {"validation_passed": True, "validation_errors": []}
25
把这个校验器作为条件分支接入流水线:校验不通过就重跑环节 B(最多 N 次),再不行就走降级方案。
1# 条件边:校验不通过则回退到 analyze,通过则继续
2from langgraph.graph import MessageGraph, END
3
4graph.add_node("validate", validate_points)
5graph.add_edge("analyze", "validate")
6
7# 使用条件边:validate 的结果决定去 analyze 还是 report
8def route_after_validate(state: dict) -> str:
9    if not state.get("validation_passed", True):
10        # 重试过多则降级,否则回退重跑 analyze
11        if state.get("retry_attempt", 0) >= 2:
12            return "degrade"
13        return "analyze"
14    return "report"
15
16graph.add_conditional_edges("validate", route_after_validate, {
17    "analyze": "analyze",
18    "report": "report",
19    "degrade": "degrade_node",
20})
21
校验环节的价值:把质量问题从"隐性腐烂"变成"显性可拦截",大大降低错误往下游扩散的概率。
8.2 Mock 测试:不依赖真实 LLM 的回归测试
生产级流水线必须有测试。经验法则是:用 Mock 的 LLM 做逻辑测试,用真实 LLM 做集成测试。
1# test_pipeline.py —— 用 MockLLM 做单元测试
2class MockLLM:
3    """模拟 LLM,返回固定输出,用于测试编排逻辑"""
4    def invoke(self, prompt: str):
5        # 根据环节返回预设结果,测试时无需真实调用
6        if "分析师" in prompt:
7            return type("R", (), {"content": '{"key_point": "测试要点", '
8                                            '"evidence": "测试证据", '
9                                            '"confidence": 0.9}'})()
10        if "报告撰写" in prompt:
11            return type("R", (), {"content": '{"title": "测试报告", '
12                                            '"body": "测试正文", '
13                                            '"sources": ["src1"]}'})()
14        raise ValueError("未知环节")
15
16# monkeypatch: 测试时把真实 llm 替换为 MockLLM
17def test_pipeline_runs_end_to_end(monkeypatch):
18    import agents
19    monkeypatch.setattr(agents, "llm", MockLLM())
20    from pipeline import run_pipeline
21    report = run_pipeline("TestProduct")
22    assert report.title == "测试报告"
23    assert report.body == "测试正文"
24
Mock 测试的价值:把编排逻辑(节点顺序、状态流转、中间态结构)与 LLM 的随机性解耦。CI 里跑 Mock 测试毫秒级完成,确保重构不破坏流水线结构;真正的 LLM 集成测试单独放慢速 ci。
8.3 观测与监控:Pipeline 的可观测性
生产环境要清楚"每个环节花了多久、花了多少 Token、失败了吗"。三种手段:
- 日志埋点:每个环节进入/退出时记录时间戳与状态大小。
- 结构化指标:用 Prometheus 上报环节延迟、Token 消耗、成功率。
- 中间态快照审计:用 5.1 节的版本化快照,把每个环节的输入输出落库,支持事后回溯。
1# observability.py —— 轻量观测埋点
2import time
3from datetime import datetime, timezone
4
5def timed_node(name):
6    """装饰器:给节点加耗时与状态监控"""
7    def decorator(func):
8        def wrapper(state):
9            start = time.perf_counter()
10            try:
11                out = func(state)
12                status = "OK"
13            except Exception as e:
14                status = f"ERR:{type(e).__name__}"
15                raise
16            finally:
17                elapsed = (time.perf_counter() - start) * 1000
18                print(f"[observability] {name} | {status} | {elapsed:.0f}ms | "
19                      f"{datetime.now(timezone.utc).isoformat()}")
20            return out
21        return wrapper
22    return decorator
23
24# 使用:@timed_node("collect") 装饰各环节节点
25
8.4 降级方案:Pipeline 的最后一层兜底
当重试(soft fallback)也无效时,需要降级方案(graceful degradation)。原则是:宁可给一个次优但不错误的答案,也不要让整条流水线崩溃或给一个荒谬的结果。 三种常用的降级策略:
| 降级策略 | 做法 | 适用场景 |
|---|---|---|
| 缓存兜底 | 从缓存/历史记录返回相似结果 | 任务有可复用的历史答案 |
| 快速路径 | 跳过耗时的 LLM 环节,用规则/模板生成保守答案 | 对时效性要求高、对质量要求低 |
| 人工接管 | 把失败任务转入人工处理队列 | 高风险场景(如审核、金融) |
1# degrade.py —— 降级路由示例
2from langgraph.graph import End
3
4def degrade_node(state: dict) -> dict:
5    """降级节点:生成一个保守但正确的兜底结果"""
6    product = state["product"]
7    fallback = FinalReport(
8        title=f"{product} 分析报告(降级版)",
9        body="由于分析环节异常,本报告仅提供基础信息,详细分析请人工处理。",
10        sources=[],
11    )
12    state["final_report"] = fallback
13    state["degraded"] = True     # 标记降级,供上层感知
14    return state
15
16# 在条件路由里接入降级分支(之前已定义 route_after_validate)
17"degrade": "degrade"
18
降级与重试是配套的:先重试若干次,仍失败则走降级,降级不可用再抛异常。这样最大程度保证系统的可用性。
8.5 与 LLM 供应商解耦:换个模型不改代码
生产级 Pipeline 应该做到换模型不重构。手段是抽象一个统一的 LLM 接口:
1# llm_factory.py —— 按需选择模型供应商,代码零改
2from langchain_openai import ChatOpenAI
3from langchain_ollama import ChatOllama
4
5_llm = None
6
7def get_llm():
8    global _llm
9    if _llm is None:
10        provider = os.getenv("LLM_PROVIDER", "openai").lower()
11        if provider == "openai":
12            _llm = ChatOpenAI(model=os.getenv("OPENAI_MODEL", "gpt-4o-mini"), temperature=0.2)
13        elif provider == "ollama":
14            _llm = ChatOllama(model=os.getenv("OLLAMA_MODEL", "qwen2.5:14b"), temperature=0.2)
15        else:
16            raise ValueError(f"未知 LLM_PROVIDER: {provider}")
17    return _llm
18
配合环境变量,就能在不改一行编排代码的情况下,在云端强模型与本地轻模型之间切换——这对成本控制与离线部署非常有价值。
九、总结
回到文章开头的问题:为什么需要 Pipeline 模式? 因为现实中的复杂任务,往往可以由一组职责单一、有先后依赖的 Agent 协作完成——而 Pipeline 正是把这种协作形式化、工程化的基础范式。
我们这一路走下来,可以提炼出三个核心认知:
- 分工创造效率。把一个大任务拆成"采集 → 提炼 → 撰写"等多个职责单一的环节,每个 Agent 只做最擅长的事,不仅更稳,也更容易优化、复用和定位问题。
- 中间态是工程化的灵魂。Pipeline 的本质不是"把 Agent 连起来",而是用强类型的中间态把环节解耦。显式传递、不可变快照、Schema 版本化,这三个技巧决定了流水线能否撑住生产压力。
- 编排层与 Agent 层要分离。编排器(状态图、条件边、重试、checkpoint)负责"流程怎么走",Agent 负责"这一环怎么做"。两者解耦,Pipeline 才能平滑演进到更复杂的 MapReduce、Supervisor 模式。
选型速览:生产级复杂流程用 LangGraph;简单线性 Demo 用 LCEL;受限环境或深定制则自研——但务必补齐重试、校验与可观测。
作为本系列"多 Agent 协作架构"的开篇,Pipeline 是理解后续模式的地基:下一篇(第 23 篇)我们将探讨 MapReduce 模式,看如何在 Pipeline 的骨架上引入并行扇出与结果聚合;再之后是 Supervisor 模式,解决任务动态路由的问题。 建议你把本文的中间态设计、校验与观测思路带过去,它们在任何协作模式下都通用。
落地自检清单(Checklist)
交付前,对照下面的清单逐项确认你的 Pipeline 是否达标:
- ✅ 每个环节职责单一,System Prompt 100~300 字,工具 2~5 个
- ✅ 中间态使用强类型 Schema(Pydantic),字段有校验约束
- ✅ 采用显式中间态传递,不把整个对话历史甩给下游
- ✅ 关键环节之间配置了校验节点(验证质量,拦截错误扩散)
- ✅ 配置了重试(指数退避)与超时,以及降级方案
- ✅ 启动 MemorySaver checkpoint,支持断点续跑
- ✅ 接入观测埋点(耗时、Token、状态快照)
- ✅ 中间态为不可变快照,支持审计与回滚
常见问题(FAQ)
Q1:Pipeline 里的 Agent 需要不同的模型吗?
不一定。环节 A(采集)可能需要更强的工具调用能力,环节 C(撰写)可能需要更强的生成能力,但这不是硬性要求。先用统一的模型跑通,再根据观测数据按需为瓶颈环节升级模型,是更务实的做法。
Q2:中间态要存到独立的存储(Redis/DB)吗?
视规模而定。单机、一次性任务用内存即可;跨节点、需要断点续跑或审计,则建议持久化到 Redis 或对象存储。注意给快照设置 TTL,避免无限膨胀。
Q3:Pipeline 会不会比单 Agent 更慢?
是。串行总延迟 = 各环节延迟之和,天然比单 Agent 更慢。但 Pipeline 换来了更强的稳定性、可观察性与复用性。若对延迟极度敏感,可考虑把独立性强的环节并行化——那就是 MapReduce 模式的范畴了。
参考资料
- LangGraph 官方文档 —— StateGraph、Checkpointer、retry 机制:https://langchain-ai.github.io/langgraph/
- LangChain LCEL 表达式语言文档:https://python.langchain.com/docs/concepts/lcel/
- Pydantic V2 官方文档(字段约束与版本迁移):https://docs.pydantic.dev/
- Anthropic —— Building effective agents(多 Agent 设计模式综述):https://www.anthropic.com/research/building-effective-agents
- LangGraph 多 Agent 协作架构示例(Supervisor / MapReduce 系列):https://langchain-ai.github.io/langgraph/tutorials/multi\_agent/
参考文档
- Primers 编程伙伴/Bash/帮助手册/source
- Primers 编程伙伴/Bash/帮助手册/install
- Primers 编程伙伴/Python/内建函数/str
- Primers 编程伙伴/Python/内建函数/float
- Primers 编程伙伴/Python/内建函数/list
- Primers 编程伙伴/Python/内建函数/dict
- Primers 编程伙伴/Python/内建函数/isinstance
- Primers 编程伙伴/Python/内建函数/object
- Primers 编程伙伴/Python/内建函数/compile
- Primers 编程伙伴/Python/内建函数/print
- Primers 编程伙伴/Python/内建函数/int
- Primers 编程伙伴/Python/内建函数/reversed
- Primers 编程伙伴/Python/内建函数/classmethod
- Primers 编程伙伴/Python/内建函数/range
- Primers 编程伙伴/Python/内建函数/len
- Primers 编程伙伴/Python/内建函数/type
- Primers 编程伙伴/Python/内建函数/setattr


