🔥承渊政道:个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统与网络知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》 《MySQL数据库学习》 《Python知识内容》 《cpolar知识学习》
✨逆境不吐心中苦,顺境不忘来时路!✨
🎬 博主简介:
至此,你掌握了编写组织有序而易于使用的程序所需的基本技能,该考虑让程序目标更明确、用途更大了.在本文中,你将学习处理文件,让程序能够快速地分析大量的数据;你将学习错误处理,避免程序在面对意外情形时崩溃;你将学习异常,它们是Python创建的特殊对象,用于管理程序运行时出现的错误;你还将学习模块
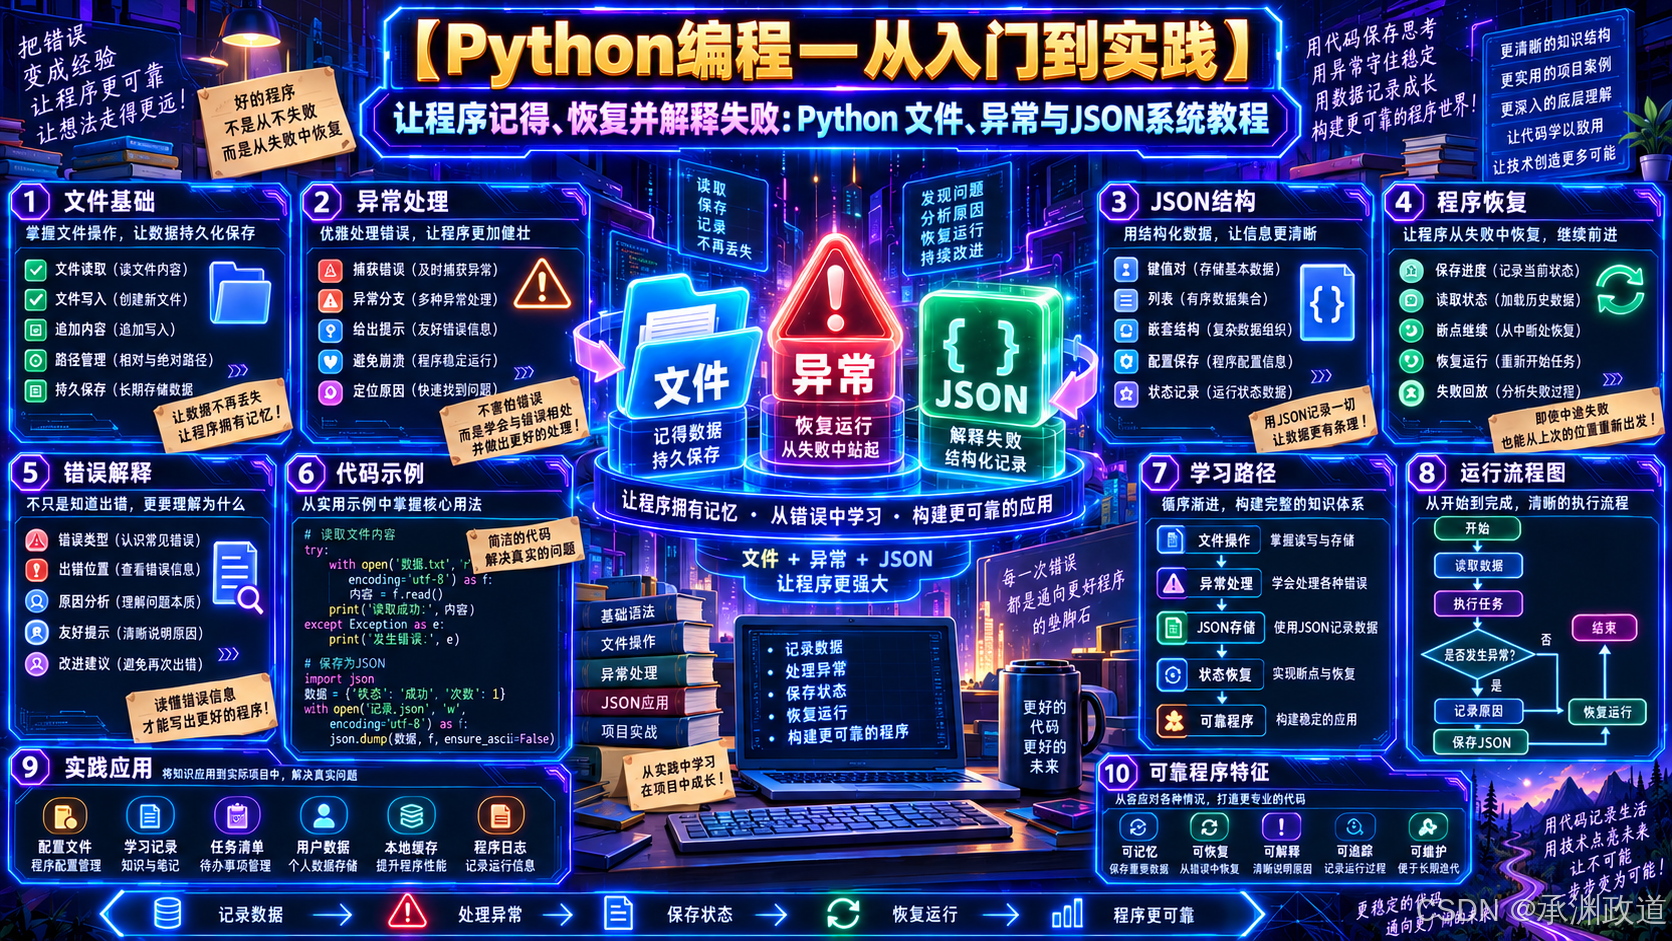
json,它让你能够保存用户数据,以免在程序停止运行后丢失.学习处理文件和保存数据可让你的程序使用起来更容易:用户将能够选择输入什么样的数据,以及在什么时候输入;用户使用你的程序做一些工作后,可将程序关闭,以后再接着往下做.学习处理异常可帮助你应对文件不存在的情形,以及处理其他可能导致程序崩溃的问题.这让你的程序在面对错误的数据时更健壮——不管这些错误数据源自无意的错误,还是源自破坏程序的恶意企图.你在本文学习的技能可提高程序的适用性、可用性和稳定性.
目录
- 1.从文件中读取数据
-
- 1.1读取整个文件
- 1.2文件路径
- 1.3逐行读取
- 1.4创建一个包含文件各行内容的列表
- 1.5使用文件的内容
- 1.6包含一百万位的大型文件
- 1.7圆周率值中包含你的生日吗
- 2.写入文件
-
- 2.1写入空文件
- 2.2写入多行
- 2.3附加到文件
- 3.异常
-
- 3.1处理ZeroDivisionError异常
- 3.2使用try-except代码块
- 3.3使用异常避免崩溃
- 3.4else代码块
- 3.5处理FileNotFoundError异常
- 3.6分析文本
- 3.7使用多个文件
- 3.8失败时一声不吭
- 3.9决定报告哪些错误
- 4.存储数据
-
- 4.1使用json.dump()和json.load()
- 4.2保存和读取用户生成的数据
- 4.3重构
- 5.小结
1.从文件中读取数据
文本文件可存储的数据量多得难以置信:天气数据、交通数据、社会经济数据、文学作品等.每当需要分析或修改存储在文件中的信息时,读取文件都很有用,对数据分析应用程序来说尤其如此.例如,你可以编写一个这样的程序:读取一个文本文件的内容,重新设置这些数据的格式并将其写入文件,让浏览器能够显示这些内容.
要使用文本文件中的信息,首先需要将信息读取到内存中.为此,你可以一次性读取文件的全部内容,也可以以每次一行的方式逐步读取.
1.1读取整个文件
要读取文件,需要一个包含几行文本的文件.下面首先来创建一个文件,它包含精确到小数点后30位的圆周率值,且在小数点后每10位处都换行:
13.1415926535
2  8979323846
3  2643383279
4
下面的程序打开并读取这个文件,再将其内容显示到屏幕上:
file_reader.py
1with open('pi_digits.txt') as file_object:
2    contents = file_object.read()
3    print(contents)
4
在这个程序中,第1行代码做了大量的工作.我们先来看看函数open().要以任何方式使用文件——哪怕仅仅是打印其内容,都得先打开文件,这样才能访问它.函数open()接受一个参数:要打开的文件的名称.Python在当前执行的文件所在的目录中查找指定的文件.在这个示例中,当前运行的是file_reader.py,因此Python在file_reader.py所在的目录中查找pi_digits.txt.函数open()返回一个表示文件的对象.在这里,open('pi_digits.txt')返回一个表示文件pi_digits.txt的对象;Python将这个对象存储在我们将在后面使用的变量中.
关键字with在不再需要访问文件后将其关闭.在这个程序中,注意到我们调用了open(),但没有调用close();你也可以调用open()和close()来打开和关闭文件,但这样做时,如果程序存在bug,导致close()语句未执行,文件将不会关闭.这看似微不足道,但未妥善地关闭文件可能会导致数据丢失或受损.如果在程序中过早地调用close(),你会发现需要使用文件时它已关闭(无法访问),这会导致更多的错误.并非在任何情况下都能轻松确定关闭文件的恰当时机,但通过使用前面所示的结构,可让Python去确定:你只管打开文件,并在需要时使用它,Python自会在合适的时候自动将其关闭.
有了表示pi_digits.txt的文件对象后,我们使用方法read()(前述程序的第2行)读取这个文件的全部内容,并将其作为一个长长的字符串存储在变量contents中.这样,通过打印contents的值,就可将这个文本文件的全部内容显示出来:
13.1415926535
2  8979323846
3  2643383279
4
相比于原始文件,该输出唯一不同的地方是末尾多了一个空行.为何会多出这个空行呢?因为read()到达文件末尾时返回一个空字符串,而将这个空字符串显示出来时就是一个空行.要删除多出来的空行,可在print语句中使用rstrip():
1with open('pi_digits.txt') as file_object:
2    contents = file_object.read()
3    print(contents.rstrip())
4
前面说过,Python方法rstrip()删除(剥除)字符串末尾的空白.现在,输出与原始文件的内容完全相同:
13.1415926535
2  8979323846
3  2643383279
4
1.2文件路径
当你将类似pi_digits.txt这样的简单文件名传递给函数open()时,Python将在当前执行的文件(即.py程序文件)所在的目录中查找文件.
根据你组织文件的方式,有时可能要打开不在程序文件所属目录中的文件.例如,你可能将程序文件存储在了文件夹python_work中,而在文件夹python_work中,有一个名为text_files的文件夹,用于存储程序文件操作的文本文件.虽然文件夹text_files包含在文件夹python_work中,但仅向open()传递位于该文件夹中的文件的名称也不可行,因为Python只在文件夹python_work中查找,而不会在其子文件夹text_files中查找.要让Python打开不与程序文件位于同一个目录中的文件,需要提供文件路径,它让Python到系统的特定位置去查找.
由于文件夹text_files位于文件夹python_work中,因此可使用相对文件路径来打开该文件夹中的文件.相对文件路径让Python到指定的位置去查找,而该位置是相对于当前运行的程序所在目录的.在Linux和OS X中,你可以这样编写代码:
1with open('text_files/filename.txt') as file_object:
2
这行代码让Python到文件夹python_work下的文件夹text_files中去查找指定的.txt文件.在Windows系统中,在文件路径中使用反斜杠(\)而不是斜杠(/):
1with open('text_files\filename.txt') as file_object:
2
你还可以将文件在计算机中的准确位置告诉Python,这样就不用关心当前运行的程序存储在什么地方了.这称为绝对文件路径.在相对路径行不通时,可使用绝对路径.例如,如果text_files并不在文件夹python_work中,而在文件夹other_files中,则向open()传递路径'text_files/filename.txt'行不通,因为Python只在文件夹python_work中查找该位置.为明确地指出你希望Python到哪里去查找,你需要提供完整的路径.
绝对路径通常比相对路径更长,因此将其存储在一个变量中,再将该变量传递给open()会有所帮助.在Linux和OS X中,绝对路径类似于下面这样:
1file_path = '/home/ehmatthes/other_files/text_files/filename.txt'
2with open(file_path) as file_object:
3
而在Windows系统中,它们类似于下面这样:
1file_path = 'C:\Users\ehmatthes\other_files\text_files\filename.txt'
2with open(file_path) as file_object:
3
通过使用绝对路径,可读取系统任何地方的文件.就目前而言,最简单的做法是,要么将数据文件存储在程序文件所在的目录,要么将其存储在程序文件所在目录下的一个文件夹(如text_files)中.
1.3逐行读取
读取文件时,常常需要检查其中的每一行:你可能要在文件中查找特定的信息,或者要以某种方式修改文件中的文本.例如,你可能要遍历一个包含天气数据的文件,并使用天气描述中包含字样sunny的行.在新闻报道中,你可能会查找包含标签<headline>的行,并按特定的格式设置它.
要以每次一行的方式检查文件,可对文件对象使用for循环:
file_reader.py
1filename = 'pi_digits.txt'  # ❶
2
3with open(filename) as file_object:  # ❷
4    for line in file_object:  # ❸
5       print(line)
6
在❶处,我们将要读取的文件的名称存储在变量filename中,这是使用文件时一种常见的做法.由于变量filename表示的并非实际文件——它只是一个让Python知道到哪里去查找文件的字符串,因此可轻松地将'pi_digits.txt'替换为你要使用的另一个文件的名称.调用open()后,将一个表示文件及其内容的对象存储到了变量file_object中(见❷).这里也使用了关键字with,让Python负责妥善地打开和关闭文件.为查看文件的内容,我们通过对文件对象执行循环来遍历文件中的每一行(见❹).
我们打印每一行时,发现空白行更多了:
13.1415926535
2
3  8979323846
4
5  2643383279
6
为何会出现这些空白行呢?因为在这个文件中,每行的末尾都有一个看不见的换行符,而print语句也会加上一个换行符,因此每行末尾都有两个换行符:一个来自文件,另一个来自print语句.要消除这些多余的空白行,可在print语句中使用rstrip():
1filename = 'pi_digits.txt'
2
3with open(filename) as file_object:
4    for line in file_object:
5        print(line.rstrip())
6
现在,输出又与文件内容完全相同了:
13.1415926535
2  8979323846
3  2643383279
4
1.4创建一个包含文件各行内容的列表
使用关键字with时,open()返回的文件对象只在with代码块内可用.如果要在with代码块外访问文件的内容,可在with代码块内将文件的各行存储在一个列表中,并在with代码块外使用该列表:你可以立即处理文件的各个部分,也可推迟到程序后面再处理.
下面的示例在with代码块中将文件pi_digits.txt的各行存储在一个列表中,再在with代码块外打印它们:
1filename = 'pi_digits.txt'
2
3with open(filename) as file_object:
4    lines = file_object.readlines()  # ❶
5
6for line in lines:  # ❷
7    print(line.rstrip())
8
❶处的方法readlines()从文件中读取每一行,并将其存储在一个列表中;接下来,该列表被存储到变量lines中;在with代码块外,我们依然可以使用这个变量.在❷处,我们使用一个简单的for循环来打印lines中的各行.由于列表lines的每个元素都对应于文件中的一行,因此输出与文件内容完全一致.
1.5使用文件的内容
将文件读取到内存中后,就可以以任何方式使用这些数据了.下面以简单的方式使用圆周率的值.首先,我们将创建一个字符串,它包含文件中存储的所有数字,且没有任何空格:
pi_string.py
1filename = 'pi_digits.txt'
2
3with open(filename) as file_object:
4    lines = file_object.readlines()
5
6pi_string = ''  # ❶
7for line in lines:  # ❷
8    pi_string += line.rstrip()
9
10print(pi_string)  # ❸
11print(len(pi_string))
12
就像前一个示例一样,我们首先打开文件,并将其中的所有行都存储在一个列表中.在❶处,我们创建了一个变量——pi_string,用于存储圆周率的值.接下来,我们使用一个循环将各行都加入pi_string,并删除每行末尾的换行符(见❷).在❸处,我们打印这个字符串及其长度:
13.1415926535  8979323846  2643383279
236
3
在变量pi_string存储的字符串中,包含原来位于每行左边的空格,为删除这些空格,可使用strip()而不是rstrip():
1filename = 'pi_30_digits.txt'
2
3with open(filename) as file_object:
4    lines = file_object.readlines()
5
6pi_string = ''
7for line in lines:
8    pi_string += line.strip()
9
10print(pi_string)
11print(len(pi_string))
12
这样,我们就获得了一个这样的字符串:它包含精确到30位小数的圆周率值.这个字符串长32字符,因为它还包含整数部分的3和小数点:
13.141592653589793238462643383279
232
3
注意读取文本文件时,Python将其中的所有文本都解读为字符串。如果你读取的是数字,并要将其作为数值使用,就必须使用函数
int()将其转换为整数,或使用函数float()将其转换为浮点数。
1.6包含一百万位的大型文件
前面我们分析的都是一个只有三行的文本文件,但这些代码示例也可处理大得多的文件.如果我们有一个文本文件,其中包含精确到小数点后1 000 000位而不是30位的圆周率值,也可创建一个包含所有这些数字的字符串.为此,我们无需对前面的程序做任何修改,只需将这个文件传递给它即可.在这里,我们只打印到小数点后50位,以免终端为显示全部1 000 000位而不断地翻滚:
pi_string.py
1filename = 'pi_million_digits.txt'
2
3with open(filename) as file_object:
4    lines = file_object.readlines()
5
6pi_string = ''
7for line in lines:
8    pi_string += line.strip()
9
10print(pi_string[:52] + "...")
11print(len(pi_string))
12
输出表明,我们创建的字符串确实包含精确到小数点后1 000 000位的圆周率值:
13.14159265358979323846264338327950288419716939937510...
21000002
3
对于你可处理的数据量,Python没有任何限制;只要系统的内存足够多,你想处理多少数据都可以.
1.7圆周率值中包含你的生日吗
我一直想知道自己的生日是否包含在圆周率值中.下面来扩展刚才编写的程序,以确定某个人的生日是否包含在圆周率值的前1 000 000位中.为此,可将生日表示为一个由数字组成的字符串,再检查这个字符串是否包含在pi_string中:
1filename = 'pi_million_digits.txt'
2
3with open(filename) as file_object:
4    lines = file_object.readlines()
5pi_string = ''
6for line in lines:
7    pi_string += line.rstrip()
8
9birthday = input("Enter your birthday, in the form mmddyy: ")  # ❶
10if birthday in pi_string:  # ❷
11    print("Your birthday appears in the first million digits of pi!")
12else:
13    print("Your birthday does not appear in the first million digits of pi.")
14
在❶处,我们提示用户输入其生日,在接下来的❷处,我们检查这个字符串是否包含在pi_string中.运行一下这个程序:
1Enter your birthdate, in the form mmddyy: 120372
2Your birthday appears in the first million digits of pi!
3
我的生日确实出现在了圆周率值中!读取文件的内容后,就可以以你能想到的任何方式对其进行分析.
2.写入文件
保存数据的最简单的方式之一是将其写入到文件中.通过将输出写入文件,即便关闭包含程序输出的终端窗口,这些输出也依然存在:你可以在程序结束运行后查看这些输出,可与别人分享输出文件,还可编写程序来将这些输出读取到内存中并进行处理.
2.1写入空文件
要将文本写入文件,你在调用open()时需要提供另一个实参,告诉Python你要写入打开的文件.为明白其中的工作原理,我们来将一条简单的消息存储到文件中,而不是将其打印到屏幕上:
write_message.py
1filename = 'programming.txt'
2
3with open(filename, 'w') as file_object:  # ❶
4    file_object.write("I love programming.")  # ❷
5
在这个示例中,调用open()时提供了两个实参(见❶).第一个实参也是要打开的文件的名称;第二个实参('w')告诉Python,我们要以写入模式打开这个文件.打开文件时,可指定读取模式('r')、写入模式('w')、附加模式('a')或让你能够读取和写入文件的模式('r+').如果你省略了模式实参,Python将以默认的只读模式打开文件.
如果你要写入的文件不存在,函数open()将自动创建它.然而,以写入('w')模式打开文件时千万要小心,因为如果指定的文件已经存在,Python将在返回文件对象前清空该文件.
在❷处,我们使用文件对象的方法write()将一个字符串写入文件.这个程序没有终端输出,但如果你打开文件programming.txt,将看到其中包含如下一行内容:
programming.txt
1I love programming.
2
相比于你的计算机中的其他文件,这个文件没有什么不同.你可以打开它、在其中输入新文本、复制其内容、将内容粘贴到其中等.
注意Python只能将字符串写入文本文件。要将数值数据存储到文本文件中,必须先使用函数
str()将其转换为字符串格式。
2.2写入多行
函数write()不会在你写入的文本末尾添加换行符,因此如果你写入多行时没有指定换行符,文件看起来可能不是你希望的那样:
1filename = 'programming.txt'
2
3with open(filename, 'w') as file_object:
4    file_object.write("I love programming.")
5    file_object.write("I love creating new games.")
6
如果你打开programming.txt,将发现两行内容挤在一起:
1I love programming.I love creating new games.
2
要让每个字符串都单独占一行,需要在write()语句中包含换行符:
1filename = 'programming.txt'
2
3with open(filename, 'w') as file_object:
4    file_object.write("I love programming.\n")
5    file_object.write("I love creating new games.\n")
6
现在,输出出现在不同行中:
1I love programming.
2I love creating new games.
3
像显示到终端的输出一样,还可以使用空格、制表符和空行来设置这些输出的格式.
2.3附加到文件
如果你要给文件添加内容,而不是覆盖原有的内容,可以附加模式打开文件.你以附加模式打开文件时,Python不会在返回文件对象前清空文件,而你写入到文件的行都将添加到文件末尾.如果指定的文件不存在,Python将为你创建一个空文件.
下面来修改write_message.py,在既有文件programming.txt中再添加一些你酷爱编程的原因:
write_message.py
1filename = 'programming.txt'
2
3with open(filename, 'a') as file_object:  # ❶
4    file_object.write("I also love finding meaning in large datasets.\n")  # ❷
5    file_object.write("I love creating apps that can run in a browser.\n")
6
在❶处,我们打开文件时指定了实参'a',以便将内容附加到文件末尾,而不是覆盖文件原来的内容.在❷处,我们又写入了两行,它们被添加到文件programming.txt末尾:
programming.txt
1I love programming.
2I love creating new games.
3I also love finding meaning in large datasets.
4I love creating apps that can run in a browser.
5
最终的结果是,文件原来的内容还在,它们后面是我们刚添加的内容.
3.异常
Python使用被称为异常的特殊对象来管理程序执行期间发生的错误.每当发生让Python不知所措的错误时,它都会创建一个异常对象.如果你编写了处理该异常的代码,程序将继续运行;如果你未对异常进行处理,程序将停止,并显示一个traceback,其中包含有关异常的报告.
异常是使用try-except代码块处理的.try-except代码块让Python执行指定的操作,同时告诉Python发生异常时怎么办.使用了try-except代码块时,即便出现异常,程序也将继续运行:显示你编写的友好的错误消息,而不是令用户迷惑的traceback.
3.1处理ZeroDivisionError异常
下面来看一种导致Python引发异常的简单错误.你可能知道不能将一个数字除以0,但我们还是让Python这样做吧:
division.py
1print(5/0)
2
显然,Python无法这样做,因此你将看到一个traceback:
1Traceback (most recent call last):
2  File "division.py", line 1, in <module>
3    print(5/0)
4ZeroDivisionError: division by zero  # ❶
5
在上述traceback中,❶处指出的错误ZeroDivisionError是一个异常对象.Python无法按你的要求做时,就会创建这种对象.在这种情况下,Python将停止运行程序,并指出引发了哪种异常,而我们可根据这些信息对程序进行修改.下面我们将告诉Python,发生这种错误时怎么办;这样,如果再次发生这样的错误,我们就有备无患了.
3.2使用try-except代码块
当你认为可能发生了错误时,可编写一个try-except代码块来处理可能引发的异常.你让Python尝试运行一些代码,并告诉它如果这些代码引发了指定的异常,该怎么办.
处理ZeroDivisionError异常的try-except代码块类似于下面这样:
1try:
2    print(5/0)
3except ZeroDivisionError:
4    print("You can't divide by zero!")
5
我们将导致错误的代码行print(5/0)放在了一个try代码块中.如果try代码块中的代码运行起来没有问题,Python将跳过except代码块;如果try代码块中的代码导致了错误,Python将查找这样的except代码块,并运行其中的代码,即其中指定的错误与引发的错误相同.
在这个示例中,try代码块中的代码引发了ZeroDivisionError异常,因此Python指出了该如何解决问题的except代码块,并运行其中的代码.这样,用户看到的是一条友好的错误消息,而不是traceback:
1You can't divide by zero!
2
如果try-except代码块后面还有其他代码,程序将接着运行,因为已经告诉了Python如何处理这种错误.下面来看一个捕获错误后程序将继续运行的示例.
3.3使用异常避免崩溃
发生错误时,如果程序还有工作没有完成,妥善地处理错误就尤其重要.这种情况经常会出现在要求用户提供输入的程序中;如果程序能够妥善地处理无效输入,就能再提示用户提供有效输入,而不至于崩溃.
下面来创建一个只执行除法运算的简单计算器:
division.py
1print("Give me two numbers, and I'll divide them.")
2print("Enter 'q' to quit.")
3
4while True:
5    first_number = input("\nFirst number: ")  # ❶
6    if first_number == 'q':
7        break
8    second_number = input("Second number: ")  # ❷
9    if second_number == 'q':
10        break
11    answer = int(first_number) / int(second_number)  # ❸
12    print(answer)
13
在❶处,这个程序提示用户输入一个数字,并将其存储到变量first_number中;如果用户输入的不是表示退出的q,就再提示用户输入一个数字,并将其存储到变量second_number中(见❷).接下来,我们计算这两个数字的商(即answer,见❸).这个程序没有采取任何处理错误的措施,因此让它执行除数为0的除法运算时,它将崩溃:
1Give me two numbers, and I'll divide them.
2Enter 'q' to quit.
3
4First number: 5
5Second number: 0
6Traceback (most recent call last):
7  File "division.py", line 9, in <module>
8    answer = int(first_number) / int(second_number)
9ZeroDivisionError: division by zero
10
程序崩溃可不好,但让用户看到traceback也不是好主意.不懂技术的用户会被它们搞糊涂,而且如果用户怀有恶意,他会通过traceback获悉你不希望他知道的信息.例如,他将知道你的程序文件的名称,还将看到部分不能正确运行的代码.有时候,训练有素的攻击者可根据这些信息判断出可对你的代码发起什么样的攻击.
3.4else代码块
通过将可能引发错误的代码放在try-except代码块中,可提高这个程序抵御错误的能力.错误是执行除法运算的代码行导致的,因此我们需要将它放到try-except代码块中.这个示例还包含一个else代码块;依赖于try代码块成功执行的代码都应放到else代码块中:
1print("Give me two numbers, and I'll divide them.")
2print("Enter 'q' to quit.")
3
4while True:
5    first_number = input("\nFirst number: ")
6    if first_number == 'q':
7        break
8    second_number = input("Second number: ")
9    try:  # ❶
10        answer = int(first_number) / int(second_number)
11    except ZeroDivisionError:  # ❷
12        print("You can't divide by 0!")
13    else:  # ❸
14        print(answer)
15
我们让Python尝试执行try代码块中的除法运算(见❶),这个代码块只包含可能导致错误的代码.依赖于try代码块成功执行的代码都放在else代码块中;在这个示例中,如果除法运算成功,我们就使用else代码块来打印结果(见❸).
except代码块告诉Python,出现ZeroDivisionError异常时该怎么办(见❷).如果try代码块因除零错误而失败,我们就打印一条友好的消息,告诉用户如何避免这种错误.程序将继续运行,用户根本看不到traceback:
1Give me two numbers, and I'll divide them.
2Enter 'q' to quit.
3
4First number: 5
5Second number: 0
6You can't divide by 0!
7
8First number: 5
9Second number: 2
102.5
11
12First number: q
13
try-except-else代码块的工作原理大致如下:Python尝试执行try代码块中的代码;只有可能引发异常的代码才需要放在try语句中.有时候,有一些仅在try代码块成功执行时才需要运行的代码;这些代码应放在else代码块中.except代码块告诉Python,如果它尝试运行try代码块中的代码时引发了指定的异常,该怎么办.
通过预测可能发生错误的代码,可编写健壮的程序,它们即便面临无效数据或缺少资源,也能继续运行,从而能够抵御无意的用户错误和恶意的攻击.
3.5处理FileNotFoundError异常
使用文件时,一种常见的问题是找不到文件:你要查找的文件可能在其他地方、文件名可能不正确或者这个文件根本就不存在.对于所有这些情形,都可使用try-except代码块以直观的方式进行处理.
我们来尝试读取一个不存在的文件.下面的程序尝试读取文件alice.txt的内容,但我没有将这个文件存储在alice.py所在的目录中:
alice.py
1filename = 'alice.txt'
2
3with open(filename) as f_obj:
4    contents = f_obj.read()
5
Python无法读取不存在的文件,因此它引发一个异常:
1Traceback (most recent call last):
2  File "alice.py", line 3, in <module>
3    with open(filename) as f_obj:
4FileNotFoundError: [Errno 2] No such file or directory: 'alice.txt'
5
在上述traceback中,最后一行报告了FileNotFoundError异常,这是Python找不到要打开的文件时创建的异常.在这个示例中,这个错误是函数open()导致的,因此要处理这个错误,必须将try语句放在包含open()的代码行之前:
1filename = 'alice.txt'
2
3try:
4    with open(filename) as f_obj:
5        contents = f_obj.read()
6except FileNotFoundError:
7    msg = "Sorry, the file " + filename + " does not exist."
8    print(msg)
9
在这个示例中,try代码块引发FileNotFoundError异常,因此Python找出与该错误匹配的except代码块,并运行其中的代码.最终的结果是显示一条友好的错误消息,而不是traceback:
1Sorry, the file alice.txt does not exist.
2
如果文件不存在,这个程序什么都不做,因此错误处理代码的意义不大.下面来扩展这个示例,看看在你使用多个文件时,异常处理可提供什么样的帮助.
3.6分析文本
你可以分析包含整本书的文本文件.很多经典文学作品都是以简单文本文件的方式提供的,因为它们不受版权限制.本节使用的文本来自项目Gutenberg(http://gutenberg.org/),这个项目提供了一系列不受版权限制的文学作品,如果你要在编程项目中使用文学文本,这是一个很不错的资源.
下面来提取童话Alice in Wonderland的文本,并尝试计算它包含多少个单词.我们将使用方法split(),它根据一个字符串创建一个单词列表.下面是对只包含童话名"Alice in Wonderland"的字符串调用方法split()的结果:
1>>> title = "Alice in Wonderland"
2>>> title.split()
3['Alice', 'in', 'Wonderland']
4
方法split()以空格为分隔符将字符串分拆成多个部分,并将这些部分都存储到一个列表中.结果是一个包含字符串中所有单词的列表,虽然有些单词可能包含标点.为计算Alice in Wonderland包含多少个单词,我们将对整篇小说调用split(),再计算得到的列表包含多少个元素,从而确定整篇童话大致包含多少个单词:
1filename = 'alice.txt'
2
3try:
4    with open(filename) as f_obj:
5        contents = f_obj.read()
6except FileNotFoundError:
7    msg = "Sorry, the file " + filename + " does not exist."
8    print(msg)
9else:
10    # 计算文件大致包含多少个单词
11    words = contents.split()  # ❶
12    num_words = len(words)  # ❷
13    print("The file " + filename + " has about " + str(num_words) + " words.")  # ❸
14
我们把文件alice.txt移到了正确的目录中,让try代码块能够成功地执行.在❶处,我们对变量contents(它现在是一个长长的字符串,包含童话Alice in Wonderland的全部文本)调用方法split(),以生成一个列表,其中包含这部童话中的所有单词.当我们使用len()来确定这个列表的长度时,就知道了原始字符串大致包含多少个单词(见❷).在❸处,我们打印一条消息,指出文件包含多少个单词.这些代码都放在else代码块中,因为仅当try代码块成功执行时才执行它们.输出指出了文件alice.txt包含多少个单词:
1The file alice.txt has about 29461 words.
2
这个数字有点大,因为这里使用的文本文件包含出版商提供的额外信息,但与童话Alice in Wonderland的长度相当一致.
3.7使用多个文件
下面多分析几本书.这样做之前,我们先将这个程序的大部分代码移到一个名为count_words()的函数中,这样对多本书进行分析时将更容易:
word_count.py
1def count_words(filename):
2    """计算一个文件大致包含多少个单词"""  # ❶
3    try:
4        with open(filename) as f_obj:
5            contents = f_obj.read()
6    except FileNotFoundError:
7        msg = "Sorry, the file " + filename + " does not exist."
8        print(msg)
9    else:
10        # 计算文件大致包含多少个单词
11        words = contents.split()
12        num_words = len(words)
13        print("The file " + filename + " has about " + str(num_words) +
14            " words.")
15
16filename = 'alice.txt'
17count_words(filename)
18
这些代码大都与原来一样,我们只是将它们移到了函数count_words()中,并增加了缩进量.修改程序的同时更新注释是个不错的习惯,因此我们将注释改成了文档字符串,并稍微调整了一下措辞(见❶).
现在可以编写一个简单的循环,计算要分析的任何文本包含多少个单词了.为此,我们将要分析的文件的名称存储在一个列表中,然后对列表中的每个文件都调用count_words().我们将尝试计算Alice in Wonderland、Siddhartha、Moby Dick和Little Women分别包含多少个单词,它们都不受版权限制.我故意没有将siddhartha.txt放到word_count.py所在的目录中,让你能够看到这个程序在文件不存在时处理得有多出色:
1def count_words(filename):
2    --snip--
3
4filenames = ['alice.txt', 'siddhartha.txt', 'moby_dick.txt', 'little_women.txt']
5for filename in filenames:
6    count_words(filename)
7
文件siddhartha.txt不存在,但这丝毫不影响这个程序处理其他文件:
1The file alice.txt has about 29461 words.
2Sorry, the file siddhartha.txt does not exist.
3The file moby_dick.txt has about 215136 words.
4The file little_women.txt has about 189079 words.
5
在这个示例中,使用try-except代码块提供了两个重要的优点:避免让用户看到traceback;让程序能够继续分析能够找到的其他文件.如果不捕获因找不到siddhartha.txt而引发的FileNotFoundError异常,用户将看到完整的traceback,而程序将在尝试分析Siddhartha后停止运行——根本不分析Moby Dick和Little Women.
3.8失败时一声不吭
在前一个示例中,我们告诉用户有一个文件找不到.但并非每次捕获到异常时都需要告诉用户,有时候你希望程序在发生异常时一声不吭,就像什么都没有发生一样继续运行.要让程序在失败时一声不吭,可像通常那样编写try代码块,但在except代码块中明确地告诉Python什么都不要做.Python有一个pass语句,可在代码块中使用它来让Python什么都不要做:
1def count_words(filename):
2    """计算一个文件大致包含多少个单词"""
3    try:
4        --snip--
5    except FileNotFoundError:
6        pass  # ❶
7    else:
8        --snip--
9
10filenames = ['alice.txt', 'siddhartha.txt', 'moby_dick.txt', 'little_women.txt']
11for filename in filenames:
12    count_words(filename)
13
相比于前一个程序,这个程序唯一不同的地方是❶处的pass语句.现在,出现FileNotFoundError异常时,将执行except代码块中的代码,但什么都不会发生.这种错误发生时,不会出现traceback,也没有任何输出.用户将看到存在的每个文件包含多少个单词,但没有任何迹象表明有一个文件未找到:
1The file alice.txt has about 29461 words.
2The file moby_dick.txt has about 215136 words.
3The file little_women.txt has about 189079 words.
4
pass语句还充当了占位符,它提醒你在程序的某个地方什么都没有做,并且以后也许要在这里做些什么.例如,在这个程序中,我们可能决定将找不到的文件的名称写入到文件missing_files.txt中.用户看不到这个文件,但我们可以读取这个文件,进而处理所有文件找不到的问题.
3.9决定报告哪些错误
在什么情况下该向用户报告错误?在什么情况下又应该在失败时一声不吭呢?如果用户知道要分析哪些文件,他们可能希望在有文件没有分析时出现一条消息,将其中的原因告诉他们.如果用户只想看到结果,而并不知道要分析哪些文件,可能就无需在有些文件不存在时告知他们.向用户显示他不想看到的信息可能会降低程序的可用性.Python的错误处理结构让你能够细致地控制与用户分享错误信息的程度,要分享多少信息由你决定.
编写得很好且经过详尽测试的代码不容易出现内部错误,如语法或逻辑错误,但只要程序依赖于外部因素,如用户输入、存在指定的文件、有网络链接,就有可能出现异常.凭借经验可判断该在程序的什么地方包含异常处理块,以及出现错误时该向用户提供多少相关的信息.
4.存储数据
很多程序都要求用户输入某种信息,如让用户存储游戏首选项或提供要可视化的数据.不管专注的是什么,程序都把用户提供的信息存储在列表和字典等数据结构中.用户关闭程序时,你几乎总是要保存他们提供的信息;一种简单的方式是使用模块json来存储数据.
模块json让你能够将简单的Python数据结构转储到文件中,并在程序再次运行时加载该文件中的数据.你还可以使用json在Python程序之间分享数据.更重要的是,JSON数据格式并非Python专用的,这让你能够将以JSON格式存储的数据与使用其他编程语言的人分享.这是一种轻便格式,很有用,也易于学习.
注意JSON(JavaScript Object Notation)格式最初是为JavaScript开发的,但随后成了一种常见格式,被包括Python在内的众多语言采用。
4.1使用json.dump()和json.load()
我们来编写一个存储一组数字的简短程序,再编写一个将这些数字读取到内存中的程序.第一个程序将使用json.dump()来存储这组数字,而第二个程序将使用json.load().
函数json.dump()接受两个实参:要存储的数据以及可用于存储数据的文件对象.下面演示了如何使用json.dump()来存储数字列表:
number_writer.py
1import json
2
3numbers = [2, 3, 5, 7, 11, 13]
4
5filename = 'numbers.json'  # ❶
6with open(filename, 'w') as f_obj:  # ❷
7    json.dump(numbers, f_obj)  # ❸
8
我们先导入模块json,再创建一个数字列表.在❶处,我们指定了要将该数字列表存储到其中的文件的名称.通常使用文件扩展名.json来指出文件存储的数据为JSON格式.接下来,我们以写入模式打开这个文件,让json能够将数据写入其中(见❷).在❸处,我们使用函数json.dump()将数字列表存储到文件numbers.json中.
这个程序没有输出,但我们可以打开文件numbers.json,看看其内容.数据的存储格式与Python中一样:
1[2, 3, 5, 7, 11, 13]
2
下面再编写一个程序,使用json.load()将这个列表读取到内存中:
number_reader.py
1mport json
2
3filename = 'numbers.json'  # ❶
4with open(filename) as f_obj:  # ❷
5    numbers = json.load(f_obj)  # ❸
6
7print(numbers)
8
在❶处,我们确保读取的是前面写入的文件.这次我们以读取方式打开这个文件,因为Python只需读取这个文件(见❷).在❸处,我们使用函数json.load()加载存储在numbers.json中的信息,并将其存储到变量numbers中.最后,我们打印恢复的数字列表,看看它是否与number_writer.py中创建的数字列表相同:
1[2, 3, 5, 7, 11, 13]
2
这是一种在程序之间共享数据的简单方式.
4.2保存和读取用户生成的数据
对于用户生成的数据,使用json保存它们大有裨益,因为如果不以某种方式进行存储,等程序停止运行时用户的信息将丢失.下面来看一个这样的例子:用户首次运行程序时被提示输入自己的名字,这样再次运行程序时就记住他了.
我们先来存储用户的名字:
remember_me.py
1import json
2
3username = input("What is your name? ")  # ❶
4
5filename = 'username.json'
6with open(filename, 'w') as f_obj:
7    json.dump(username, f_obj)  # ❷
8    print("We'll remember you when you come back, " + username + "!")  # ❸
9
在❶处,我们提示输入用户名,并将其存储在一个变量中.接下来,我们调用json.dump(),并将用户名和一个文件对象传递给它,从而将用户名存储到文件中(见❷).然后,我们打印一条消息,指出我们存储了他输入的信息(见❸):
1What is your name? Eric
2We'll remember you when you come back, Eric!
3
现在再编写一个程序,向其名字被存储的用户发出问候:
greet_user.py
1import json
2
3filename = 'username.json'
4
5with open(filename) as f_obj:
6    username = json.load(f_obj)  # ❶
7    print("Welcome back, " + username + "!")  # ❷
8
在❶处,我们使用json.load()将存储在username.json中的信息读取到变量username中.恢复用户名后,我们就可以欢迎用户回来了(见❷):
1Welcome back, Eric!
2
我们需要将这两个程序合并到一个程序(remember_me.py)中.这个程序运行时,我们将尝试从文件username.json中获取用户名,因此我们首先编写一个尝试恢复用户名的try代码块.如果这个文件不存在,我们就在except代码块中提示用户输入用户名,并将其存储在username.json中,以便程序再次运行时能够获取它:
remember_me.py
1import json
2
3# 如果以前存储了用户名,就加载它
4#  否则,就提示用户输入用户名并存储它
5filename = 'username.json'
6try:
7    with open(filename) as f_obj:  # ❶
8        username = json.load(f_obj)  # ❷
9except FileNotFoundError:  # ❸
10    username = input("What is your name? ")  # ❹
11    with open(filename, 'w') as f_obj:  # ❺
12        json.dump(username, f_obj)
13        print("We'll remember you when you come back, " + username + "!")
14else:
15    print("Welcome back, " + username + "!")
16
这里没有任何新代码,只是将前两个示例的代码合并到了一个程序中.在❶处,我们尝试打开文件username.json.如果这个文件存在,就将其中的用户名读取到内存中(见❷),再执行else代码块,即打印一条欢迎用户回来的消息.用户首次运行这个程序时,文件username.json不存在,将引发FileNotFoundError异常(见❸),因此Python将执行except代码块:提示用户输入其用户名(见❹),再使用json.dump()存储该用户名,并打印一句问候语(见❺).
无论执行的是except代码块还是else代码块,都将显示用户名和合适的问候语.如果这个程序是首次运行,输出将如下:
1What is your name? Eric
2We'll remember you when you come back, Eric!
3
否则,输出将如下:
1Welcome back, Eric!
2
这是程序之前至少运行了一次时的输出.
4.3重构
你经常会遇到这样的情况:代码能够正确地运行,但可做进一步的改进——将代码划分为一系列完成具体工作的函数.这样的过程被称为重构.重构让代码更清晰、更易于理解、更容易扩展.
要重构remember_me.py,可将其大部分逻辑放到一个或多个函数中.remember_me.py的重点是问候用户,因此我们将其所有代码都放到一个名为greet_user()的函数中:
remember_me.py
1import json
2
3def greet_user():
4    """问候用户,并指出其名字"""  # ❶
5    filename = 'username.json'
6    try:
7        with open(filename) as f_obj:
8            username = json.load(f_obj)
9    except FileNotFoundError:
10        username = input("What is your name? ")
11        with open(filename, 'w') as f_obj:
12            json.dump(username, f_obj)
13            print("We'll remember you when you come back, " + username + "!")
14    else:
15        print("Welcome back, " + username + "!")
16
17greet_user()
18
考虑到现在使用了一个函数,我们删除了注释,转而使用一个文档字符串来指出程序是做什么的(见❶).这个程序更清晰些,但函数greet_user()所做的不仅仅是问候用户,还在存储了用户名时获取它,而在没有存储用户名时提示用户输入一个.
下面来重构greet_user(),让它不执行这么多任务.为此,我们首先将获取存储的用户名的代码移到另一个函数中:
1import json
2
3def get_stored_username():
4    """如果存储了用户名,就获取它"""  # ❶
5    filename = 'username.json'
6    try:
7        with open(filename) as f_obj:
8            username = json.load(f_obj)
9    except FileNotFoundError:
10        return None  # ❷
11    else:
12        return username
13
14def greet_user():
15    """问候用户,并指出其名字"""
16    username = get_stored_username()
17    if username:  # ❸
18        print("Welcome back, " + username + "!")
19    else:
20        username = input("What is your name? ")
21        filename = 'username.json'
22        with open(filename, 'w') as f_obj:
23            json.dump(username, f_obj)
24            print("We'll remember you when you come back, " + username + "!")
25
26greet_user()
27
新增的函数get_stored_username()目标明确,❶处的文档字符串指出了这一点.如果存储了用户名,这个函数就获取并返回它;如果文件username.json不存在,这个函数就返回None(见❷).这是一种不错的做法:函数要么返回预期的值,要么返回None;这让我们能够使用函数的返回值做简单测试.在❸处,如果成功地获取了用户名,就打印一条欢迎用户回来的消息,否则就提示用户输入用户名.
我们还需将greet_user()中的另一个代码块提取出来:将没有存储用户名时提示用户输入的代码放在一个独立的函数中:
1import json
2
3def get_stored_username():
4    """如果存储了用户名,就获取它"""
5    --snip--
6
7def get_new_username():
8    """提示用户输入用户名"""
9    username = input("What is your name? ")
10    filename = 'username.json'
11    with open(filename, 'w') as f_obj:
12        json.dump(username, f_obj)
13    return username
14
15def greet_user():
16    """问候用户,并指出其名字"""
17    username = get_stored_username()
18    if username:
19        print("Welcome back, " + username + "!")
20    else:
21        username = get_new_username()
22        print("We'll remember you when you come back, " + username + "!")
23
24greet_user()
25
在remember_me.py的这个最终版本中,每个函数都执行单一而清晰的任务.我们调用greet_user(),它打印一条合适的消息:要么欢迎老用户回来,要么问候新用户.为此,它首先调用get_stored_username(),这个函数只负责获取存储的用户名(如果存储了的话),再在必要时调用get_new_username(),这个函数只负责获取并存储新用户的用户名.要编写出清晰而易于维护和扩展的代码,这种划分工作必不可少.
5.小结
在本文中,我们学习了:如何使用文件;如何一次性读取整个文件,以及如何以每次一行的方式读取文件的内容;如何写入文件,以及如何将文本附加到文件末尾;什么是异常以及如何处理程序可能引发的异常;如何存储Python数据结构,以保存用户提供的信息,避免用户每次运行程序时都需要重新提供.
🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 人生最好的贵人,是一次次把自己拉出低谷的自己!
救自己千千万万次,天助自助者!低落时学会自我鼓励,不任由情绪沉沦,遇到难题主动钻研,不等别人来拉一把.考试失利及时复盘,重新拾起前行勇气;摒弃拖延与懒惰,主动把握每寸光阴,不坐等好运降临,依靠努力慢慢变强.听见质疑不自我动摇,守住心中目标,学会及时停止内耗,把精力放回学习.一次次自我救赎,终会跨过重重关卡.坚持自救与深耕,时光不负不懈之人.
参考文档
- Primers 编程伙伴/Python/内建函数/open
- Primers 编程伙伴/Python/内建函数/print
- Primers 编程伙伴/Bash/帮助手册/read
- Primers 编程伙伴/Python/内建函数/len
- Primers 编程伙伴/Python/内建函数/int
- Primers 编程伙伴/Python/内建函数/float
- Primers 编程伙伴/Python/内建函数/input
- Primers 编程伙伴/HTML/HTML 元素/a
- Primers 编程伙伴/Python/内建函数/str
- Primers 编程伙伴/Bash/帮助手册/split
《【Python编程—从入门到实践】(让程序记得、恢复并解释失败:Python 文件、异常与JSON系统教程)》 是转载文章,点击查看原文。


