✨作者主页:IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
精彩专栏推荐⬇⬇⬇
Java项目
Python项目
安卓项目
微信小程序项目
文章目录
- 一、前言
- 二、开发环境
- 三、系统界面展示
- 四、代码参考
- 五、系统视频
- 结语
一、前言
系统介绍
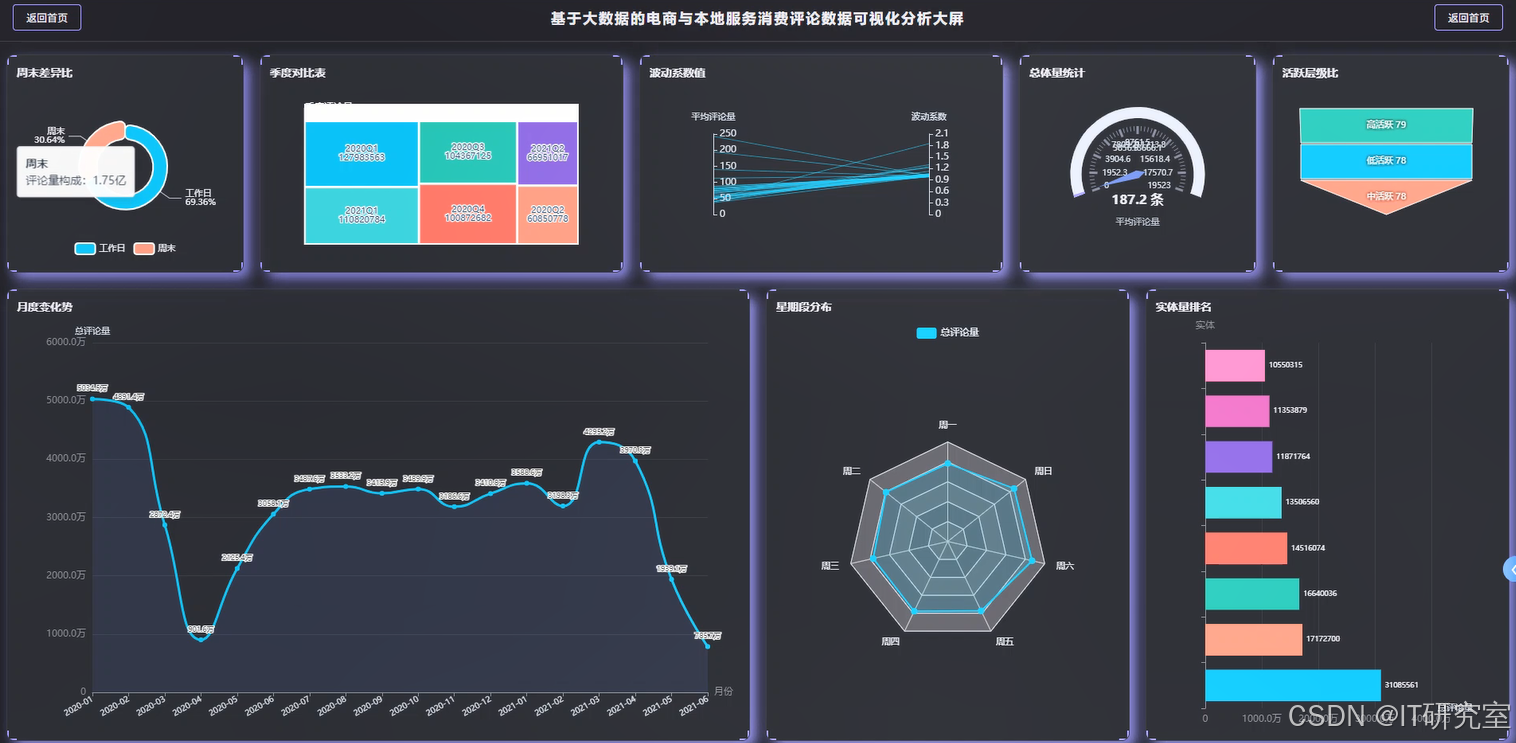
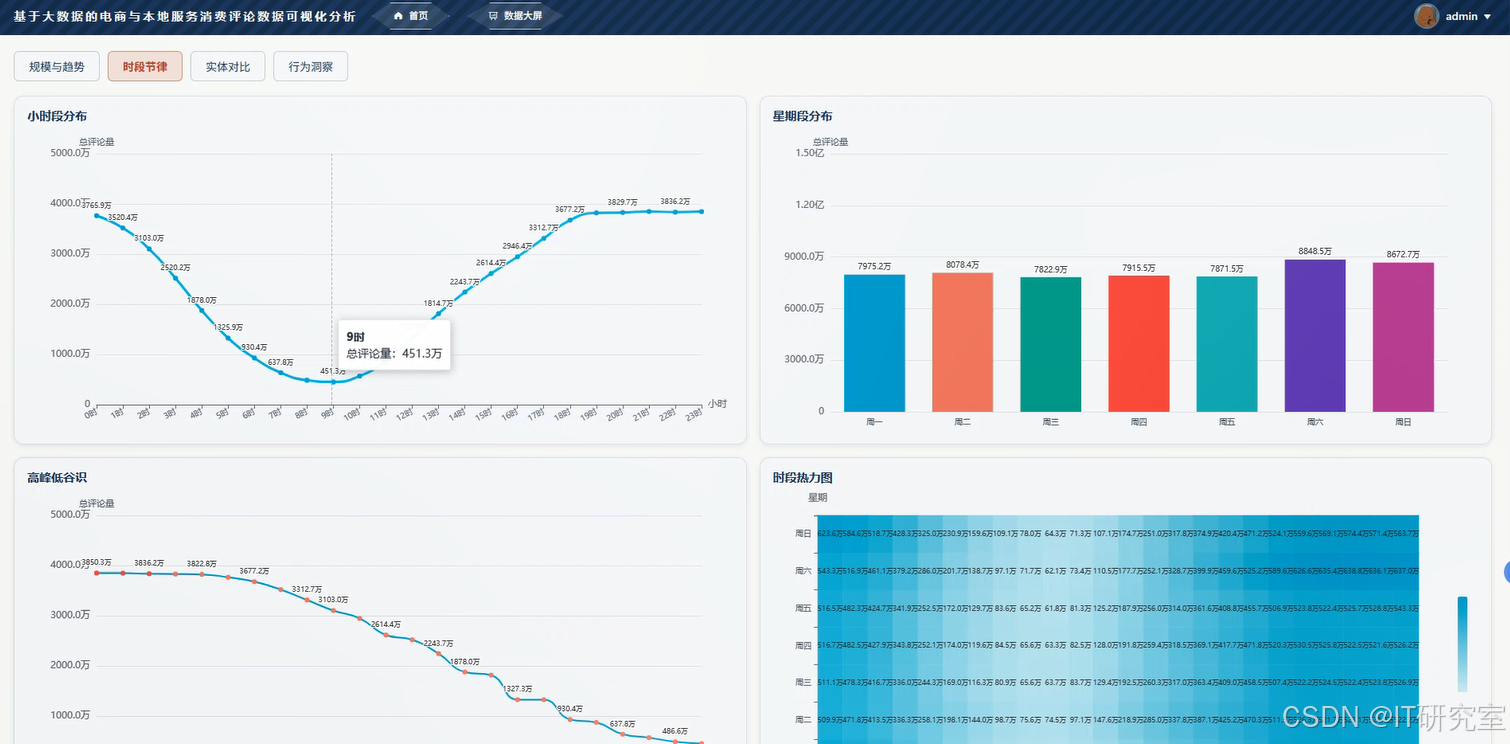
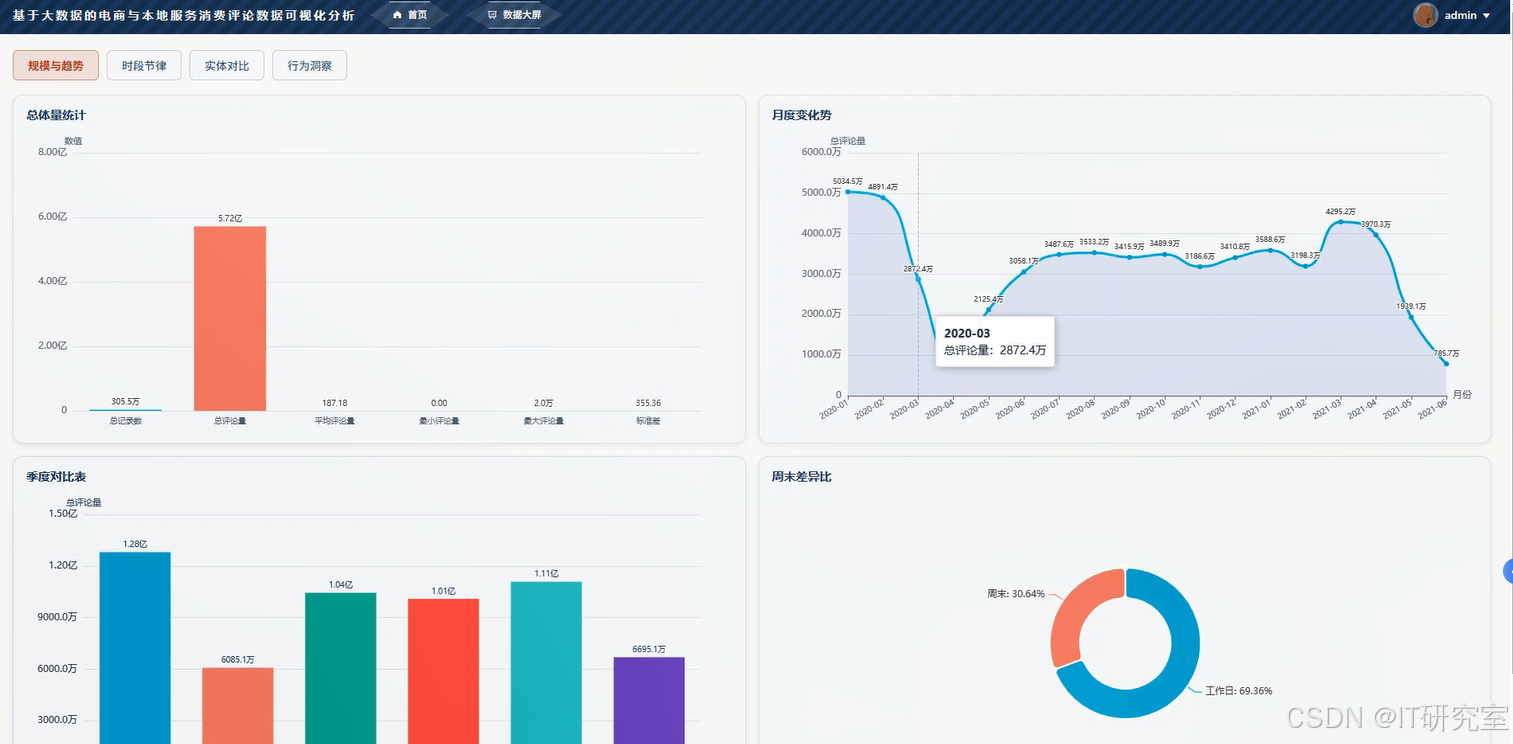
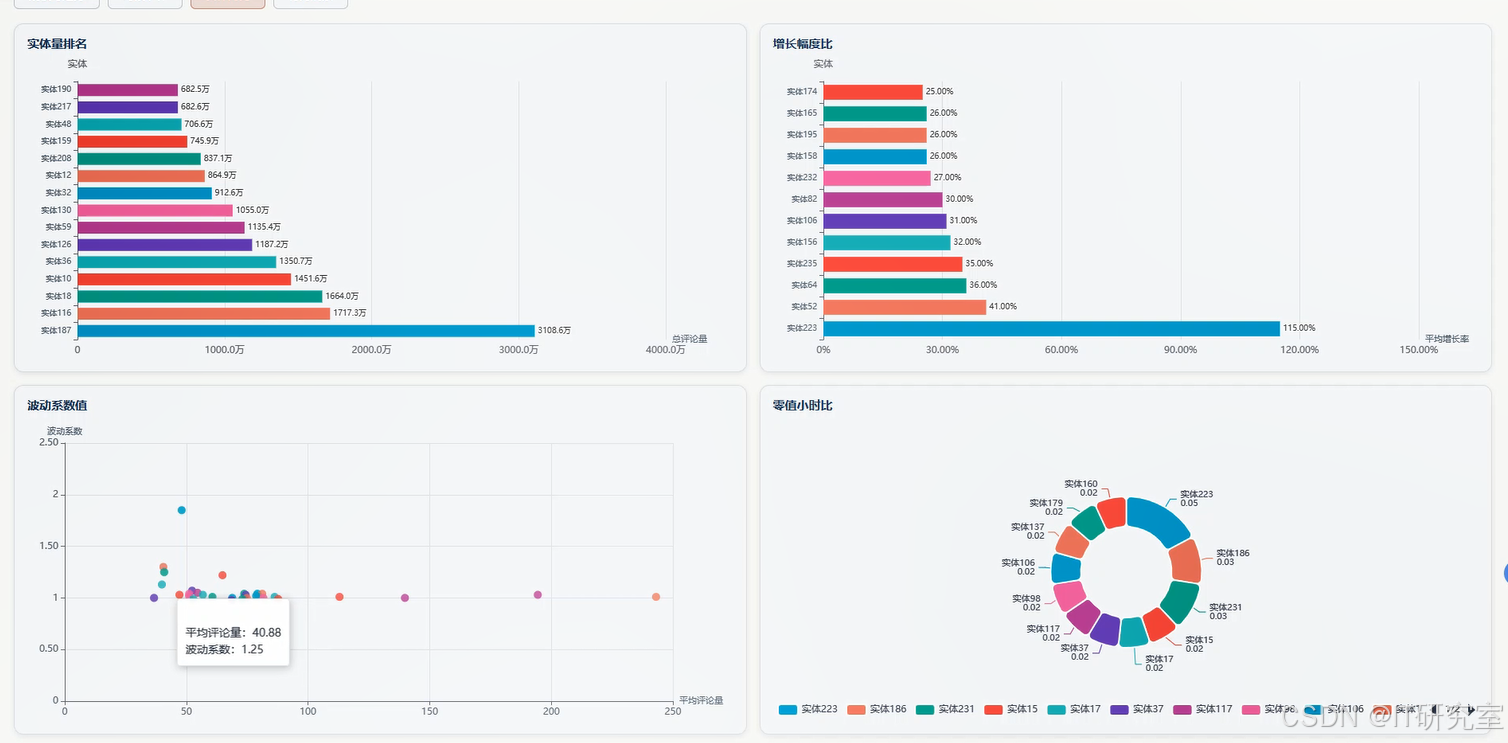
本系统《基于大数据的电商与本地服务消费评论数据可视化分析》以Hadoop分布式文件系统(HDFS)作为底层存储基础,依托Spark计算引擎对大规模消费评论数据进行高效清洗、转换与聚合计算,结合Spark SQL提供的数据分析能力,构建起从原始数据入库到多维度指标计算再到可视化呈现的完整数据处理链路。前端采用Vue框架配合ECharts图表库,将数据分析结果以数据大屏、趋势图、对比图等形式进行直观展示。后端选用Django框架(Python版本)负责业务逻辑编排与接口服务。系统围绕消费评论数据设计了规模与趋势分析、时段节律分析、实体对比分析、行为洞察分析、数据大屏总览以及电商评论数据管理等功能模块,能够对评论数量变化、评分分布、用户消费行为模式、不同商家或商品之间的差异对比等维度进行系统化剖析。整个系统以大数据技术栈为核心驱动力,为消费评论数据的深度挖掘与可视化展示提供了一套完整的工程化实现方案。
选题背景
这几年电商和本地生活服务平台发展得挺快,用户在消费之后留下的评论数据量也在不断增长,这些数据里边其实藏着不少关于用户偏好、消费习惯以及商家服务质量的信息。不过说实话,这类数据的规模通常比较大,结构也不太规整,用传统的单机工具去处理往往效率不高,甚至根本跑不动。大数据技术这几年在数据处理这块已经比较成熟了,拿Hadoop来说,它提供的分布式存储能力可以很好地解决海量数据存放的问题,而Spark这种计算框架在处理大规模数据聚合、筛选、统计这类任务时表现也确实不错。把这两者结合起来,用来应对电商评论数据这种典型的非结构化或者半结构化数据,算是一个比较自然的技术选择。与此同时,现在做毕设的同学也经常遇到选题方向不明确、技术落地不知道怎么下手的情况,所以从实际的数据处理需求出发,结合大数据技术栈来做一个功能相对完整的数据可视化分析系统,既有一定的技术分量,也有比较清晰的应用场景。
选题意义
从实际的角度来看,这个系统的意义首先体现在它能把一堆看起来杂乱无章的评论数据变成有结构、可读性强的图表和指标,比方说评论数量的时间趋势、不同实体的评分对比、用户活跃时段分布这些东西,对做运营或者市场分析的人来说是有参考价值的。另一个层面就是技术落地层面的意义,系统里用到的HDFS存储、Spark SQL查询、数据清洗转换这些操作,都是大数据领域比较基础也比较常用的能力,通过这个课题可以把这些技术点串起来做一个完整的东西,对理解大数据处理流程是有帮助的。再一个就是对于同样在选毕设题目的同学来说,这个系统从数据存储、数据处理到前端展示都有一套可以参照的实现路径,至少在技术选型和功能设计上能提供一个相对完整的参考,减少一些在选题和初期设计阶段的纠结。当然了,说到底这只是一个本科阶段的毕业设计,系统在性能优化、数据规模承载能力这些方面肯定还有不少可以改进的地方,不过作为一个学习性质的工程项目,把现有技术栈能够支撑的功能做到位,把处理逻辑梳理清楚,就已经达到它本身该有的目标了。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
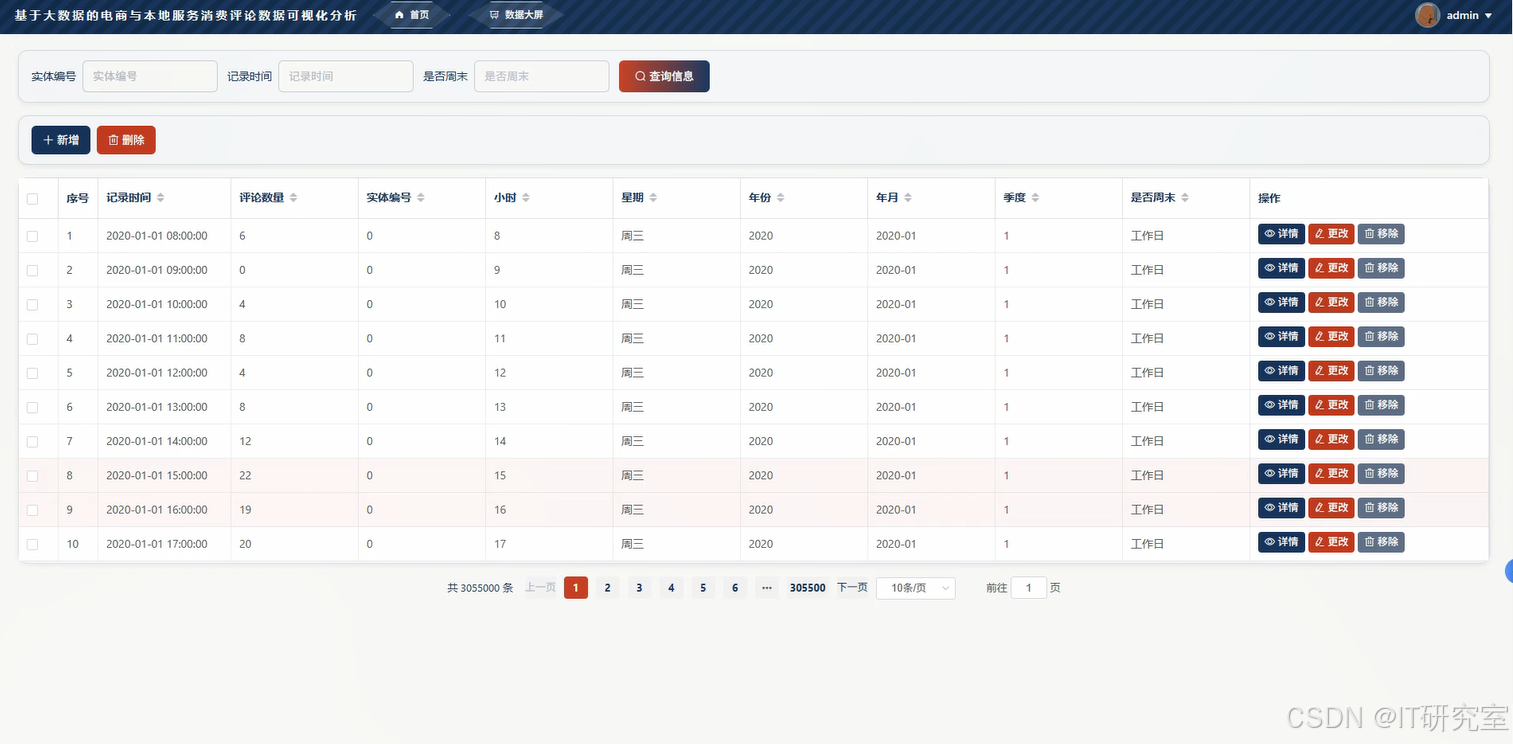
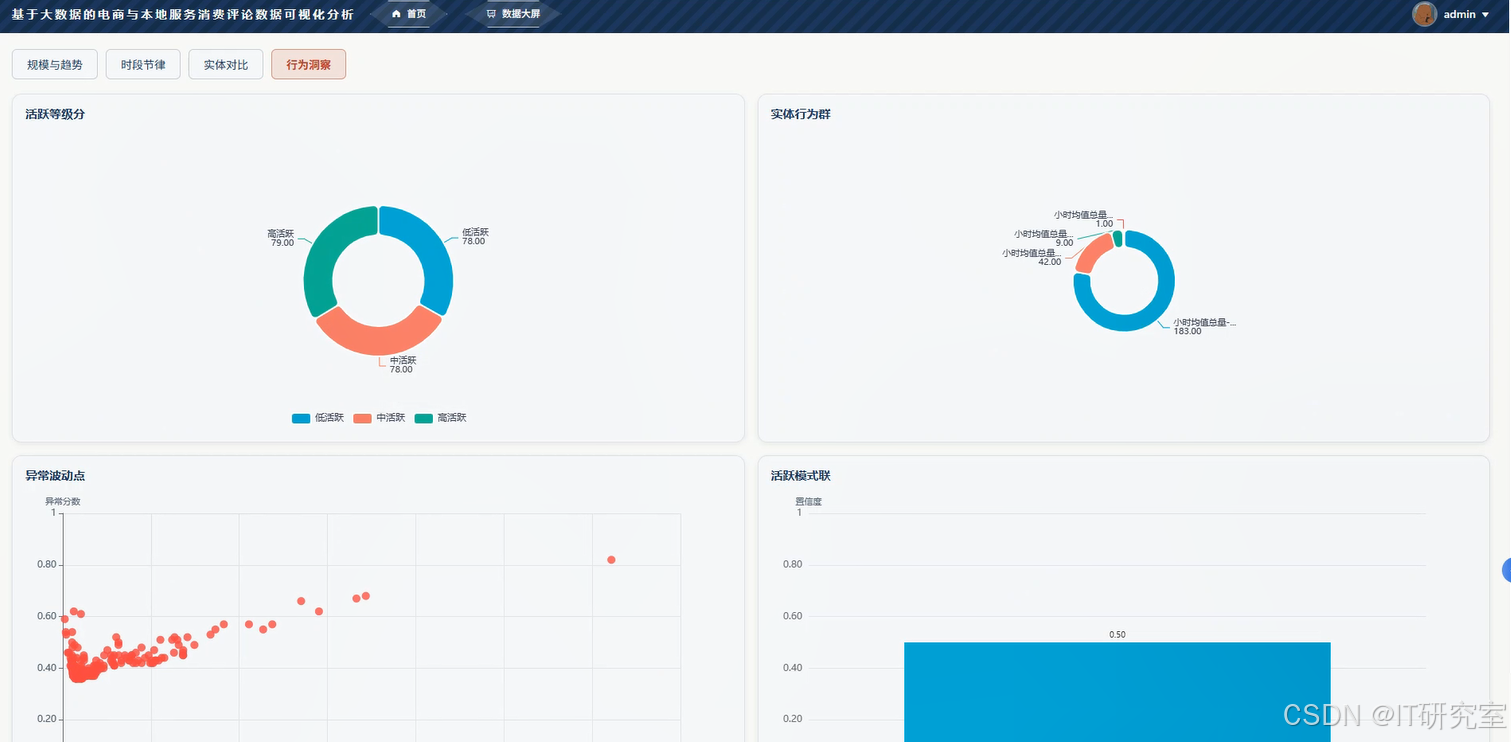
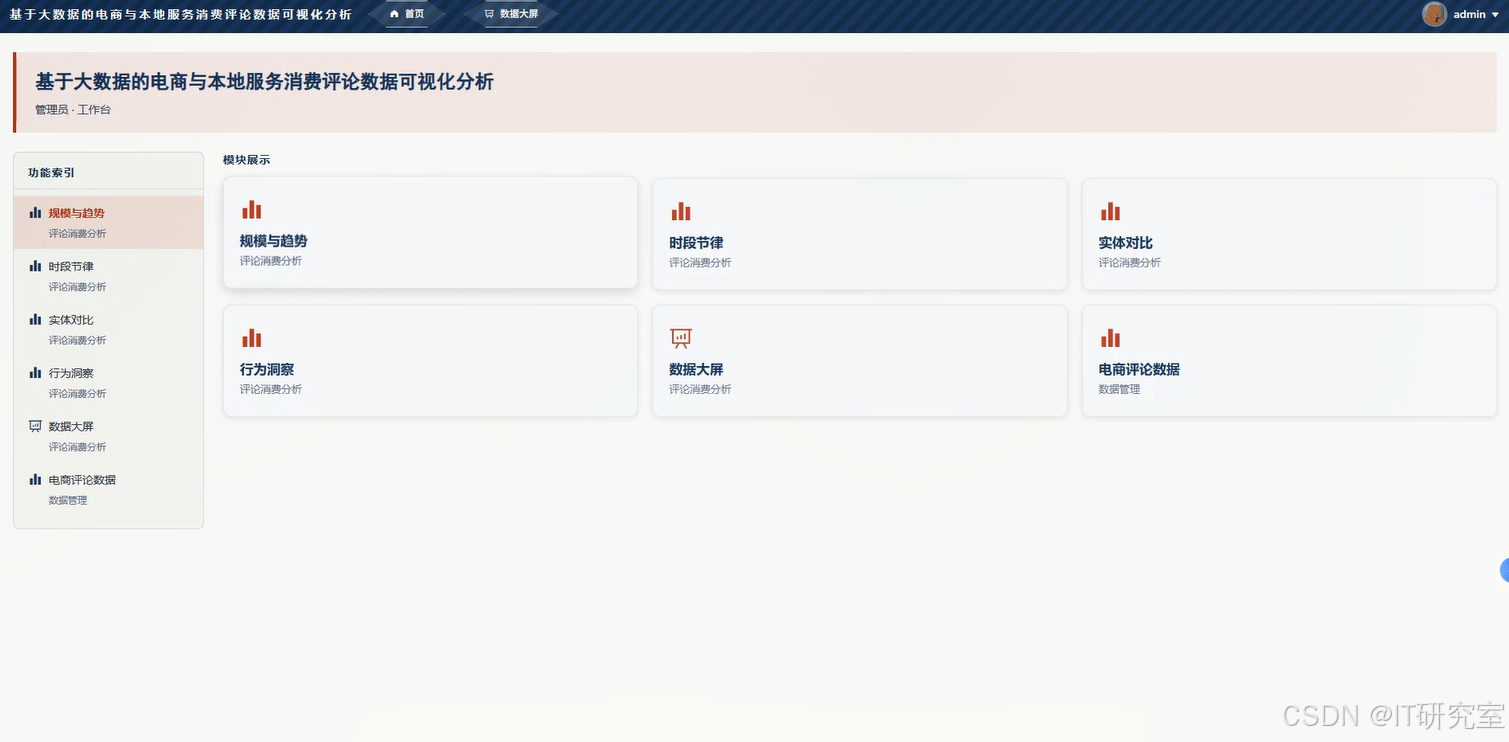
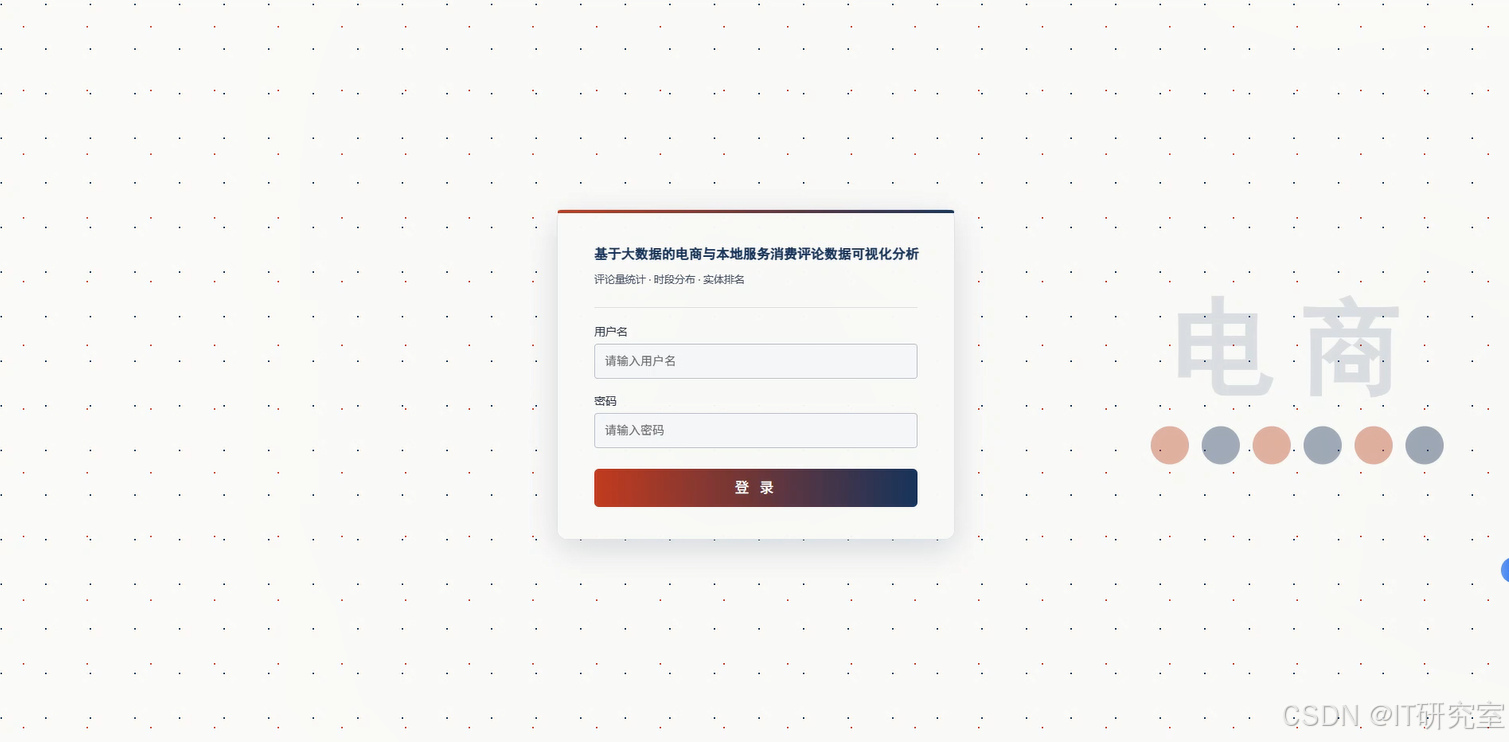
- 基于大数据的电商与本地服务消费评论数据可视化分析界面展示:
四、代码参考
- 项目实战代码参考:
1from pyspark.sql import SparkSession
2from pyspark.sql.functions import col, count, sum as spark_sum, avg, date_format, hour, to_date, when, desc
3from pyspark.sql.types import StructType, StructField, StringType, IntegerType, FloatType
4
5spark = SparkSession.builder.appName("EcommerceCommentAnalysis").config("spark.sql.adaptive.enabled", "true").config("spark.sql.adaptive.coalescePartitions.enabled", "true").getOrCreate()
6
7# 功能1:评论规模与趋势分析
8def analyze_comment_trend(start_date, end_date):
9    df = spark.read.option("header", "true").option("encoding", "UTF-8").csv("hdfs:///data/comments_raw.csv")
10    df_clean = df.filter(col("comment_time").isNotNull()).filter(col("comment_time") != "").filter(col("rating").isNotNull())
11    df_with_date = df_clean.withColumn("comment_date", to_date(col("comment_time"), "yyyy-MM-dd HH:mm:ss"))
12    df_filtered = df_with_date.filter((col("comment_date") >= start_date) & (col("comment_date") <= end_date))
13    df_trend = df_filtered.groupBy("comment_date").agg(count("*").alias("daily_count")).orderBy("comment_date")
14    df_trend_pandas = df_trend.limit(1000).toPandas()
15    df_trend_pandas.to_json("hdfs:///data/output/trend.json", orient="records", force_ascii=False)
16    total_count = df_filtered.count()
17    avg_daily = df_trend.select(avg("daily_count")).collect()[0][0]
18    return {"total": total_count, "avg_daily": round(avg_daily, 2) if avg_daily else 0}
19
20# 功能2:时段节律分析(用户评论活跃时段分布)
21def analyze_time_rhythm():
22    df = spark.read.option("header", "true").option("encoding", "UTF-8").csv("hdfs:///data/comments_raw.csv")
23    df_clean = df.filter(col("comment_time").isNotNull()).filter(col("comment_time") != "")
24    df_hour = df_clean.withColumn("comment_hour", hour(col("comment_time")))
25    df_hour_group = df_hour.groupBy("comment_hour").agg(count("*").alias("comment_count")).orderBy("comment_hour")
26    df_hour_pandas = df_hour_group.limit(100).toPandas()
27    df_hour_pandas.to_json("hdfs:///data/output/time_rhythm.json", orient="records", force_ascii=False)
28    peak_hour_row = df_hour_group.orderBy(desc("comment_count")).first()
29    peak_hour = peak_hour_row["comment_hour"] if peak_hour_row else None
30    avg_hour = df_hour_group.select(avg("comment_count")).collect()[0][0]
31    return {"peak_hour": int(peak_hour) if peak_hour else -1, "avg_per_hour": round(avg_hour, 2) if avg_hour else 0}
32
33# 功能3:实体对比分析(不同商家或商品的评分与评论量对比)
34def compare_entities(entity_type, entity_ids):
35    df = spark.read.option("header", "true").option("encoding", "UTF-8").csv("hdfs:///data/comments_raw.csv")
36    df_clean = df.filter(col("rating").isNotNull()).filter(col("entity_id").isNotNull()).filter(col("entity_name").isNotNull())
37    if entity_ids:
38        df_filtered = df_clean.filter(col("entity_id").isin(entity_ids))
39    else:
40        df_filtered = df_clean
41    df_compare = df_filtered.groupBy("entity_id", "entity_name").agg(
42        count("*").alias("comment_count"),
43        avg("rating").alias("avg_rating"),
44        spark_sum(when(col("rating") >= 4, 1).otherwise(0)).alias("positive_count"),
45        spark_sum(when(col("rating") <= 2, 1).otherwise(0)).alias("negative_count")
46    ).orderBy(desc("comment_count"))
47    df_result = df_compare.withColumn("positive_rate", (col("positive_count") / col("comment_count") * 100).cast("double"))
48    df_result_pandas = df_result.limit(500).toPandas()
49    df_result_pandas.to_json("hdfs:///data/output/entity_compare.json", orient="records", force_ascii=False)
50    top_entity = df_result.orderBy(desc("comment_count")).first()
51    return {"top_entity_name": top_entity["entity_name"] if top_entity else None, "total_entities": df_result.count()}
52
五、系统视频
基于大数据的电商与本地服务消费评论数据可视化分析项目视频:
演示视频
结语
最新大数据毕业设计选题推荐-基于大数据的电商与本地服务消费评论数据可视化分析-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇
《最新大数据毕业设计选题推荐-基于大数据的电商与本地服务消费评论数据可视化分析-大数据-Spark-Hadoop-Bigdata》 是转载文章,点击查看原文。
