在学 MySQL 时,我们常说:
mysql 是客户端,mysqld 是服务端;
创建数据库后,/var/lib/mysql 下就多了一个文件夹;
备份就是用 mysqldump 把 SQL 语句保存下来,还原就是 source 执行一遍;
存储引擎决定了数据怎么存、怎么索引、怎么锁。
这些话背后藏着几个值得深究的问题:
- MySQL 的 C/S 架构到底是怎么工作的?
- 存储引擎(InnoDB / MyISAM)到底解决什么问题,为什么说它是 "发动机"?
- DCL 和事务(commit)到底是不是一回事?
- show processlist 里为什么有两条记录,其中一条是 mysqld 吗?
我们从第一个问题入手。
一、什么是 MySQL
1.1 本质:一个基于 C/S 模式的网络服务
MySQL 本质上是一个网络服务:mysql 是客户端,mysqld 是服务端(守护进程)。换句话说,这是一个基于 C/S(Client/Server)模式的软件。
- mysql:客户端程序(CLI 命令行工具),用户敲命令的地方;
- mysqld:服务端守护进程,真正干活的地方 —— 接收指令、分析语法、执行操作、返回结果。
客户端和服务端可以不在同一台机器(通过 -h 指定 IP 连接),也可以在同一台机器 —— 单机开发时,你的主机上同时运行着两个进程:一个 mysql 客户端进程、一个 mysqld 服务端进程。准确说法是 "这台机器同时是客户端和服务端"。
默认通过 TCP/IP 的 3306 端口通信;本地登录时也可走 Unix socket 文件(/var/run/mysqld/mysqld.sock),速度更快。
1.2 mysqld 提供什么服务
mysqld 提供的是数据库服务(Database Management System,DBMS 服务)。
1.3 什么是数据库服务
我们知道,所有的数据在硬盘中的存储方式都是二进制的。换句话说,以往所有的目录 / 普通文件,都只是将信息存储在对应的 data block 中 ——没有对数据进行加工存储!
而我们往后存储数据,不再是简单地存储到外存中,而是将数据通过数据库加工存储的形式存储到外存中。
所谓 "加工",就是数据库额外做的事:
1- 结构化:建库、建表,按"行 × 列"组织数据
2- 约束与类型:每列有明确的数据类型和约束,保证数据合法性
3- 索引:加速查找
4- 事务:保证数据的一致性和可靠性(ACID)
5- 并发控制:多用户同时读写不出错
6- 备份与恢复
7
一句话:文件系统只负责 "把字节存下来",数据库负责 "把数据组织得又快又可靠"。
1.4 登录操作
1mysql -h IP -P 端口 -u 用户 -p
2
| 选项 | 含义 | 说明 |
|---|---|---|
| -h | 要连接的 MySQL 服务器 IP | host,默认本机 |
| -P | 要连接的 MySQL 客户端端口号 | 默认 3306 |
| -u | 要登录 MySQL 的哪一个用户 | 如 root |
| -p | 登录密码 | 见下方注意 |
注意:-P 和 -p 的意义不同—— 大写 P 是端口(Port),小写 p 是密码(password)。
两个实操细节:
- -p 与密码之间不能有空格:
mysql -u root -p123456合法,mysql -u root -p 123456会被解析成 "密码为空、123456 是要连接的库名"; - 生产环境不建议把密码直接写在命令行:会暴露在 shell 历史和 ps 输出里。更安全的做法是只写
-p,回车后交互输入密码。
二、常见的数据库服务软件
| 软件 | 厂商 / 来源 | 特点 | 适用场景 |
|---|---|---|---|
| SQL Server | 微软 | .Net 程序员的最爱,Windows 平台为主 | 中大型项目 |
| Oracle | 甲骨文 | 功能全面、稳定性与并发能力都很强,适合超大规模和复杂业务逻辑;短板是商业授权贵、运维复杂 | 大型项目、复杂业务 |
| MySQL | 甲骨文(Oracle 收购 Sun 后归其所有) | 世界上最受欢迎的数据库,并发性好(InnoDB 行锁 + MVCC),简单 SQL 处理效果好,但不适合过于复杂的业务 | 电商、SNS、论坛 |
| PostgreSQL | 加州大学伯克利分校计算机系开发 | 开源关系型数据库,免费使用、修改和分发(私用 / 商用 / 学术均可),功能强大,复杂查询能力强 | 复杂查询、数据分析、地理信息等 |
| SQLite | 开源 | 轻量级嵌入式数据库,遵守 ACID,包含在相对小的 C 库中,占用资源极低,嵌入式设备可能只要几百 K 内存 | 嵌入式产品、移动端 |
| H2 | 开源(Java) | 用 Java 开发的嵌入式数据库,本身只是一个类库,可直接嵌入应用项目 | Java 应用内嵌数据库 |
"Oracle 并发一般来说不如 MySQL" 表述不准确 ——Oracle 在超大规模并发与复杂事务处理上并不弱于 MySQL,甚至更强。两者真正拉开差距的是成本与运维复杂度,而不是并发能力。
三、客户端与服务端的交互模型
相当于 client 端向 server 端发送命令,server 端接收到指令之后进行分析,接着通过对应的指令(前提是正确)执行客户想要执行的操作。
1客户端 mysql ──发送 SQL──> 服务端 mysqld
2                              │ 词法/语法分析 → 优化 → 执行
3客户端 <──返回结果集──────────┘
4
这里要说明的是:单机部署时,我们的主机同时运行着客户端进程和服务端进程,所以 "server 能够直接对我们的主机进行操作"—— 本质是 mysqld 以操作系统用户身份读写 /var/lib/mysql 下的数据文件。
四、数据库服务的类型:SQL 分类
SQL 按功能分为以下几类:
| 类别 | 全称 | 作用 | 代表指令 |
|---|---|---|---|
| DDL | Data Definition Language 数据定义语言 | 维护存储数据的结构 | create、drop、alter(还有 truncate) |
| DML | Data Manipulation Language 数据操纵语言 | 对数据进行操作 | insert、delete、update |
| DQL | Data Query Language 数据查询语言 | 查询数据(可视为 DML 中单独分出来的一类) | select |
| DCL | Data Control Language 数据控制语言 | 权限管理 | grant、revoke |
| TCL | Transaction Control Language 事务控制语言 | 事务管理(补充) | commit、rollback、savepoint、start transaction |
五、存储引擎(重点:讲清楚)
5.1 到底什么是存储引擎
既然 MySQL 是数据库软件,为什么还要有 "存储引擎" 这层东西?
关键在于分层:MySQL 的架构分两层 ——
1┌─────────────────────────────────────────────┐
2│  SQL 层(MySQL 服务器本身)                    │
3│  负责:语法解析、权限校验、优化、连接管理……      │
4│  这一层对外的表现就是"SQL 接口"                 │
5├─────────────────────────────────────────────┤
6│  存储引擎层(可插拔)                          │
7│  负责:数据到底怎么存、怎么建索引、              │
8│        怎么加锁、怎么更新查询、怎么保证事务       │
9└─────────────────────────────────────────────┘
10
存储引擎 = 数据库管理系统 "如何存储数据、如何为存储的数据建立索引、如何更新和查询数据" 这些底层技术的具体实现。
打个比方:MySQL 服务器是车,存储引擎是发动机。车身、方向盘、仪表盘(SQL 层)都一样,但换上不同的发动机(引擎),加速、油耗、稳定性、能不能越野(事务、行锁、外键)完全不同。所以 MySQL 说自己是 "可插拔存储引擎" 架构 —— 同一套 SQL 语法,底层实现可以自由切换。
查看当前 MySQL 支持哪些引擎:
1show engines;
2
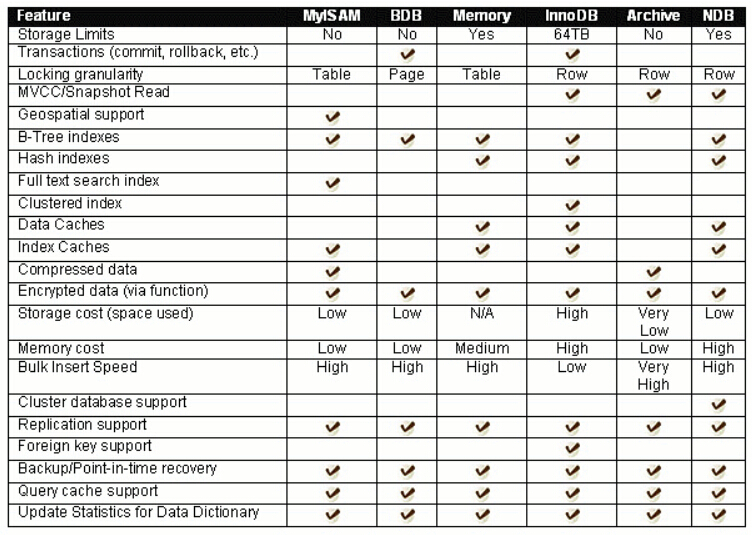 5.2 常用的 InnoDB 和 MyISAM
| 对比项 | InnoDB(默认) | MyISAM(老引擎) |
|---|---|---|
| 事务(ACID) | ✅ 支持 | ❌ 不支持 |
| 锁粒度 | 行级锁(并发好) | 表级锁(并发差) |
| 外键 | ✅ 支持 | ❌ 不支持 |
| 索引结构 | 聚簇索引(数据与索引在一起) | 非聚簇索引 |
| 崩溃恢复 | ✅ 支持(redo log) | ❌ 较弱 |
| 磁盘文件 | .ibd(表数据 + 索引) | .MYD(数据)+ .MYI(索引) |
| 适用场景 | 绝大多数业务:电商、社交、金融 | 历史遗留库、只读查询密集场景 |
结论:现代 MySQL 默认就是 InnoDB,绝大多数业务直接用默认即可;MyISAM 因不支持事务、表级锁并发差,已逐渐被取代(但老系统里常见,认识它主要用于排查历史库)。
5.3 如何指定引擎
建表时显式指定:
1create table t (id int) engine=InnoDB;
2
已有表也可以改引擎:
1alter table t engine=InnoDB;
2
六、数据库(database)的操作
6.1 创建数据库
1create database (if not exists) xxx;
2
- MySQL 中以 ; 作为命令行结束符;
if not exists:如果库已存在则不报错(否则会报错);- 例如:
1create database if not exists bksw;
2
6.2 查看有哪些数据库
1show databases;
2
执行后就能看到对应的 bksw 数据库。
6.3 数据库文件存储在哪里
可是我们讲过,MySQL 只是提供管理数据的功能,但数据库(管理 + 数据)仍然需要存储在外存中 ——Linux 文件系统那篇笔记(从磁盘物理结构到 inode、dentry 与挂载)仍然是需要学习的。
Ubuntu 默认存储在 /var/lib/mysql 中。这里和之前 process 那部分类似:创建了一个 database,就会出现一个文件夹。之前的进程、设备走的是 "一切皆文件" 的思想,通过文件系统和挂载将文件与内核联系起来;而 MySQL 是更简单的存储 ——一个数据库 = 该目录下的一个文件夹,文件夹里放着这个库的表数据文件(InnoDB 是 .ibd 文件等;MySQL 8.0 中表结构定义统一存进数据字典,不再有单独的 .frm)。
6.4 如何使用这个数据库
1use xxx;
2
例如 use bksw;—— 可以理解成 cd bksw,表示 "后续操作都进入 bksw 这个库"。
6.5 自定义数据库字符集和校验规则
字符集(charset):数据存入对应数据库时采用的编码标准,解决 "用什么字节表示字符" 的问题(如 utf8mb4 支持 emoji、四字节字符)。
校验规则(collation):数据比较与排序时采用的规则 —— 解决 "怎么比大小、怎么排序" 的问题,典型差异是大小写是否敏感:
1utf8mb4_general_ci  → ci = case insensitive,大小写不敏感
2utf8mb4_bin         → 按二进制比较,大小写敏感
3
(原笔记 "校验规则是数据从数据库取出采用的标准" 不够准确 —— 取出的字节就是存进去的字节,collation 影响的是比较 / 排序,比如 WHERE 和 ORDER BY 的行为。)
所以字符集和校验规则要选互相兼容的! 每个字符集都有一组配套的校验规则(collation),不能乱配。
查看命令:
1show charset;                                          -- 查看支持的字符集
2show collation;                                        -- 查看支持的校验规则
3show variables like 'character_set_database';          -- 当前库默认字符集
4show variables like 'collation_database';              -- 当前库默认校验规则
5
创建数据库时可以显式指定字符集和校验规则:
1create database if not exists xxx charset=想要的字符集 collate=想要的校验规则;
2
6.6 查看创建 database 执行指令
1show create database xxx;    -- 表格方式显示
2show create database xxx \G; -- 垂直/命令行方式显示
3
示例输出:
1+----------+---------------------------------------------------------------------+
2| Database | Create Database                                                    |
3+----------+---------------------------------------------------------------------+
4| bksw     | CREATE DATABASE `bksw` /*!40100 DEFAULT CHARACTER SET utf8mb3 */   |
5|          | /*!80016 DEFAULT ENCRYPTION='N' */                                  |
6+----------+---------------------------------------------------------------------+
7
这里解释两个看着奇怪的注释:
- 版本条件注释
/*!40100 ... */:这是 MySQL 的扩展注释,格式是/*!版本号 内容 */。意思是当 MySQL 版本 >= 4.01 时才执行其中的内容,低版本会忽略。所以/*!40100 DEFAULT CHARACTER SET utf8mb3 */表示 "高版本执行:默认字符集 utf8mb3"; utf8mb3是utf8的旧名(MySQL 8.0 起明确区分),示例里这个库是老版本创建的;MySQL 8.0 新库默认字符集是 utf8mb4(更推荐)。
6.7 修改数据库
主要修改字符集和校验规则:
1alter database xxx charset=xxx collate=xxx;
2
为什么不建议修改数据库的名字? 因为上层应用已经引用了这个库,轻易修改会造成严重后果;而且 ALTER DATABASE 本身就没有提供修改库名的功能。所以数据库名字要在创建前想好,要改名只能导出再导入。
6.8 删除数据库
1drop database (if exists) xxx;
2
执行这个操作之后,/var/lib/mysql 下对应的文件夹会被删除,换句话说数据会全部消失。因此删除之前应该尽量备份数据。
6.9 备份数据库
在 shell 中输入指令:
1mysqldump -P 端口 -u 用户 -p -B 库名 > 保存路径
2
| 选项 | 含义 |
|---|---|
| -P | 端口号 |
| -u | 用户 |
| -p | 输入密码 |
| -B | 备份整个数据库(会包含 CREATE DATABASE 和 USE 语句) |
接着登入 MySQL:
1source 保存路径;
2
就能够直接还原了。
那所谓的备份到底进行了怎么样的操作? 而这个备份就是将我们执行过的正确指令保存起来。还原的时候,就是执行保存的指令(mysqldump 是逻辑备份,导出的是一堆 CREATE / INSERT SQL 语句)。还原也可以用另一种方式:mysql -u root -p < 备份文件。
如果想要同时保存多个数据库:
1mysqldump -P 端口 -u 用户 -p -B 库1 库2 ... > 保存路径;
2
如果只想要备份某个数据库中的某几张表(修订原文错误):
1mysqldump -P 端口 -u 用户 -p 库名 表1 表2 ... > 保存路径;
2
注意:备份指定表时不能带 -B!-B(--databases)后面的所有参数都会被当作 "数据库名" 处理,把表名混在 -B 后面会报错。不带 -B 时,第一个参数是库名,后面的参数才是表名。
6.10 查看数据库的连接情况(排查非法入侵)
1show processlist;
2
1+-----+-----------------+-----------+---------+---------+---------+------------------------+------------------+
2| Id  | User            | Host      | db      | Command | Time    | State                  | Info             |
3+-----+-----------------+-----------+---------+---------+---------+------------------------+------------------+
4|   5 | event_scheduler | localhost | NULL    | Daemon  | 1194881 | Waiting on empty queue | NULL             |
5| 959 | root            | localhost | test9_8 | Query   |       0 | init                   | show processlist |
6+-----+-----------------+-----------+---------+---------+---------+------------------------+------------------+
7
为什么有两行?难道有一行表示 mysqld?—— 不是。
这两行都是 mysqld 进程内部的线程,含义完全不同:
| 行 | 身份 | 解释 |
|---|---|---|
| 第一行 | event_scheduler | mysqld 的内部后台线程(事件调度器),Command 是 Daemon,一直处于 "等待空队列" 状态,负责调度定时事件,不是外部连接,也不是 "mysqld 本体" |
| 第二行 | root@localhost | 你自己—— 你执行 show processlist 的这个会话,Command 是 Query,Info 里就是正在执行的 show processlist |
所以:一行是系统后台线程,一行是你的客户端会话线程。如果排查非法入侵,重点看 User / Host 列有没有陌生来源、Command 是不是异常的 Query / Sleep。
想看完整的正在执行的 SQL,用:
1show full processlist;
2
七、表(table)的操作
7.1 什么是表(讲清楚)
数据库是用于管理数据的一种结构体,但数据的特征多种多样,因此数据库实际上管理的是表—— 实际存储数据的是表(table)。
类比(呼应 Linux 文件系统笔记):
1数据库 database  ≈  文件夹(命名空间,用于归类)
2表     table    ≈  文件夹里的普通文件(真正装数据的地方)
3行     row      ≈  文件里的一条记录
4列     column   ≈  记录里的一个字段/属性(有类型和约束)
5
数据库 = 表的集合;表 = 二维结构(行 + 列)。 一张表落盘后就是 /var/lib/mysql/ 库名 / 下的数据文件(InnoDB 是 .ibd)。
注意:想要创建表,需要先 use 进入一个数据库!
7.2 创建表
1CREATE TABLE 表名 (
2    field1 datatype,
3    field2 datatype,
4    field3 datatype
5) character set 字符集 collate 校验规则 engine 存储引擎;
6
- 字符集和校验规则默认直接继承数据库的,显式说明则使用显式说明的;
- engine 默认是 InnoDB,你可以显式指定;
- 常见类型示例:int(整数)、varchar (n)(变长字符串)、char (n)(定长字符串)、text、date、datetime 等。
7.3 查看表的结构
1desc 表名;
2
直接查看指定表的结构(属性的名称 + 属性的类型 + 约束)。
7.4 修改表
| 操作 | 语法 | 说明 |
|---|---|---|
| 增加一个属性 | alter table 表名 add 列名 类型; | 添加新列 |
| 修改某一个属性的类型 | alter table 表名 modify 列名 新类型; | 只改类型 / 约束 |
| 删除某一个属性 | alter table 表名 drop 列名; | 删列 |
| 修改表的名字 | alter table 旧名 rename to 新名; | 改表名 |
| 修改表属性的名字 | alter table employee change 旧列名 新列名 varchar(60); | 新字段需要完整定义(新列名 + 类型 + 约束) |
7.5 删除表
1drop table if exists 表名;
2
7.6 为属性添加注释(相当于代码中的注释)
在设置类型的时候加 comment '说明字段':
1create table employee (
2    name varchar(60) comment '员工姓名'
3);
4
这里要说:MySQL 中单引号和双引号默认不进行区分,都可以表示字符串(只有在开启 ANSI_QUOTES 模式时,双引号才会被当作标识符而非字符串)。
7.7 查看创建表进行的操作
1show create table 表名;
2
7.8 向表中插入元素
1insert into 表名 (插入的属性) values (插入的值);
2
例如:
1insert into employee (name) values ('张三');
2
八、总结
- MySQL 的本质:基于 C/S 模式的网络服务 ——mysql 是客户端、mysqld 是服务端;提供数据库服务,数据经数据库 "加工"(结构化、索引、事务、并发控制)后存到外存。
- 登录:
mysql -h IP -P 端口 -u 用户 -p,-P(大写)是端口、-p(小写)是密码,二者意义不同;-p 与密码之间不能有空格,生产环境不要明文带密码。 - SQL 分类:DDL(结构)/ DML(数据)/ DQL(查询)/ DCL(权限 grant、revoke)/ TCL(事务 commit、rollback)——commit 属于 TCL,不属于 DCL。
- 存储引擎 = "怎么存、怎么建索引、怎么锁" 的底层实现,是 MySQL 的可插拔 "发动机";InnoDB(默认,事务 + 行锁 + 外键 + 崩溃恢复)vs MyISAM(表锁、无事务,已过时)。
- 库操作:create /show databases /use/show create /alter/drop;落盘在 /var/lib/mysql,一个库一个文件夹;字符集管 "怎么存",校验规则管 "怎么比较排序",必须兼容搭配。
- 备份与还原:mysqldump(逻辑备份 = 导出 SQL 语句)+ source 还原;备份指定表时不能带 -B。
- show processlist 的两行:一行是 mysqld 内部后台线程(event_scheduler),一行是你自己的会话 —— 都不是 "mysqld 本体"。
- 表操作:create(可指定字符集 / 校验规则 / 引擎)/desc/alter(add、modify、drop、rename、change)/drop/comment /show create /insert;数据库 ≈ 文件夹,表 ≈ 文件夹里的文件,行是记录、列是字段.
《从 “什么是 MySQL“ 到库与表的完整操作(MySQL基础篇)》 是转载文章,点击查看原文。


