目录
一、哈希核心概念
1.1 直接定址法
1.2 哈希冲突(哈希碰撞)
1.3 负载因子 load‑factor
1.4 关键字转为整数
二、常见哈希函数
2.1 除留余数法(除法散列法,工程最常用)
2.2 乘法散列法(了解,极少手写)
2.3 全域散列法(了解,对抗恶意哈希攻击)
2.4 字符串哈希 BKDR(面试手写高频)
三、冲突两大解决方案
方案一:开放定址法(Open Addressing)
⚠开放定址法删除的致命问题
开放定址完整代码(线性探测版本)
方案二:链地址法(拉链法 / 哈希桶,STL 底层实现)
链地址法完整实现
四、rehash 重哈希机制
五、开放定址法 vs 链地址法对比
六、大厂面试高频问答
Q1:什么是哈希冲突?冲突能不能完全避免?
Q2:负载因子是什么?负载因子为什么不能无限放大?
Q3:开放定址法为什么删除不能直接清空位置?为什么要用 DELETE 标记?
Q4:链地址法 rehash 做什么?rehash 之后迭代器会怎么样?
Q5:除留余数法 M 为什么建议取质数?Java HashMap 为什么 M 是 2 的幂?
Q6:链地址法的最坏情况?Java8 HashMap 如何优化?C++ unordered 有没有这个优化?
Q7:BKDR 字符串哈希思路?为什么不能直接累加 ascii 码?
Q8:开放定址线性探测、二次探测优缺点?
七、开发易错坑清单
一、哈希核心概念
哈希(散列 hash):建立关键字 key 与存储位置之间直接映射关系。 通过哈希函数,输入 key,直接算出该 key 应当存放在数组的下标位置;查找时直接计算下标访问,理想情况下不需要遍历比较,实现O (1) 查找。
普通二叉搜索树:依靠比较大小,\(O(logN)\); 哈希表:直接算地址,理想平均\(O(1)\)。
1.1 直接定址法
最简单哈希,key 本身或者简单运算结果就是数组下标,不需要复杂哈希函数。 适用场景:关键字范围集中、连续。 公式:
\(h(key) = key \quad \text{或者} \quad h(key)=key-offset\)
示例:小写字母,ch-'a'得到 0‑25,作为数组下标;
力扣 387 字符串第一个唯一字符就是典型直接定址法。387. 字符串中的第一个唯一字符 - 力扣(LeetCode)
1class Solution {
2public:
3    int firstUniqChar(string s) {
4        int count[26] = {0};
5        for(auto ch : s)
6        {
7            count[ch-'a']++;
8        }
9        for(size_t i = 0; i < s.size(); ++i)
10        {
11            if(count[s[i]-'a'] == 1)
12                return i;
13        }
14        return -1;
15    }
16};
17
缺点:key 范围分散,会开辟巨大数组,内存浪费严重。比如 key 取值 0~10000,但实际只有十几个数据,直接定址法不可行。
1.2 哈希冲突(哈希碰撞)
不同的 key,经过哈希函数计算,得到同一个数组下标,叫做哈希冲突 / 哈希碰撞。
现实中,冲突无法完全杜绝,只能:
- 设计优秀哈希函数,尽可能减少冲突概率;
- 设计冲突解决算法,发生冲突时可以正常存、取数据。
1.3 负载因子 load‑factor
\(load\_factor = \frac{有效元素数量N}{哈希表桶/数组总大小M}\)
- 负载因子越大:数组装的越满,冲突概率越高,空间利用率高;
- 负载因子越小:冲突概率低,但是大量数组位置空闲,内存浪费。
开放定址法:负载因子必须小于 1,没有多余空位就无法存放冲突元素; 链地址法(拉链法):负载因子可以大于 1;STL
unordered_xxx默认max_load_factor=1.0,超过就 rehash 扩容。
1.4 关键字转为整数
哈希计算下标,需要输入是整数; 如果 key 是string、自定义结构体,不能直接取模,需要哈希仿函数,把 key 转换成size_t无符号整数,之后再对 M 取模得到下标。
二、常见哈希函数
2.1 除留余数法(除法散列法,工程最常用)
\(h(key)=key \bmod M\) M 是哈希表数组大小,得到结果范围 \([0, M-1]\)。
理论建议:M 尽量选择质数,不要取 2 的幂、10 的幂。 如果 M 是\(2^x\),取模等价只保留 key 二进制后 x 位;高位信息全部丢失,容易大量冲突。
补充实践特例(Java HashMap): Java HashMap 哈希桶大小强制是 2 的整数次幂;不直接
key%M,做扰动函数:把 key 高 bit 和低 bit 异或,让高位也参与哈希计算,弥补 M 为 2 幂的缺陷。 理论教材建议 M 质数,工程库可以做扰动函数后用 2 次幂,两种思路都可行。
2.2 乘法散列法(了解,极少手写)
\(h(key)= floor\big(M \times ((A\times key)\bmod 1.0)\big)\) \(0<A<1\),Knuth 推荐黄金分割 \(A=(\sqrt5-1)/2≈0.618\)。 优点:对 M 没有质数要求。
2.3 全域散列法(了解,对抗恶意哈希攻击)
攻击者可以针对固定哈希函数,专门构造一批 key 全部落到同一个桶,直接退化 O (N)。 全域散列:初始化的时候随机从一组哈希函数挑选一个,程序运行全程固定这一个哈希函数。
注意:插入、查找必须用同一个哈希函数,不能每次随机选,否则找不到数据。
2.4 字符串哈希 BKDR(面试手写高频)
string 不能直接转整数;BKDR 哈希算法,每个字符参与计算,减少冲突。
1template<>
2struct HashFunc<string>
3{
4    size_t operator()(const string& key)
5    {
6        size_t hash = 0;
7        for(auto ch : key)
8        {
9            hash *= 131; // 质数31、131、13331都常用
10            hash += ch;
11        }
12        return hash;
13    }
14};
15
不能简单直接累加字符 ascii 码,
"abcd"与"bcad"字符和相等,发生哈希冲突。
三、冲突两大解决方案
方案一:开放定址法(Open Addressing)
所有数据全部存放在哈希数组内部;冲突就按照规则继续向后寻找数组内下一个空闲位置。 ⚠开放定址负载因子必须小于 1,数组必须有空位。
细分三种探测策略:
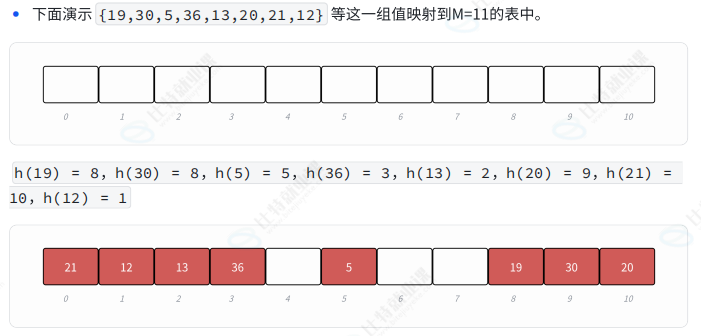
1.线性探测 冲突位置hash0,不断 + 1 取模向后找空位:
\(hash_i = (hash0+i)\bmod M,\quad i=1,2...\) ✅实现简单;
❌严重缺陷:聚集(群集),连续冲突的数据扎堆挤在一起,查找探测距离越来越长,性能恶化。
2.二次探测
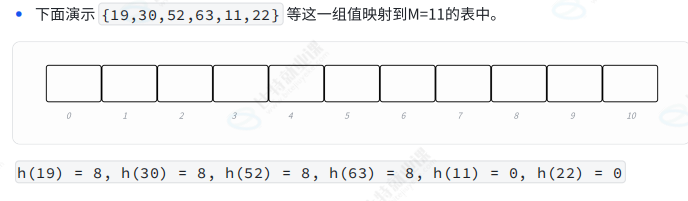
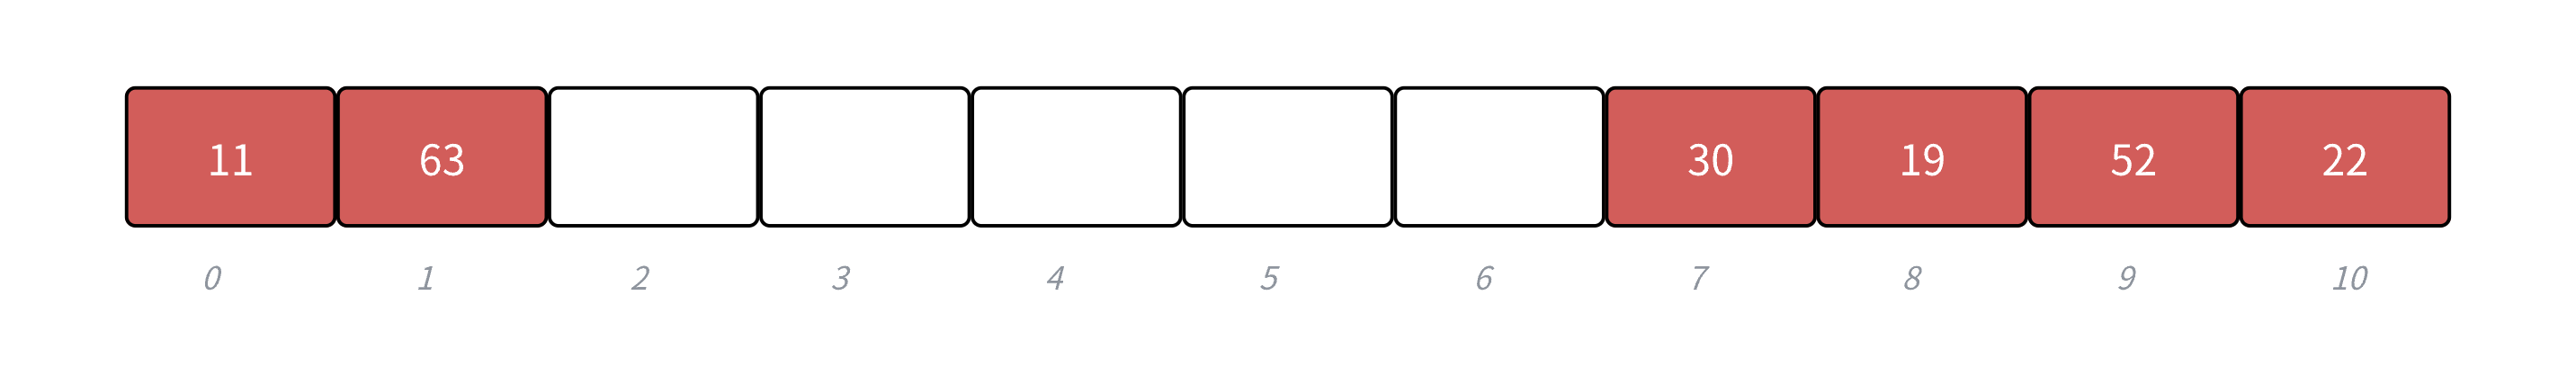
\(hash_i=(hash0 \pm i^2)\bmod M\) 冲突后按照 i 的平方跳跃,缓解聚集问题;依然会有二次聚集。
3.双重散列(双重探测) 准备第二个哈希函数算出偏移量:
\(hash_i=(hash0+i*h_2(key))\bmod M\) 要求\(h_2(key)\)与 M 互质,可以遍历整个哈希数组。
⚠开放定址法删除的致命问题
不能直接把位置置空!
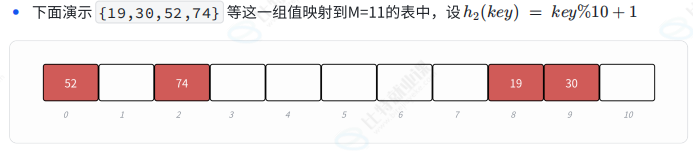
举例:19、30 发生冲突,19 存 hash0,30 存 hash0+1;如果直接清空 30 位置;后续查找 30,探测遇到
EMPTY直接终止,找不到后面合法有效数据。
✅解决:每个数组单元增加状态标记,三种状态:
1enum State
2{
3    EXIST,   //有效存在数据
4    EMPTY,   //未被使用,空
5    DELETE   //逻辑删除,曾经存过,现在删除
6};
7
删除操作:只修改状态为 DELETE,不置为空;查找遇到 EMPTY 才停止,遇到 DELETE 继续向后探测。只有插入的时候可以覆盖 DELETE 位置。
开放定址完整代码(线性探测版本)
1#include<iostream>
2#include<vector>
3#include<string>
4#include<algorithm>
5using namespace std;
6
7template<class K>
8struct HashFunc
9{
10    size_t operator()(const K& key)
11    {
12        return (size_t)key;
13    }
14};
15
16template<>
17struct HashFunc<string>
18{
19    size_t operator()(const string& key)
20    {
21        size_t hash = 0;
22        for(auto ch : key)
23        {
24            hash *= 131;
25            hash += ch;
26        }
27        return hash;
28    }
29};
30
31enum State
32{
33	EXIST,
34	EMPTY,
35	DELETE
36};
37
38template<class K,class V>
39struct HashData
40{
41	pair<K,V> _kv;
42	State _state = EMPTY;
43};
44
45//STL质数表
46inline unsigned long __stl_next_prime(unsigned long n)
47{
48	static const int __stl_num_primes = 28;
49	static const unsigned long __stl_prime_list[__stl_num_primes] =
50	{
51		53, 97, 193, 389, 769,
52		1543, 3079, 6151, 12289, 24593,
53		49157, 98317, 196613, 393241, 786433,
54		1572869, 3145739, 6291469, 12582917, 25165843,
55		50331653, 100663319, 201326611, 402653189, 805306457,
56		1610612741, 3221225473, 4294967291
57	};
58	const unsigned long* first = __stl_prime_list;
59	const unsigned long* last = __stl_prime_list + __stl_num_primes;
60	const unsigned long* pos = lower_bound(first,last,n);
61	return pos == last ? *(last-1) : *pos;
62}
63
64template<class K,class V,class Hash=HashFunc<K>>
65class HashTable
66{
67private:
68	vector<HashData<K,V>> _tables;
69	size_t _n = 0; //有效元素个数
70public:
71	HashTable()
72	{
73		_tables.resize(__stl_next_prime(0));
74	}
75
76	HashData<K,V>* Find(const K& key)
77	{
78		Hash hs;
79		size_t hash0 = hs(key) % _tables.size();
80		size_t hashi = hash0;
81		size_t i = 1;
82		while(_tables[hashi]._state != EMPTY)
83		{
84			if(_tables[hashi]._state == EXIST && _tables[hashi]._kv.first == key)
85			{
86				return &_tables[hashi];
87			}
88			hashi = (hash0 + i) % _tables.size();
89			i++;
90		}
91		return nullptr;
92	}
93
94	bool Insert(const pair<K,V>& kv)
95	{
96		if(Find(kv.first) != nullptr)
97			return false;
98		//负载因子大于0.7触发扩容
99		if(_n * 10 / _tables.size() >= 7)
100		{
101			HashTable<K,V,Hash> newHT;
102			newHT._tables.resize(__stl_next_prime(_tables.size()+1));
103			for(size_t i=0;i<_tables.size();i++)
104			{
105				if(_tables[i]._state == EXIST)
106				{
107					newHT.Insert(_tables[i]._kv);
108				}
109			}
110			_tables.swap(newHT._tables);
111		}
112
113		Hash hs;
114		size_t hash0 = hs(kv.first) % _tables.size();
115		size_t hashi = hash0;
116		size_t i =1;
117		while(_tables[hashi]._state == EXIST)
118		{
119			hashi = (hash0+i) % _tables.size();
120			i++;
121		}
122		_tables[hashi]._kv = kv;
123		_tables[hashi]._state = EXIST;
124		_n++;
125		return true;
126	}
127
128	bool Erase(const K& key)
129	{
130		auto ret = Find(key);
131		if(ret == nullptr)
132			return false;
133		ret->_state = DELETE; //逻辑删除,不是清空
134		_n--;
135		return true;
136	}
137};
138
开放定址法缺点总结:
- 删除不能直接置空,只能逻辑删除标记 DELETE;
- 聚集问题,冲突多之后探测距离变长;
- 负载因子必须小于 1,数组不能填满。
C++ STL 的
unordered_set/unordered_map没有使用开放定址法,使用链地址法。
方案二:链地址法(拉链法 / 哈希桶,STL 底层实现)
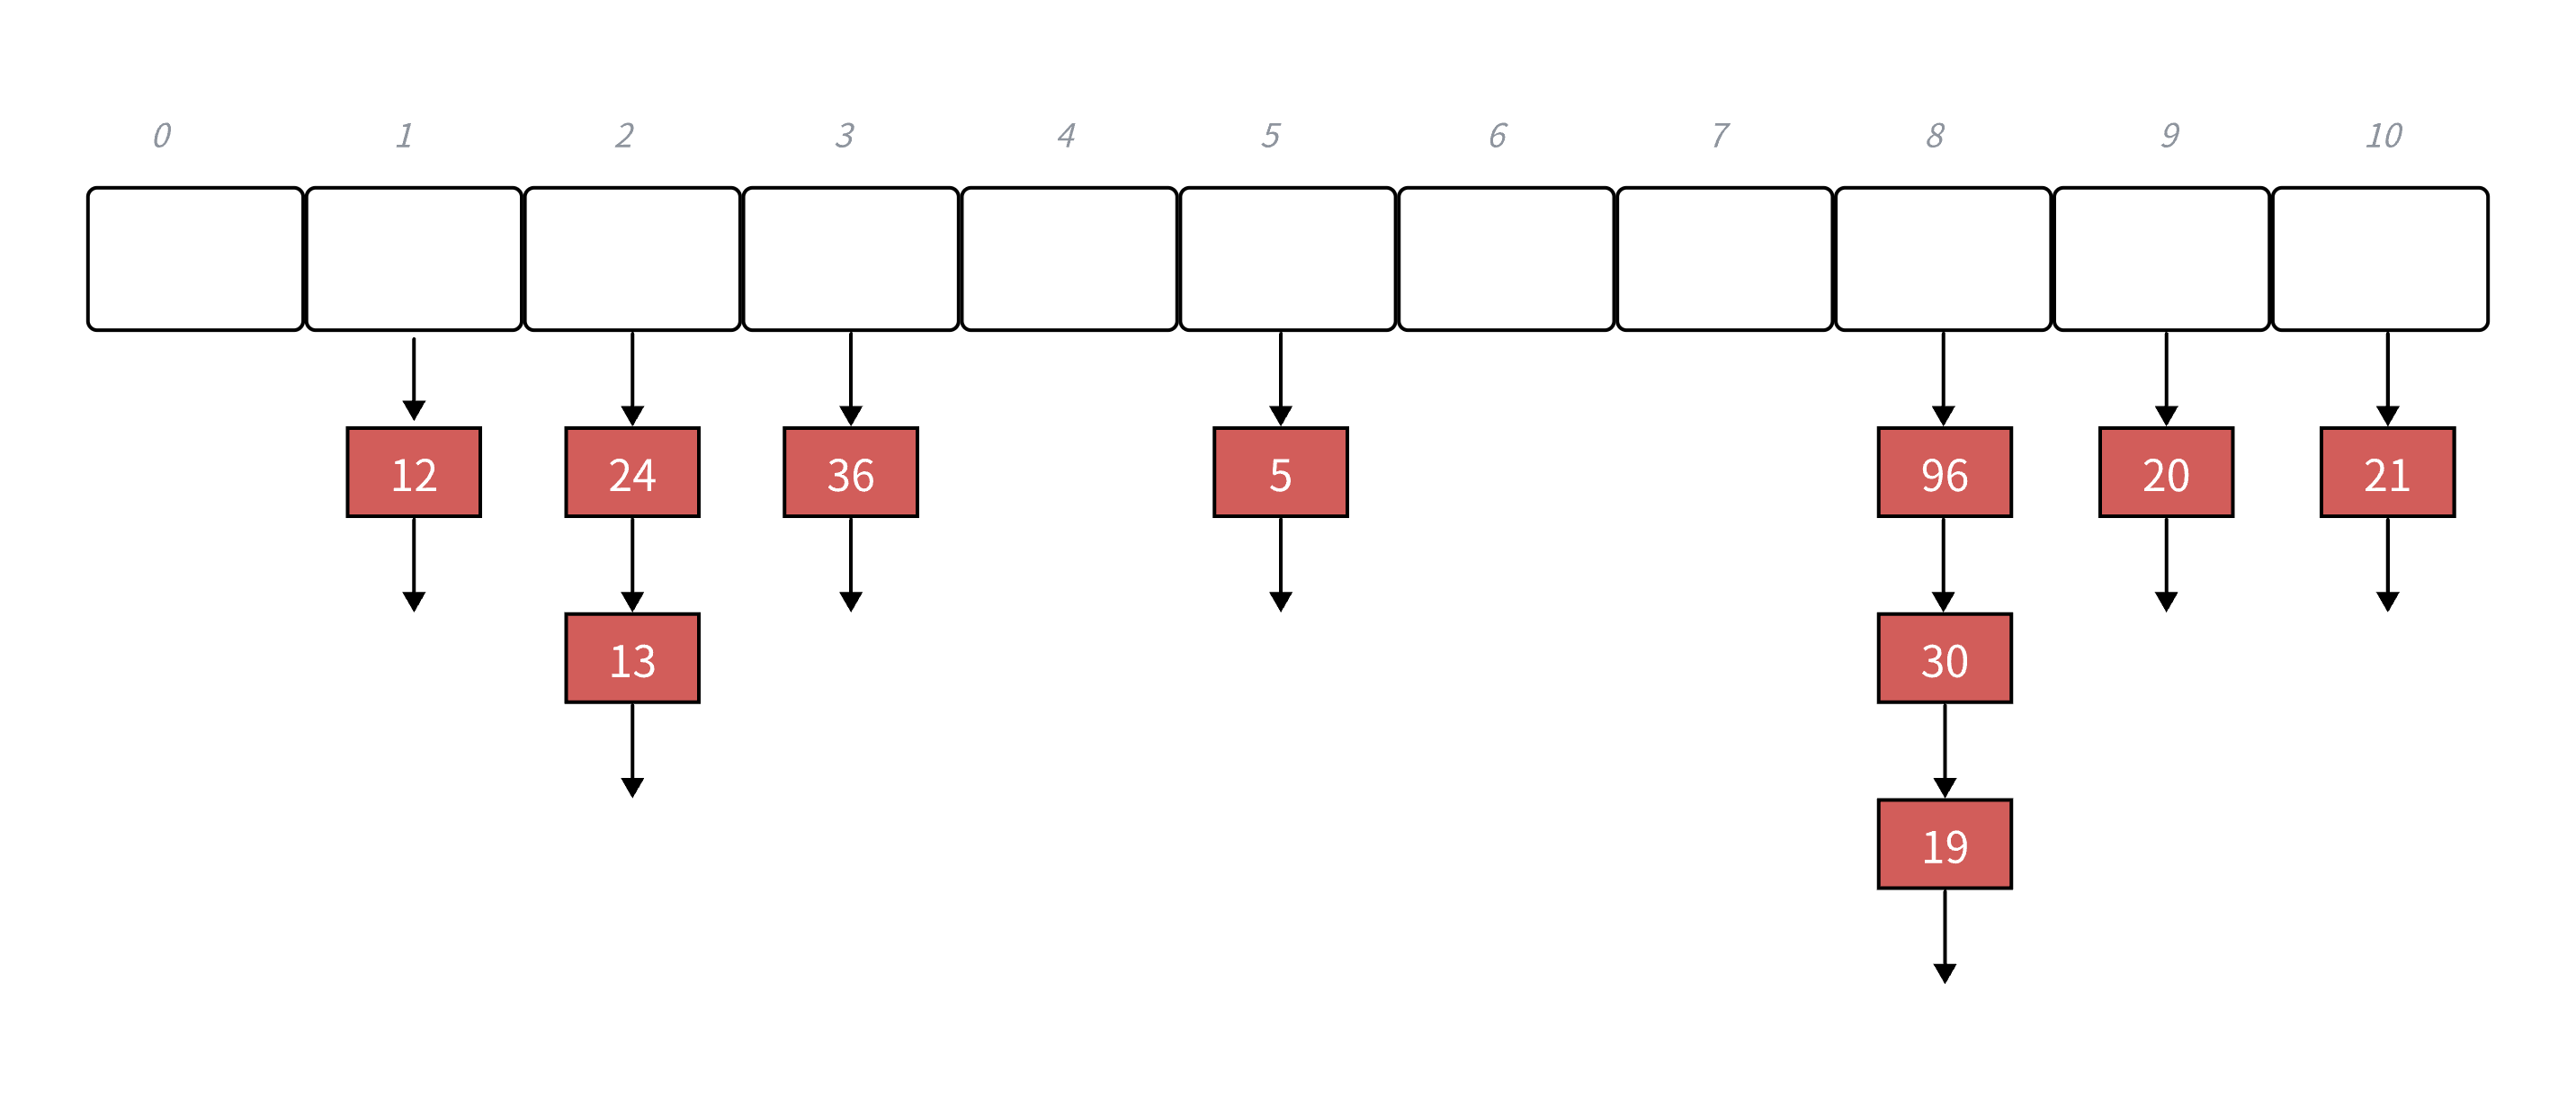
哈希数组每个下标存放单向链表的头指针; key 算出下标,如果冲突,冲突结点直接挂载到同一个桶下的单向链表。 数组叫哈希桶数组,每个数组元素就是一个 bucket 桶。
特点:
- 允许负载因子 > 1;STL 默认 max_load_factor=1.0,超过就 rehash;
- 冲突元素直接挂链表,不会干扰别的桶;没有开放定址的聚集问题;
- 极端最坏情况:所有 key 全部冲突落到同一个桶,退化成单链表,增删查 O (N)。
下⾯演⽰ {19,30,5,36,13,20,21,12,24,96} 等这⼀组值映射到M=11的表中。
h(19) = 8 , h(30) = 8 , h(5) = 5 , h(36) = 3 , h(13) = 2 , h(20) = 9 , h(21) = 10, h(12) = 1,
h(24) = 2,h(96) = 88
Java8 HashMap 优化:链表长度超过阈值(8)链表转红黑树,降低最坏时间复杂度。C++ 标准库 unordered 容器没有这个优化。
链地址法完整实现
1#include<iostream>
2#include<vector>
3#include<algorithm>
4#include<string>
5using namespace std;
6
7template<class K>
8struct HashFunc
9{
10    size_t operator()(const K& key)
11    {
12        return (size_t)key;
13    }
14};
15
16template<>
17struct HashFunc<string>
18{
19    size_t operator()(const string& key)
20    {
21        size_t hash = 0;
22        for(auto ch : key)
23        {
24            hash *= 131;
25            hash += ch;
26        }
27        return hash;
28    }
29};
30
31inline unsigned long __stl_next_prime(unsigned long n)
32{
33	static const int __stl_num_primes = 28;
34	static const unsigned long __stl_prime_list[__stl_num_primes] =
35	{
36		53, 97, 193, 389, 769,
37		1543, 3079, 6151, 12289, 24593,
38		49157, 98317, 196613, 393241, 786433,
39		1572869, 3145739, 6291469, 12582917, 25165843,
40		50331653, 100663319, 201326611, 402653189, 805306457,
41		1610612741, 3221225473, 4294967291
42	};
43	const unsigned long* first = __stl_prime_list;
44	const unsigned long* last = __stl_prime_list + __stl_num_primes;
45	const unsigned long* pos = lower_bound(first,last,n);
46	return pos == last ? *(last-1) : *pos;
47}
48
49namespace hash_bucket
50{
51template<class K,class V>
52struct HashNode
53{
54	pair<K,V> _kv;
55	HashNode<K,V>* _next;
56	HashNode(const pair<K,V>& kv)
57		:_kv(kv),_next(nullptr)
58	{}
59};
60
61template<class K,class V,class Hash=HashFunc<K>>
62class HashTable
63{
64	typedef HashNode<K,V> Node;
65private:
66	vector<Node*> _tables;
67	size_t _n = 0; //有效结点数量
68public:
69	HashTable()
70	{
71		_tables.resize(__stl_next_prime(0),nullptr);
72	}
73
74	~HashTable()
75	{
76		for(size_t i = 0; i < _tables.size(); i++)
77		{
78			Node* cur = _tables[i];
79			while(cur)
80			{
81				Node* next = cur->_next;
82				delete cur;
83				cur = next;
84			}
85			_tables[i] = nullptr;
86		}
87	}
88
89	Node* Find(const K& key)
90	{
91		Hash hs;
92		size_t hashi = hs(key) % _tables.size();
93		Node* cur = _tables[hashi];
94		while(cur)
95		{
96			if(cur->_kv.first == key)
97				return cur;
98			cur = cur->_next;
99		}
100		return nullptr;
101	}
102
103	bool Insert(const pair<K,V>& kv)
104	{
105		if(Find(kv.first))
106			return false;
107		Hash hs;
108		//负载因子达到1,触发rehash扩容
109		if(_n == _tables.size())
110		{
111			vector<Node*> newtables(__stl_next_prime(_tables.size()+1),nullptr);
112			for(size_t i=0;i<_tables.size();i++)
113			{
114				Node* cur = _tables[i];
115				while(cur)
116				{
117					Node* next = cur->_next;
118					size_t newhashi = hs(cur->_kv.first) % newtables.size();
119					//头插迁移结点,不需要new新结点
120					cur->_next = newtables[newhashi];
121					newtables[newhashi] = cur;
122					cur = next;
123				}
124				_tables[i] = nullptr;
125			}
126			_tables.swap(newtables);
127		}
128		size_t hashi = hs(kv.first) % _tables.size();
129		Node* newnode = new Node(kv);
130		newnode->_next = _tables[hashi];
131		_tables[hashi] = newnode;
132		_n++;
133		return true;
134	}
135
136	bool Erase(const K& key)
137	{
138		Hash hs;
139		size_t hashi = hs(key) % _tables.size();
140		Node* prev = nullptr;
141		Node* cur = _tables[hashi];
142		while(cur)
143		{
144			if(cur->_kv.first == key)
145			{
146				if(prev == nullptr)
147				{
148					_tables[hashi] = cur->_next;
149				}
150				else
151				{
152					prev->_next = cur->_next;
153				}
154				delete cur;
155				_n--;
156				return true;
157			}
158			prev = cur;
159			cur = cur->_next;
160		}
161		return false;
162	}
163};
164}
165
rehash 扩容关键点:链地址法扩容不需要 new 新结点,直接移动旧结点指针,头插到新哈希桶数组,性能优于重新 Insert。
四、rehash 重哈希机制
- 判断条件:链地址法 STL 默认
load_factor > max_load_factor(1.0)触发 rehash;开放定址一般阈值 0.7。 - 开辟更大哈希数组,新数组大小取质数表下一个质数;
- 遍历旧表全部结点,每个 key 重新计算哈希值,挂载到新数组对应桶;
- swap 交换新旧数组,释放旧数组资源。
rehash 后果:
- 开放定址:全部迭代器失效;
- 链地址法 STL unordered:rehash 发生,全部迭代器失效;没有 rehash,insert 不会让迭代器失效。
业务可以调用
reserve(n)提前预分配桶,减少运行期 rehash 带来性能抖动。
五、开放定址法 vs 链地址法对比
表格
| 对比项 | 开放定址法 | 链地址法(拉链法) |
|---|---|---|
| 冲突存储 | 全部数据存哈希数组内部 | 冲突结点挂单向链表,数组存链表头指针 |
| 负载因子 | 必须 <1,一般 0.7 | 可以大于 1,STL 默认阈值 1.0 |
| 删除 | 不能直接清空,逻辑标记 DELETE | 直接 delete 结点,正常链表删除 |
| 聚集问题 | 存在聚集,探测距离变长 | 无聚集 |
| 最坏复杂度 | O(M) | O (N)(单条链表过长) |
| STL 使用 | C++ 标准库未使用 | unordered_set /unordered_map 底层实现 |
六、大厂面试高频问答
Q1:什么是哈希冲突?冲突能不能完全避免?
不同 key 计算得到相同哈希下标叫哈希冲突。冲突无法 100% 避免;只能靠优秀哈希函数降低冲突概率,再依靠冲突解决算法处理已经发生的冲突。
Q2:负载因子是什么?负载因子为什么不能无限放大?
\(load\_factor=元素数量/桶数组总大小\);负载因子越大冲突概率越高,探测 / 链表遍历变长,性能退化。开放定址必须小于 1,没有空位就无法插入。
Q3:开放定址法为什么删除不能直接清空位置?为什么要用 DELETE 标记?
如果直接置为空,查找探测遇到 EMPTY 就终止,会跳过后面冲突存放在后面位置的有效数据,查找失败。使用 DELETE 逻辑删除标记,查找遇到 DELETE 继续向后探测,插入的时候可以覆盖 DELETE 位置。
Q4:链地址法 rehash 做什么?rehash 之后迭代器会怎么样?
负载因子超过阈值,开辟更大哈希桶数组;全部旧结点重新计算哈希,移动挂载到新数组;旧数组释放。rehash 发生,所有迭代器全部失效。
Q5:除留余数法 M 为什么建议取质数?Java HashMap 为什么 M 是 2 的幂?
M 质数可以减少后几位重复 key 集中冲突;M 取 2 的幂会只保留二进制低位,高位信息丢失,容易冲突。Java HashMap 增加扰动函数,把 key 高低位做异或,让高位也参与哈希计算,弥补 M=2 幂的缺陷,同时利用位运算代替取模,提升计算效率。两种方案各有取舍。
Q6:链地址法的最坏情况?Java8 HashMap 如何优化?C++ unordered 有没有这个优化?
大量 key 哈希落到同一个桶,链表过长,退化 O (N)。Java8:链表长度 > 8,链表转为红黑树。C++ 标准 unordered 容器没有链表转红黑树的优化。
Q7:BKDR 字符串哈希思路?为什么不能直接累加 ascii 码?
hash = hash * 质数 + ch,每一个字符都参与哈希运算。直接累加 ASCII:字符相同顺序不同的字符串,总和一样,发生哈希冲突。
Q8:开放定址线性探测、二次探测优缺点?
线性探测:代码简单,但是严重聚集;二次探测缓解聚集,但依然存在二次聚集。
七、开发易错坑清单
- ❌开放定址删除直接赋值 EMPTY,造成查找失败;必须逻辑 DELETE 标记。
- ❌rehash 之后继续使用旧迭代器,解引用未定义行为。
- ❌链地址扩容的时候,不要 new 新结点,直接移动旧结点指针,否则内存浪费。
- ❌哈希函数只取低位,高位完全丢弃,冲突概率暴涨。
- ✅已知数据规模,调用 reserve 预分配桶,减少运行期 rehash。
参考文档
《【C++进阶】哈希表实现》 是转载文章,点击查看原文。


