从命令到工作流:juejin-cli 如何让写作自动化更可靠

作者:浪遏日期:2026/11/12

juejin-cli 是一个连接本地 Markdown 与掘金发布流程的命令行工具。这篇聊它如何让人和 AI Agent 共享一套可靠的写作工作流。

这篇文章就是使用 juejin-cli 自动化发布的,具体请看下面介绍

安装官网与使用指南 · GitHub 开源项目 · npm 安装包

官网提供安装命令、使用场景和可复制的 Agent 提示词。上图是实际页面截图。

写完一篇技术文章,距离发布完成还有一段重复劳动:填写分类和标签、上传图片、创建草稿、选择专栏,再确认平台是否接受提交。文章积累到十几篇后,这些步骤就值得变成可重复执行的工作流。

我做 juejin-cli,希望本地 Markdown 能成为写作入口,让人和 AI Agent 都可以通过同一套命令完成查询、草稿管理与发布。第一版已经发布到 npm。本文结合实现与实际发布测试,记录其中几个比“封装一个 HTTP 请求”更重要的设计问题。

一、让命令描述能力,让结构化结果连接下一步

普通用户可以查看帮助,Agent 则需要知道参数、必填项和合法选项。juejin-cli 从 Commander 的同一套命令定义生成 schema,避免命令已经修改、另一份手写说明却没有更新。

1juejin schema article publish --json
2juejin draft create ./article.md --dry-run --json
3

--json 模式成功时在 stdout 返回一个 JSON 文档,失败时在 stderr 返回错误文档和非零退出码。调用者可以据此读取 draft_id,交给后面的更新或发布命令,无需从一段自然语言里猜测结果。

这是接口设计的一部分。对 Agent 来说,稳定的结果结构与明确的失败语义,会直接影响整条工作流能否继续。

二、把职责边界放在变化发生的地方

项目的可执行入口只负责启动 CLI。领域命令在 src/cli/commands/ 注册,依赖在 context.ts 组装;平台请求和类型放在 src/platform/juejin/,HTTP 层统一处理业务错误与空数据。

Markdown 解析、图片路径识别和正文替换放在 src/content/。会话、浏览器和 Skill 安装属于运行时。草稿、专栏和发布等写入流程则由 WritingService 编排,负责锁、读取合并与操作回执。

这样的拆分有一个实际好处:平台接口变化时,可以集中修改平台层;用户提示需要调整时,可以修改 CLI 展示;SDK 和 CLI 仍然复用同一套底层能力。命令树也按调用创建实例,避免进程内多次运行互相污染参数。
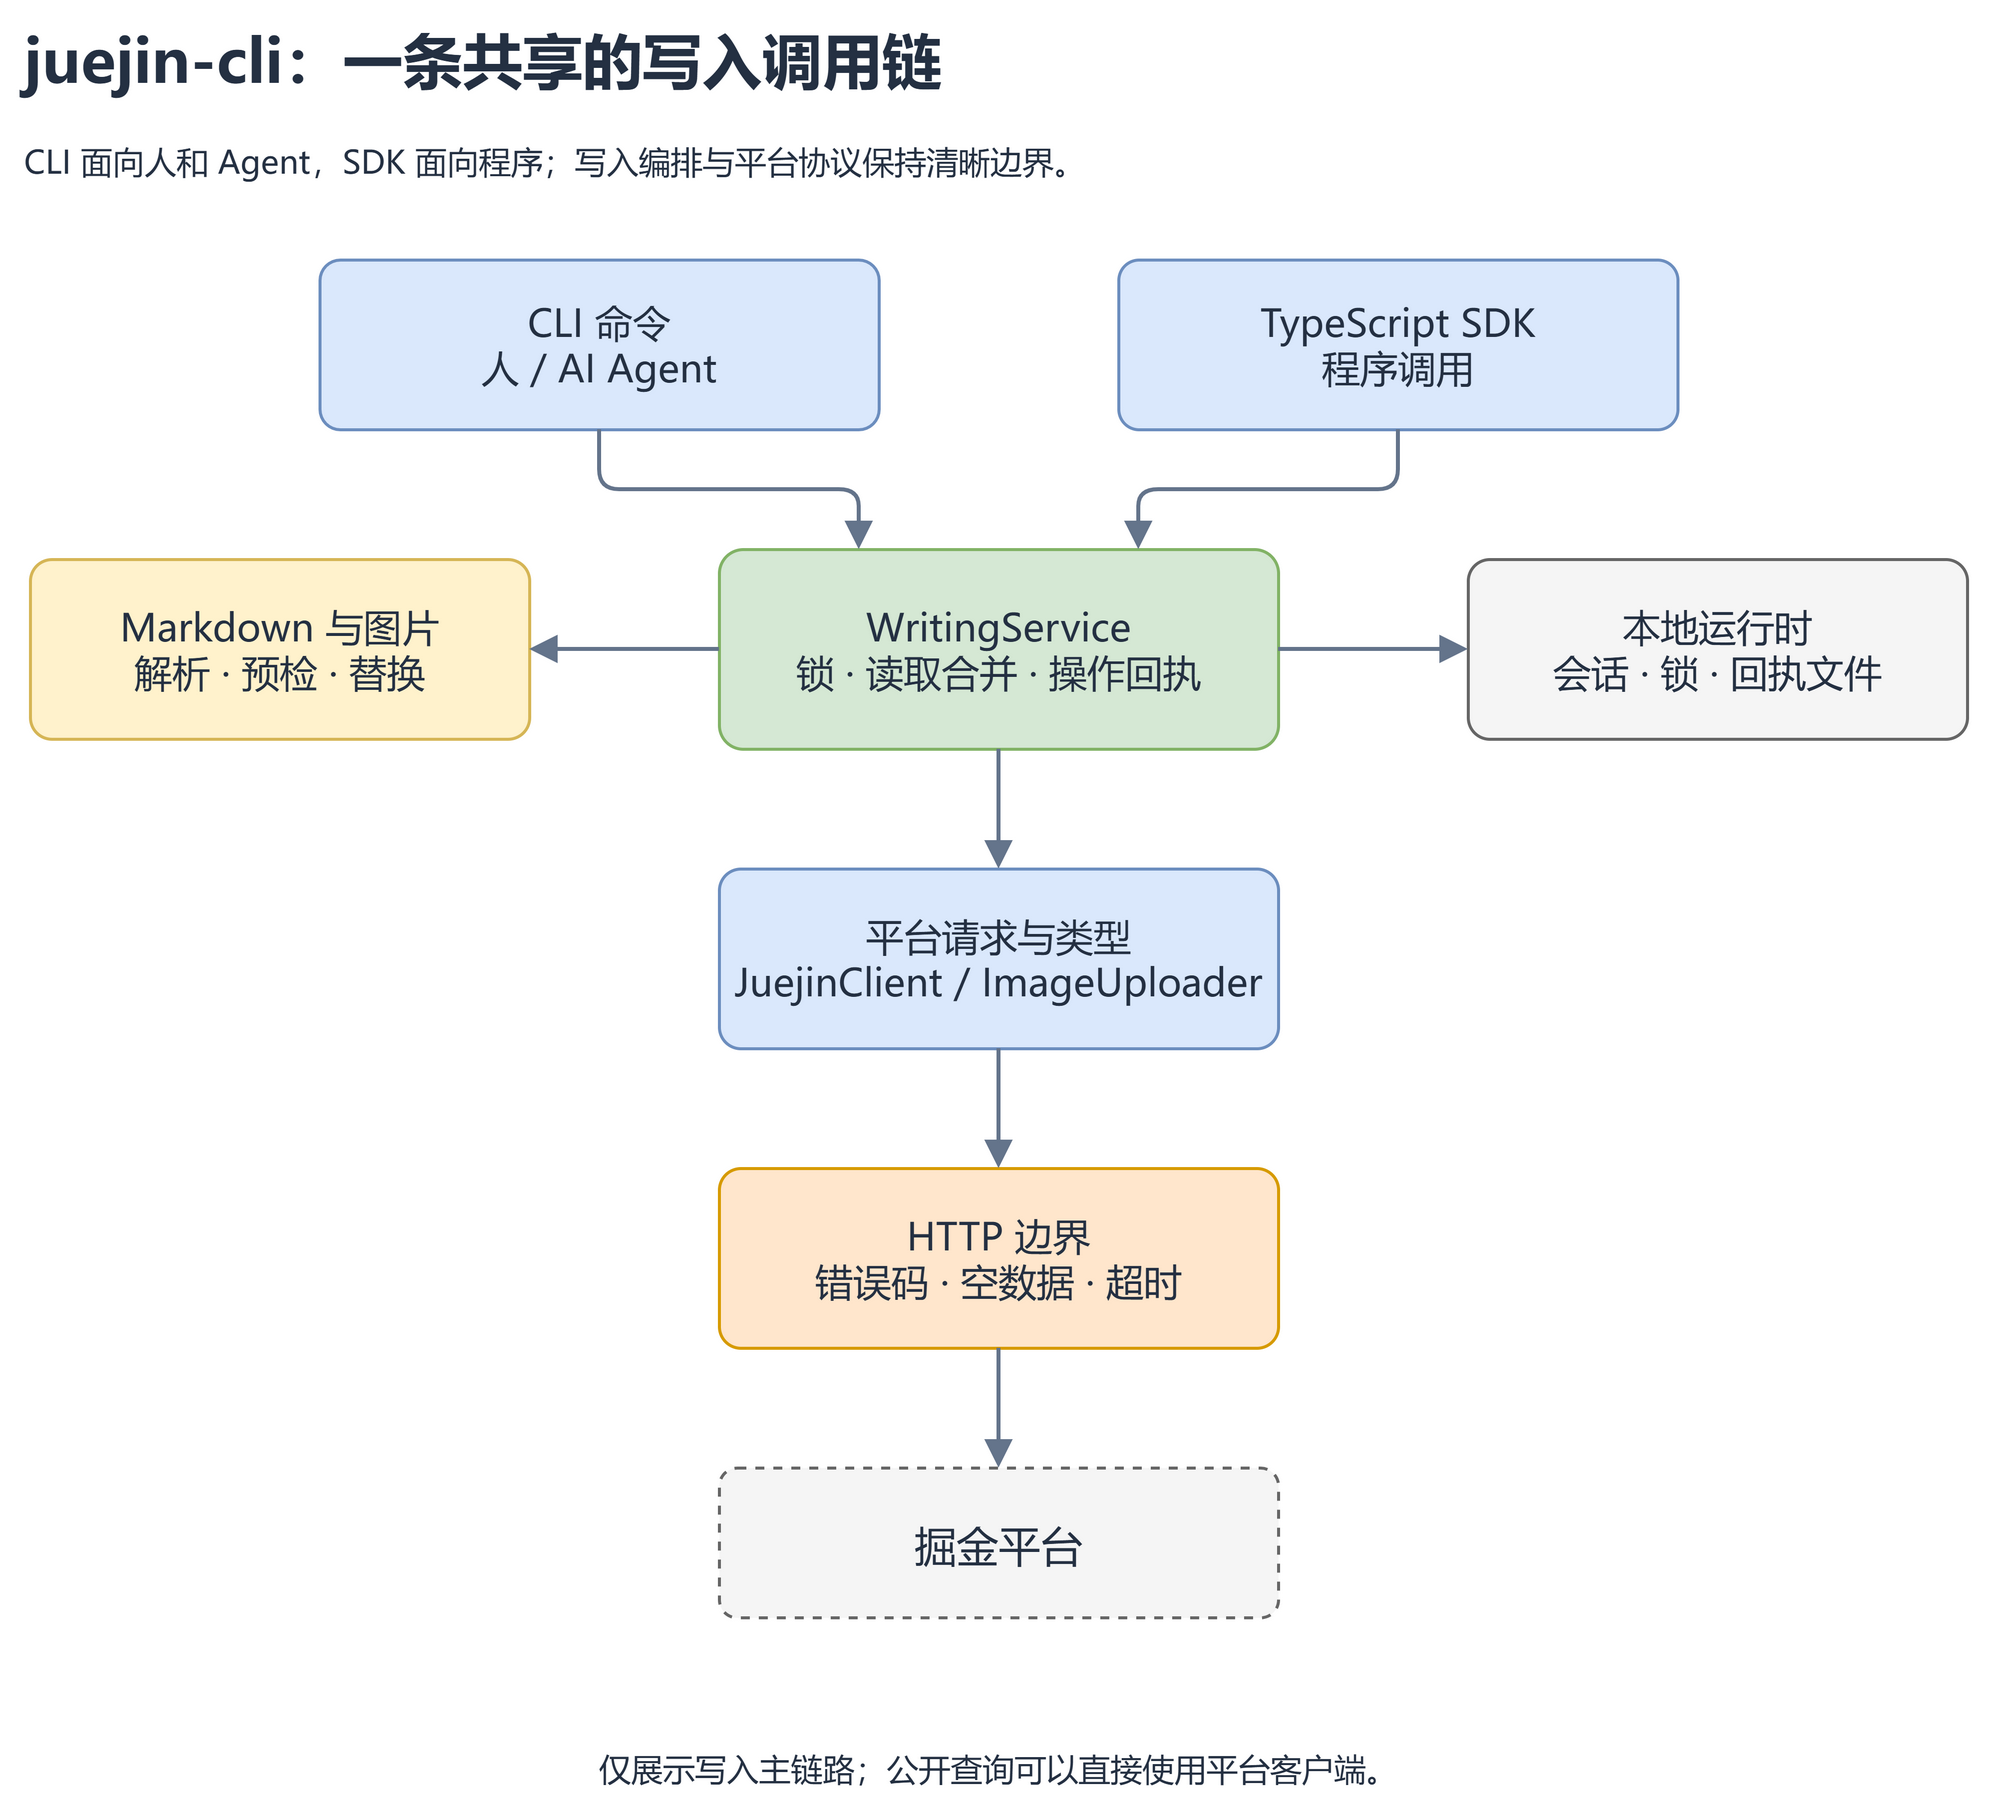
图中 SDK 指供程序直接调用的接口。两种入口共享写入逻辑,避免命令行和程序调用产生不同的业务行为。

三、Markdown 是输入,发布配置也应当可复用

文章文件可以携带 frontmatter,把标题、摘要、分类和标签放在正文旁边:

1---
2title: 我的 TypeScript 实践
3brief: 此处填写五十到一百字的文章摘要,概括问题、方法和结果。
4category: 开发工具
5tags:
6  - "6809640543006490638"
7---
8

上面的摘要只是字段示意,实际内容仍需满足长度要求。标签 ID 用字符串保存;这也避免了 JavaScript 对大整数精度的影响。

本地图片路径相对于文章文件。上传前先检查文件是否存在和格式是否受支持,随后替换上传后的正文引用,原始 Markdown 保持不变。对作者而言,文章和素材仍然可以放在自己的目录或 Git 仓库中管理。

固定信息适合做成模板,但模板不应该替作者编造内容。教程适合按“问题—实现—验证”组织,排障记录适合按“现象—定位—修复”组织;发布配置则优先采用文章已有信息和用户指定的专栏。样式判断需要理解内容,命令行负责忠实执行已经整理好的文件。新版把写作原则与 draw.io 绘图技能一起打包,Agent 可以直接读取本地指南,根据素材决定章节,并把可编辑图源导出为清晰配图。

四、写入超时不等于写入失败

最容易被忽视的情况是:平台已经保存了草稿,但客户端没有收到响应。此时自动重试创建,可能产生第二份草稿;对发布操作也是如此。

juejin-cli 不会在请求异常或超时后自动重放写入。写操作前后记录 operation ID、阶段以及已知的草稿或专栏 ID。后续可以查看回执:

1juejin history --json
2

回执无法消除网络不确定性,却能给恢复过程留下线索。用户或 Agent 应先核对远端状态,再决定是否继续。已经取得的草稿 ID 应当沿用,更新文章时调用 draft update,而不是再创建一份。
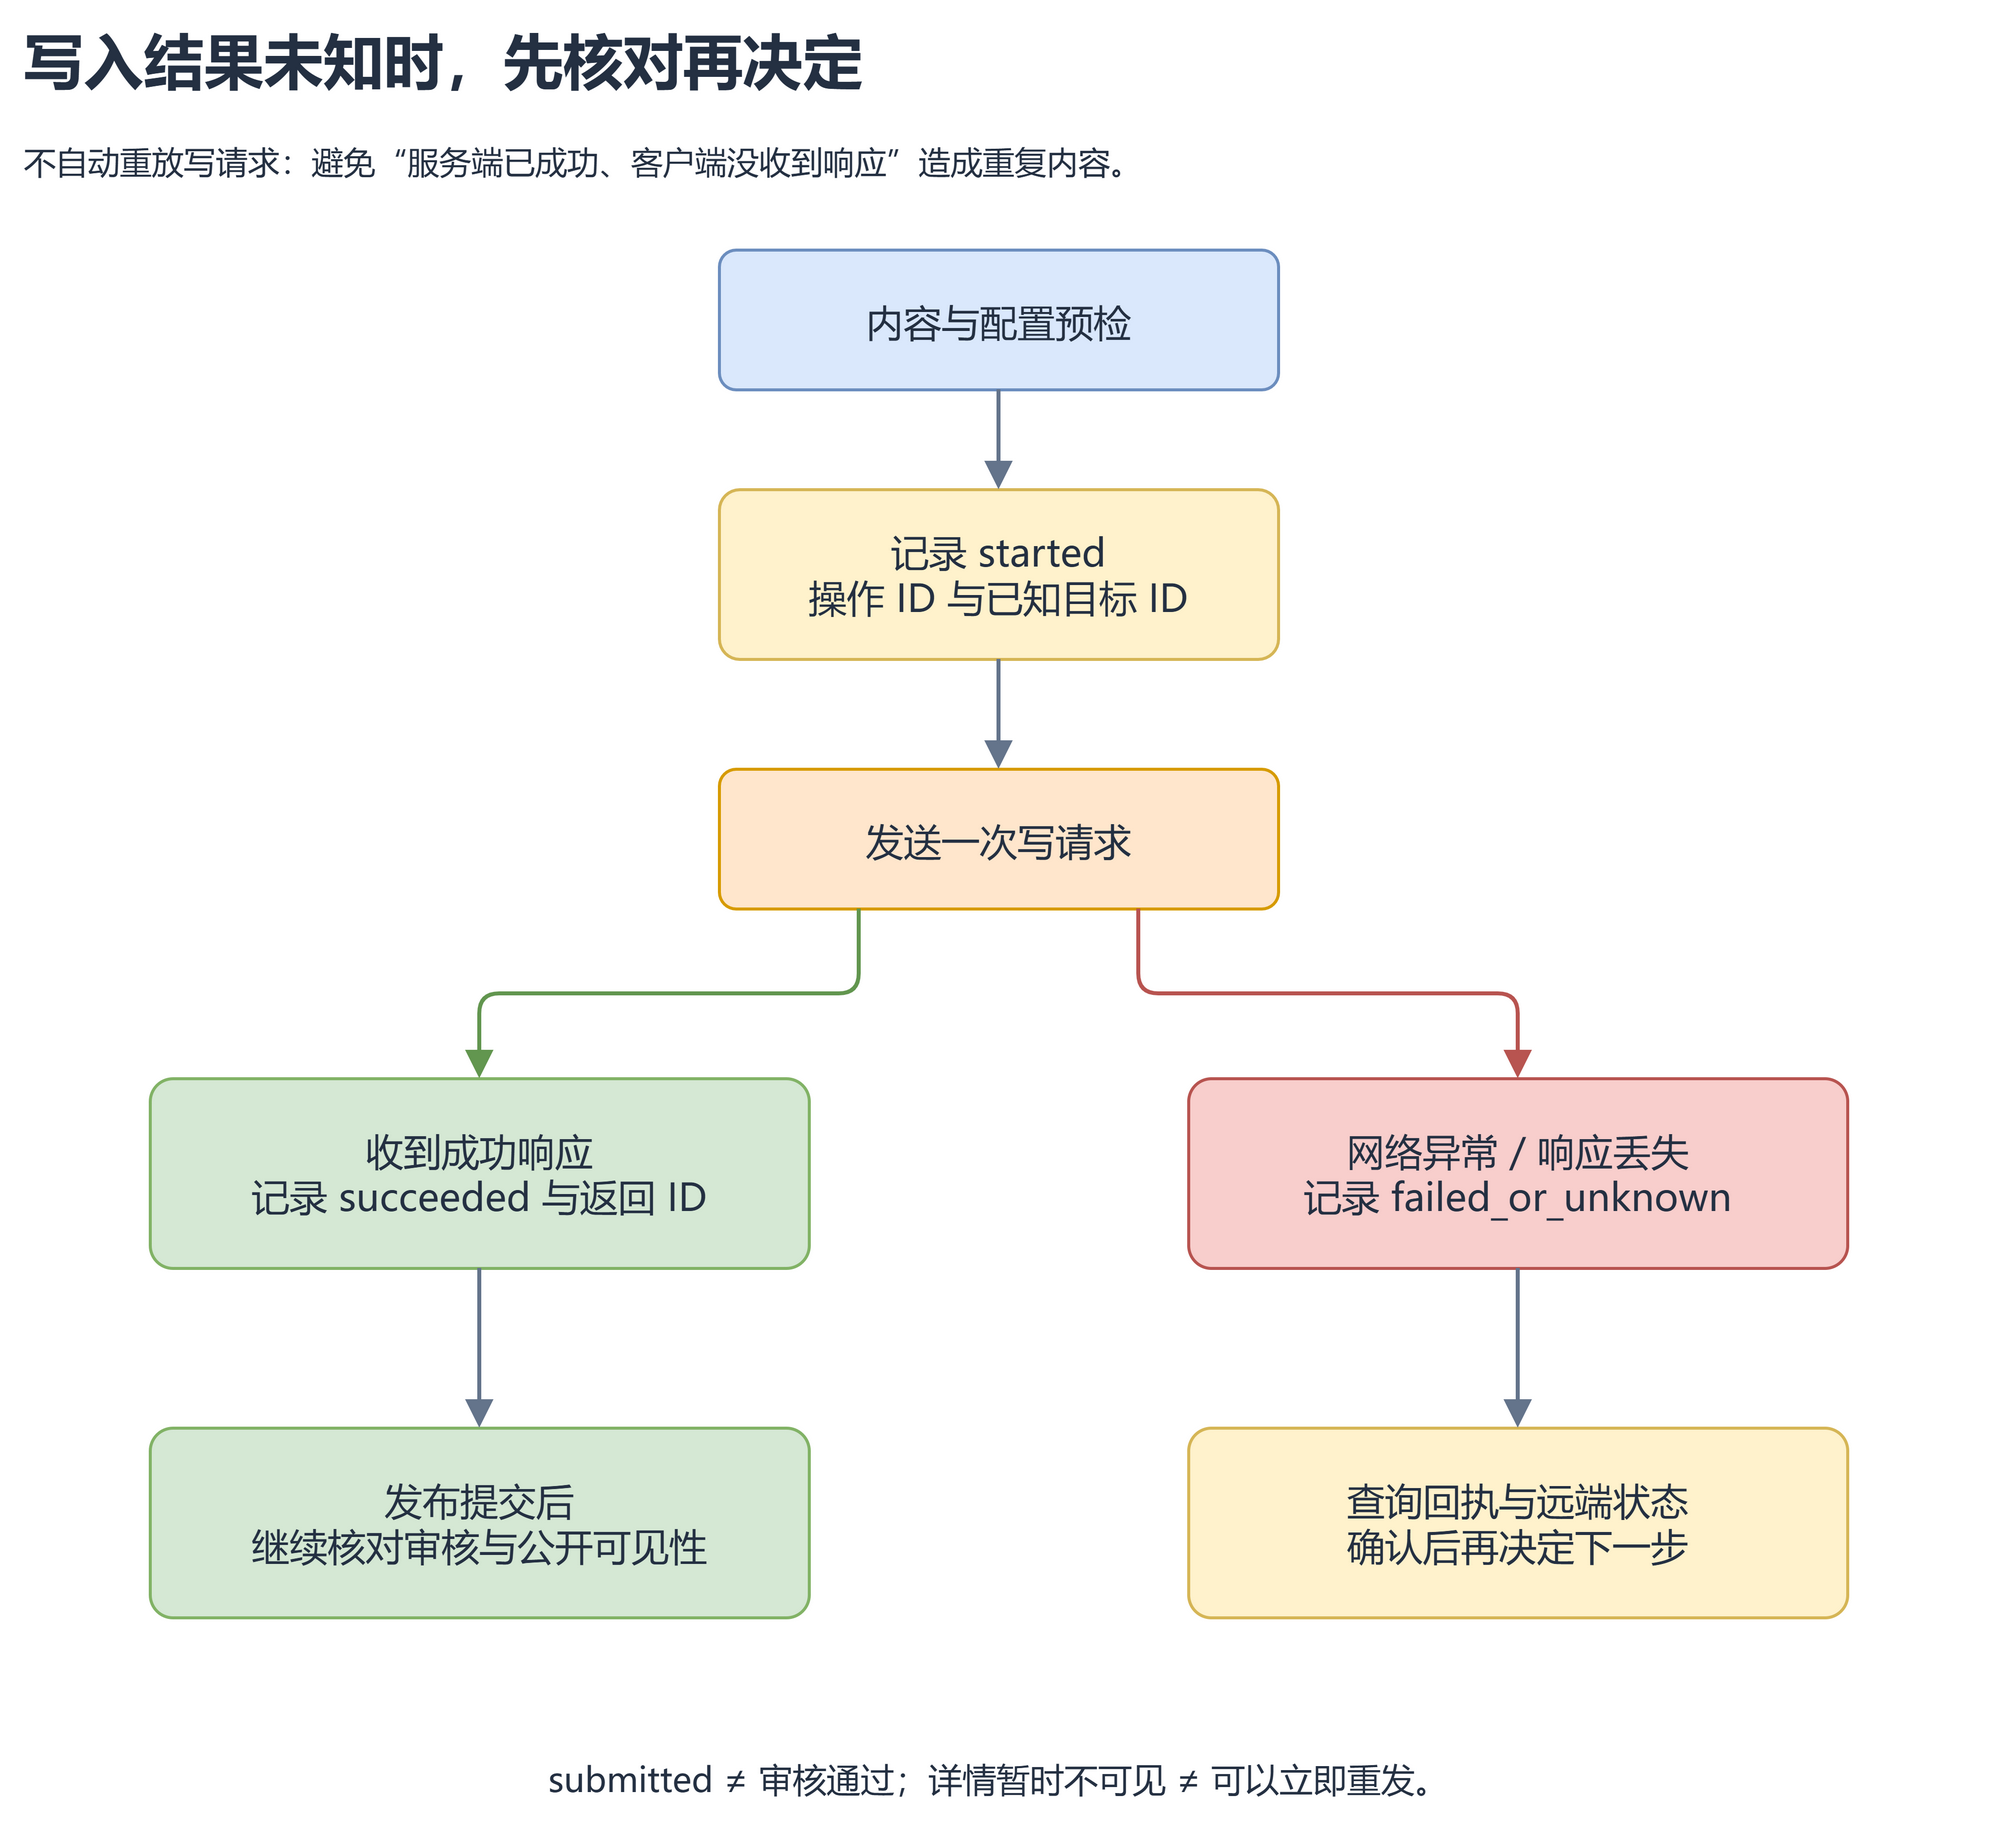
最后这条分支不会自动回到“发送请求”。它保留不确定状态,让恢复过程有依据。

同样,发布结果中的 submitted 只表示平台接受提交。审核或索引尚未完成时,公开详情可能暂时不可见。工具应把这种区别说清楚,避免用户误以为发布失败而重复提交。

五、速度优化首先来自减少不必要的工作

真实测试中发现,草稿准备阶段按名称解析标签,即使找到完全匹配项,原实现仍会继续遍历后续标签页。本轮改进让精确匹配立即结束,同时保留公开标签搜索的完整结果。

另一种更直接的办法是把确认过的标签 ID 写入模板。这样每次保存文章都不必重新搜索名称。它减少的是不必要的读取,并不会改变写请求不自动重试的原则。

对用户来说,等待也需要可理解的反馈。0.2.0 更新在普通模式中增加等待提示,并在提交后说明审核状态。JSON 模式继续保持稳定的单文档结果,方便自动化消费。

六、批量发布需要预检和进度,而不只是循环

本轮增加了一个目录级发布入口:把同一目录中的 Markdown 统一预检,再逐篇发布到指定专栏,保存每篇文章的草稿 ID 和文章 ID。

它的关键约束是:先发现输入错误,再开始写入;已经确认完成的文章可以跳过;上次写入结果未知时,停止自动执行并提示核对回执。否则,一个简单的循环很容易在中断后制造重复内容。

这一批量入口已完成本地验收,将随 0.2.0 发布,0.1.0 不包含此命令。文章中的架构讨论也不意味着所有目标已经实现:例如搜索接口对条数限制的实际行为、审核状态查询和测试内容清理,仍需要继续完善。

七、把“成功”定义在用户真正关心的位置

接口返回成功、草稿保存成功、发布提交成功、读者能看到文章,是不同的结果。验收时需要分别记录,而不是统一归为“通过”。

已有实测覆盖了登录、查询、图片上传、草稿创建和更新、文章提交、专栏创建与更新。一次占位测试文章虽然提交成功,随后却被审核拒绝,促使我们把自动化测试限定在草稿,并给正式发布增加正文预检。一次成功不能证明长期成功率达到 95%;更可信的方法是持续记录具体场景、请求耗时和失败原因,并保留可以复现问题的输入。

juejin-cli 的技术取舍围绕这些具体问题展开:让命令可发现,让输入可预检,让结果可衔接,让失败可恢复。它还在演进,而每一次用它发布真实文章,都会暴露下一处值得改进的细节。

项目源码:Ganzhib/juejin-cli

已发布包:@ganzhibin/juejin-cli


参考文档


《从命令到工作流:juejin-cli 如何让写作自动化更可靠》 是转载文章,点击查看原文。


相关推荐


图解 MyEclipse Deployment Assembly:资源如何进入部署产物?
慧都小项2026/11/3

图解 MyEclipse Deployment Assembly:资源如何进入部署产物? Java Web 项目在 IDE 中没有编译错误,部署后却出现类加载异常,排查时很容易先去调整依赖、复制 JAR 或重启服务器。这些动作有时改变了现象,却未必说明了原因。 更有效的起点,是先回答:编译器看到了什么、部署产物包含什么、服务器实际加载了什么?本文围绕这三个问题,说明 MyEclipse Deployment Assembly 的检查位置,并补充 Maven 项目的验证方法。 1. 适用范围


一次 Skill 评测的复盘:我推翻了一份现成的模型选型结论,然后自己造了个评测平台
冬奇Lab2026/10/26

起因:一份看起来很完整的评测报告 前阵子团队里出了一份「高频 Skill 模型适配评估」,给 Jira Skill 的 8 个任务场景(D1-D8)各选出了一个最佳模型。报告里有表格、有准确率、有 Token 和耗时对比,格式齐整,结论清晰。 我本来是想直接拿来用的。但在准备把它当作选型依据之前,我多看了几眼,越看越不踏实。 这份报告里的核心数据长这样(每个模型 40 次判定): 模型准确率平均 Tok


Linux系统——进程间通信之管道
进击的荆棘2026/10/18

💁‍♂️个人主页:进击的荆棘 👇作者其它专栏: 《数据结构与算法》《算法》《C++起始之路》《Linux》 目录 1.进程间通信介绍 2.管道 3.匿名管道 4.命名管道 5.system V共享内存 6.system V消息队列 7.system V信息量 8.内核是如何组织管理IPC资源的 1.进程间通信介绍 1.1进程间通信的目的 ●数据传输:一个进程需要将它的数据发送给另一个进程 ●资源共享:多个进程间共享同样的资源 ●通知事件:一个进


MySQL进阶篇之日志(上半篇)
bksczm2026/10/17

📚 本文收录于「bksczm」的系列专栏 LinuxC/C++MySQL面试题Redis 一、MySQL 日志体系总览 1.1 为什么需要日志 日志用于记录服务器正在发生的活动,是数据安全、崩溃恢复、主从复制、故障排查的基础。MySQL 中常见的日志有七类: 日志作用所属层redo log事务提交后崩溃恢复,保证持久性(DML 物理修改)InnoDB 引擎层undo log事务回滚 + MVCC 多版本并发控制(旧版本链)InnoDB 引擎层error log记录 mysqld 启动


多 Agent 协作架构:Pipeline 模式——串行流水线设计与实战
七夜zippoe2026/10/8

摘要:当单个 Agent 无法独立完成复杂任务时,多 Agent 协作成为必然选择。在众多协作范式中,Pipeline(串行流水线)模式是最简单、最直观、也最容易踩坑的一种——它把一个大任务拆成多个有先后依赖的子任务,让每个 Agent 只专注一个环节,前一个 Agent 的输出成为后一个 Agent 的输入。本文从第一性原理出发,系统拆解 Pipeline 模式的任务分解、串行编排与中间态传递三大核心问题,对比 LangGraph、LangChain LCEL 与自研轻量编排三种实现路径,并给


Prometheus跨主机监控实战:Node Exporter部署、CPU内存告警与cpolar远程采集
码农阿豪@新空间2026/9/30

Prometheus跨主机监控实战:Node Exporter部署、CPU内存告警与cpolar远程采集 前言 Prometheus 采用定期抓取指标的方式采集目标状态。对 Linux 主机而言,Node Exporter 可以把 CPU、内存、文件系统和网络等指标暴露在 HTTP /metrics 端点。实际运维中,Prometheus 和被监控主机往往分开部署;当两台主机处于同一个可路由网络时,直接配置被监控端 IP 与 9100 端口即可。但如果目标设备位于另一处内网,监控中心不能直接到达


从 0 到 1 手搓 AI 视觉识别平台前端:1,286 路视频、6 大模块、纯 HTML/CSS/JS 实现(附完整思路与代码)
合抱阴阳2026/9/24

摘要:算法能跑通,只完成了 AI 视觉项目的 30%;剩下 70% 是「让人看得懂、用得上」。本文用一个可运行的单文件原型,拆解 AI 视觉识别平台的 6 大核心模块——态势总览、实时预览、事件中心、事件详情与处置、证据档案、检索分析,覆盖 KPI 体系、九宫格预览与检测框叠加、事件处置漏斗、合规化证据归档,以及以文搜图的多模态检索。全文零框架依赖,一个 index.html 双击即开,所有图表用 CSS/SVG 手绘,代码可直接抄进你的项目。 关键词:AI 视觉 · 视频结构化 · 前端


06-并发
前端兰博2026/9/16

一、线程创建 Java中常见创建线程有三种,常见的如下两类 1.1 继承Threa类 public class MyThread extends Thread{ @Override public void run(){ System.out.println("MyThread is running"); } } public static void main(String[] args) { MyThread myThread = new MyT


当 Mac mini 的价格不再 mini -- 肘子的 Swift 周报 #152
东坡肘子2026/9/8

当 Mac mini 的价格不再 mini 上月底,苹果发布了新的 Mac mini 和 Mac Studio。除了强悍的性能更新,明显上涨的价格同样给人带来了不小的震撼。内存与存储成本上涨无疑是本轮涨价的重要原因,但在 AI 时代,开发者对硬件的需求也在悄然发生变化。更大的内存、更高的存储容量,不断推高我们心目中“够用配置”的标准,最终也让实际购买价格变得更加夸张。 过去几个月,开发中最让我头痛的一件事,是 MacBook Pro 风扇持续转动带来的噪音。过去多年的使用中,只有在少数高负载场景


Eino + DeepFlux 实战全景复盘:100 篇,从 5 分钟 Demo 到企业级平台(第100篇-E86)
leeyi2026/8/31

这是第 100 篇,收官篇。不拆新源码——反过来,把 99 篇走过的路和 DeepFlux 这个真实仓库放在一起盘一遍。 (一)100 篇走了哪几步 回头看,系列其实是一条"从外向内、再向外"的路线: 第一季(01-14):从平台往下看。 先拆 DeepFlux 这个企业级平台——DDD 四层、Session 状态机、ReAct 主循环、HITL、SSE 推流、Hook 护栏、多 LLM、RAG、记忆、RLS 多租户、审计、可观测。当时的问题是"企业级 Agent 平台长什么样",答案是 14

首页编辑器站点地图

本站内容在 CC BY-SA 4.0 协议下发布

Copyright © 2026 聚合阅读